01
ApifyOffiziell
4,1 Mio./Monat
SpezialisiertRiesiger Marktplatz mit robusten Web-Scrapern und -Aktoren, erfordert jedoch mehr Konfiguration als die einfache API von Firecrawl.
KI-Web-ScrapingRedaktionswert: 4.6Freemium, Preise auf Anfrage+3,9 %

Firecrawl: Konvertiert Websites sofort in sauberes LLM-fertiges Markdown, bietet jedoch keine Tools zur Verwaltung privater Proxy-IPs. Bright Data verzeichnet 802.752 monatliche Besuche mit -5,9 % Wachstum gegenüber dem Vormonat und einem Preismodell „Kostenlose Testversion, Kostenpflichtig“. Firecrawl verzeichnet 1.828.239 monatliche Besuche mit -1,9 % Wachstum und einem Preismodell „Freemium, Preise auf Anfrage“.

Webdaten-Infrastruktur für Scraping, Proxys und KI-fertige Datensätze
Web-Daten-API, die jede Website in KI-fertige Inhalte verwandelt
| Dimension / Kennzahl | | |
|---|---|---|
| Offizielle Domain | brightdata.com | firecrawl.dev |
| Preismodell | Kostenlose Testversion, Kostenpflichtig | Freemium, Preise auf Anfrage |
| Monatliche Besuche | 802.752 (802.752) | 1,83 Mio. (1.828.239) |
| MoM-Traffic-Delta |
|---|
| -50.403 (-5,9 %) |
| -35.651 (-1,9 %) |
| Primärmarkt und Anteil | 🇺🇸 Vereinigte Staaten (29,5 %) | 🇺🇸 Vereinigte Staaten (31,8 %) |
|---|
| Direkte Besuche / Monat | 383.707 | 740.258 |
|---|
| Nutzerbewertung | 4,6 | 4,7 |
|---|
| Unterstützte Plattformen | Website | Website |
|---|
Webdaten-Infrastruktur für Scraping, Proxys und KI-fertige Datensätze
Unlocker, SERP, Browser und Crawl rufen öffentliche Seiten ab, umgehen Bot-Sperren und CAPTCHAs und liefern JSON, HTML oder Markdown.
Residential-, ISP- und Datacenter-Pools mit Targeting nach Land, Stadt und ASN sowie Management-APIs für Rotation und Sessions.
Strukturierte Endpunkte für bekannte Domains wie LinkedIn, Amazon und soziale Netzwerke, auf Abruf oder nach Zeitplan.
Vorab erhobene Datensätze aus Business, E-Commerce, Social Media und Immobilien filtern und kaufen – mit Milliarden von Datensätzen.
Web-Daten-API, die jede Website in KI-fertige Inhalte verwandelt
Mehrere Endpunkte decken Discovery, Einzelseiten-Extraktion, Website-Crawling und URL-Mapping über eine einzige API ab.
Liefert Markdown, strukturiertes JSON, HTML, Links und Screenshots und entfernt Navigation, Werbung und Footer zur Token-Reduktion.
Nach dem Scraping lassen sich per Prompt oder Code Klicks, Eingaben, Scrollen und Navigation ausführen, um interaktive Inhalte zu erreichen.
Python- und Node-SDKs, REST-API, CLI und MCP-Server verbinden Agenten und IDEs in Minuten.
SpezialisiertRiesiger Marktplatz mit robusten Web-Scrapern und -Aktoren, erfordert jedoch mehr Konfiguration als die einfache API von Firecrawl.

Combines live web search and cloud browsers for agentic automation, but less specialized in clean markdown generation.

Optimiert für semantische Websuche und KI-Agenten-Abruf, aber weniger Fokus auf das Crawlen kompletter Websites in Markdown.
Bietet tiefgehende Rechercheagenten und Websuche-APIs, ist aber weniger auf reine Website-zu-Markdown-Konvertierung ausgerichtet.

Bietet exzellentes URL-zu-Markdown-Dokumentlesen und neuronale Suchendendpoints, aber geringere Tiefe beim Crawlen kompletter Websites.

SpezialisiertCloud-Browser für KI-Agenten, Scraping und Automatisierung, die nicht blockiert werden

Bietet robuste globale Proxys und Scraping-APIs, hat aber ein kleineres Ökosystem vorgefertigter Automatisierungs-Akteure.
Kostenlos / Open SourceNutzt natürlichsprachliche Prompts zur Extraktion mit Open-Source-Flexibilität, ist jedoch weniger für massive Enterprise-Crawling-Vorgänge optimiert.

Affordable web scraping and proxy API with reliable CAPTCHA handling, but fewer advanced enterprise data pipelines.

SpezialisiertHochpräzise API für Dokumentenparsing und strukturierte Extraktion
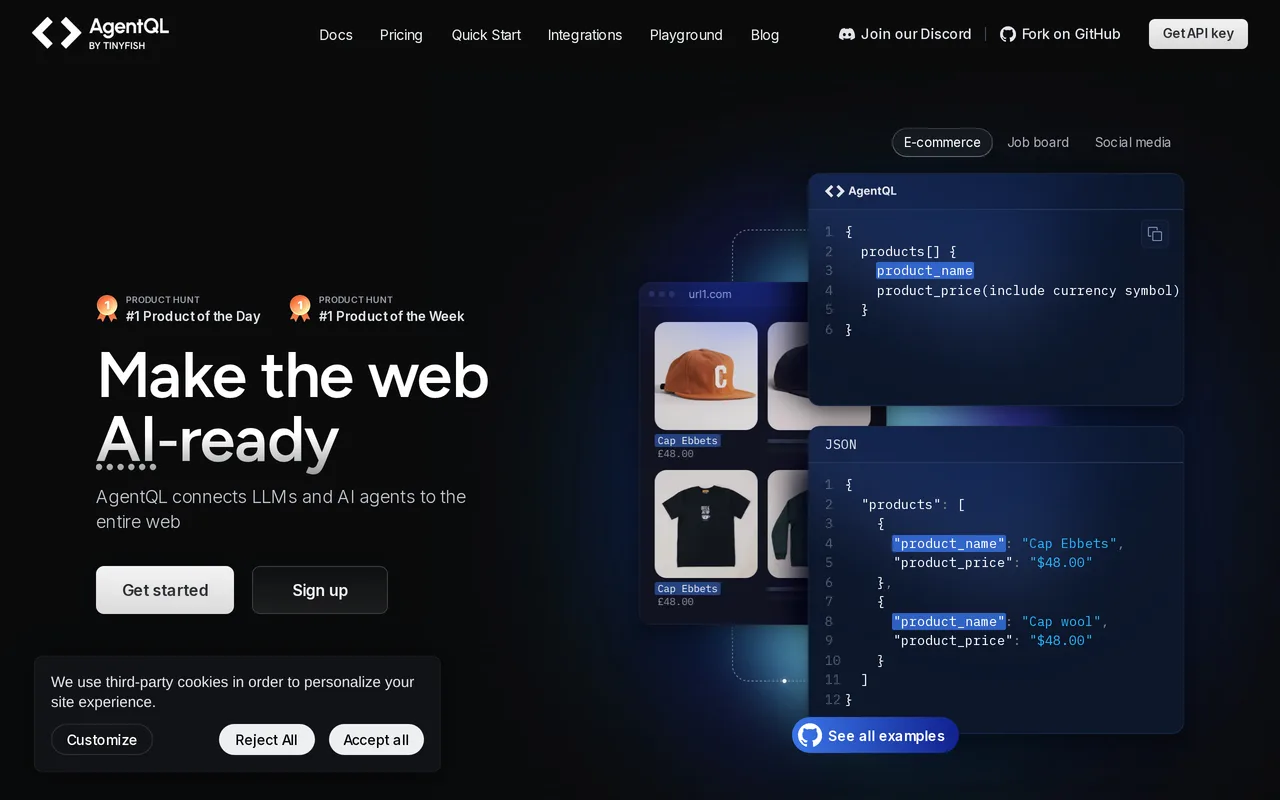
Ein API-Aufruf, um saubere, strukturierte Daten von jeder Website zu extrahieren

SpezialisiertKI-Agenten per natürlicher Sprache mit jeder Website verbinden
SpezialisiertRiesiger Marktplatz mit robusten Web-Scrapern und -Aktoren, erfordert jedoch mehr Konfiguration als die einfache API von Firecrawl.
Bietet tiefgehende Rechercheagenten und Websuche-APIs, ist aber weniger auf reine Website-zu-Markdown-Konvertierung ausgerichtet.
Bietet exzellentes URL-zu-Markdown-Dokumentlesen und neuronale Suchendendpoints, aber geringere Tiefe beim Crawlen kompletter Websites.
SpezialisiertCloud-Browser für KI-Agenten, Scraping und Automatisierung, die nicht blockiert werden
Bietet robuste globale Proxys und Scraping-APIs, hat aber ein kleineres Ökosystem vorgefertigter Automatisierungs-Akteure.
Kostenlos / Open SourceNutzt natürlichsprachliche Prompts zur Extraktion mit Open-Source-Flexibilität, ist jedoch weniger für massive Enterprise-Crawling-Vorgänge optimiert.
Affordable web scraping and proxy API with reliable CAPTCHA handling, but fewer advanced enterprise data pipelines.
SpezialisiertHochpräzise API für Dokumentenparsing und strukturierte Extraktion
Ein API-Aufruf, um saubere, strukturierte Daten von jeder Website zu extrahieren


