Serverlose Cloud-Infrastruktur für KI- und Daten-Workloads
Vergleiche KI-Produkte für 459 Workflows anhand von Traffic-Schätzungen, Funktionen und Alternativen.
“Python Editor” · Bildanalyse·12 Ergebnisse
Neu startenServerlose Cloud-Infrastruktur für KI- und Daten-Workloads
Serverlose Cloud-Infrastruktur für KI- und Daten-Workloads
KI-Seitenleiste und Browser-Agent für Lesen, Schreiben und Recherche

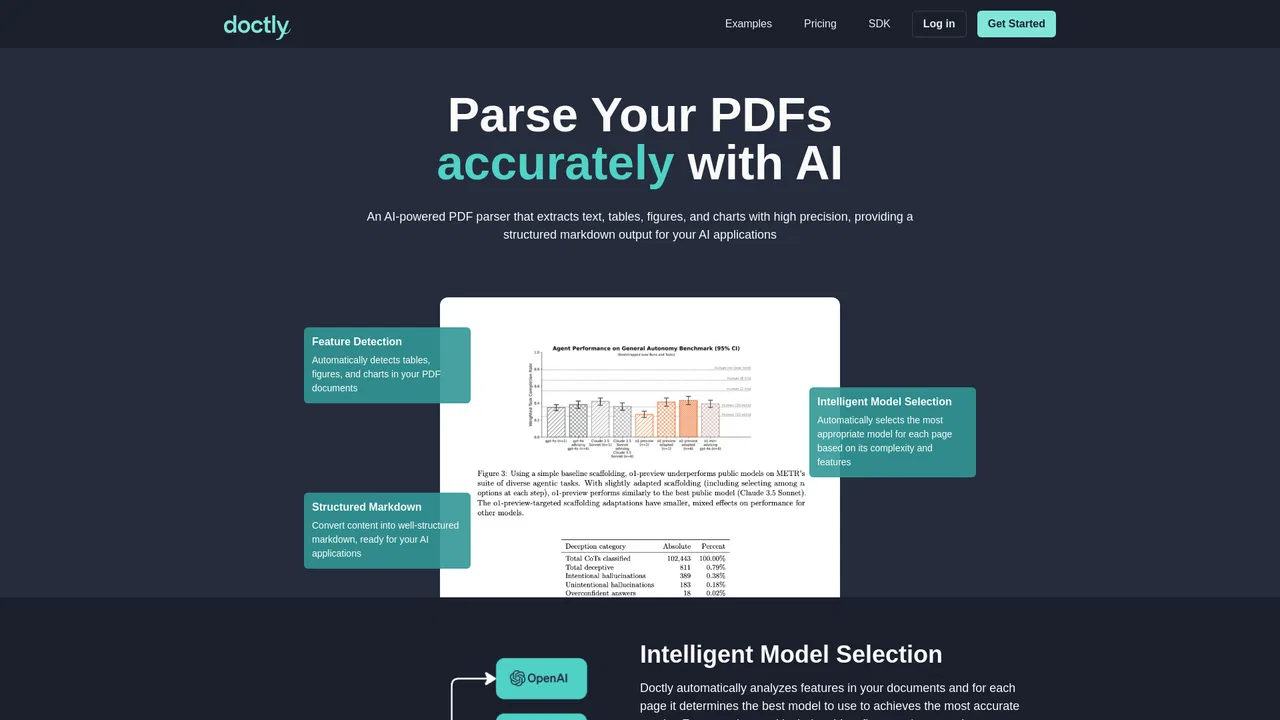
Agentische Dokumentenplattform, die unübersichtliche PDFs in LLM-fähige strukturierte Daten verwandelt
KI-gestützter PDF-Editor für Windows, Mac und iOS
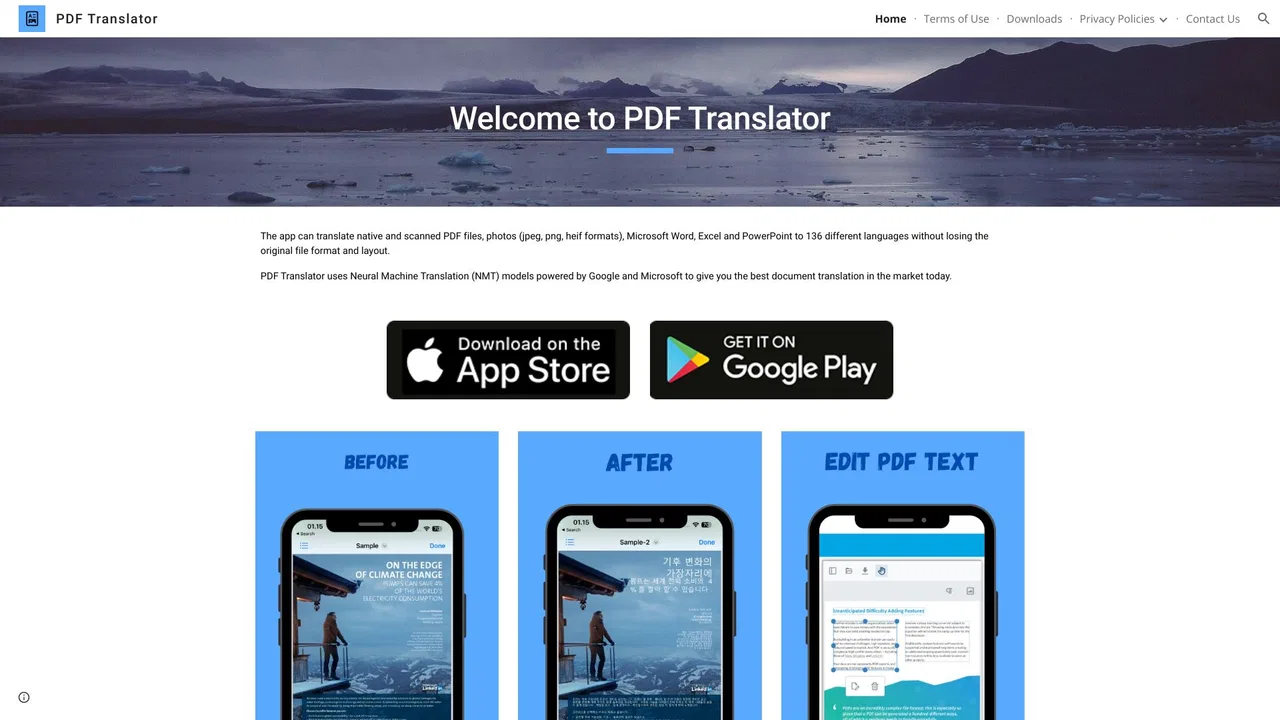
PDFs in über 130 Sprachen übersetzen und bearbeiten, ohne das Layout zu verlieren

Private generative KI, RAG und Agenten direkt in Ihre .NET-Anwendung einbetten
Open-Source-Blickverfolgung nur mit Webcam
PDFs in strukturierte Daten umwandeln, mit Dokumenten chatten und Dokumenten-Workflows automatisieren
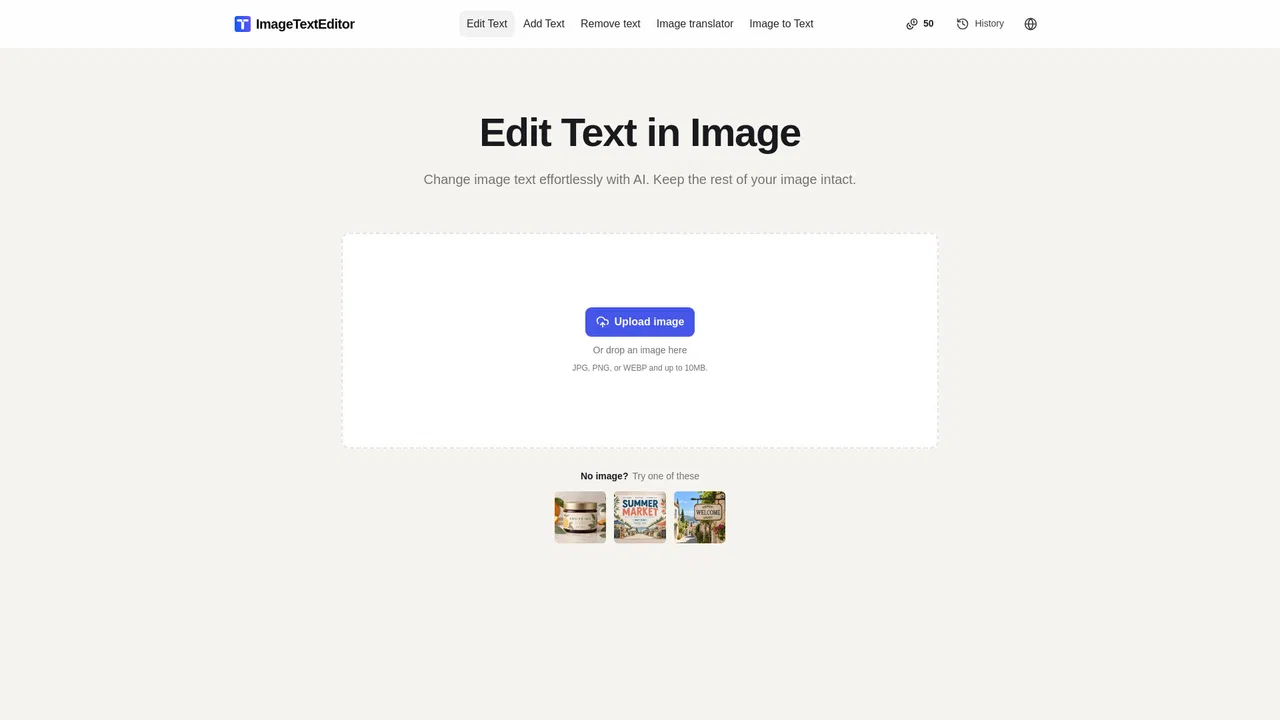
Text in Bildern direkt im Browser bearbeiten, entfernen, extrahieren und übersetzen

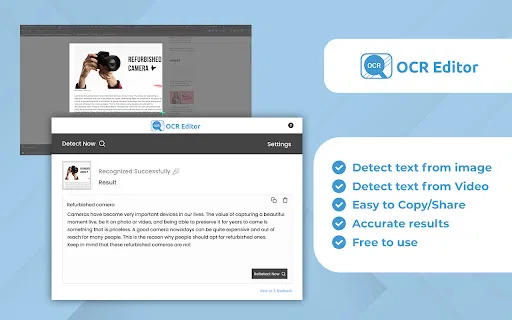
Editierbaren Text aus Bildern, PDFs und Videos direkt in Chrome extrahieren

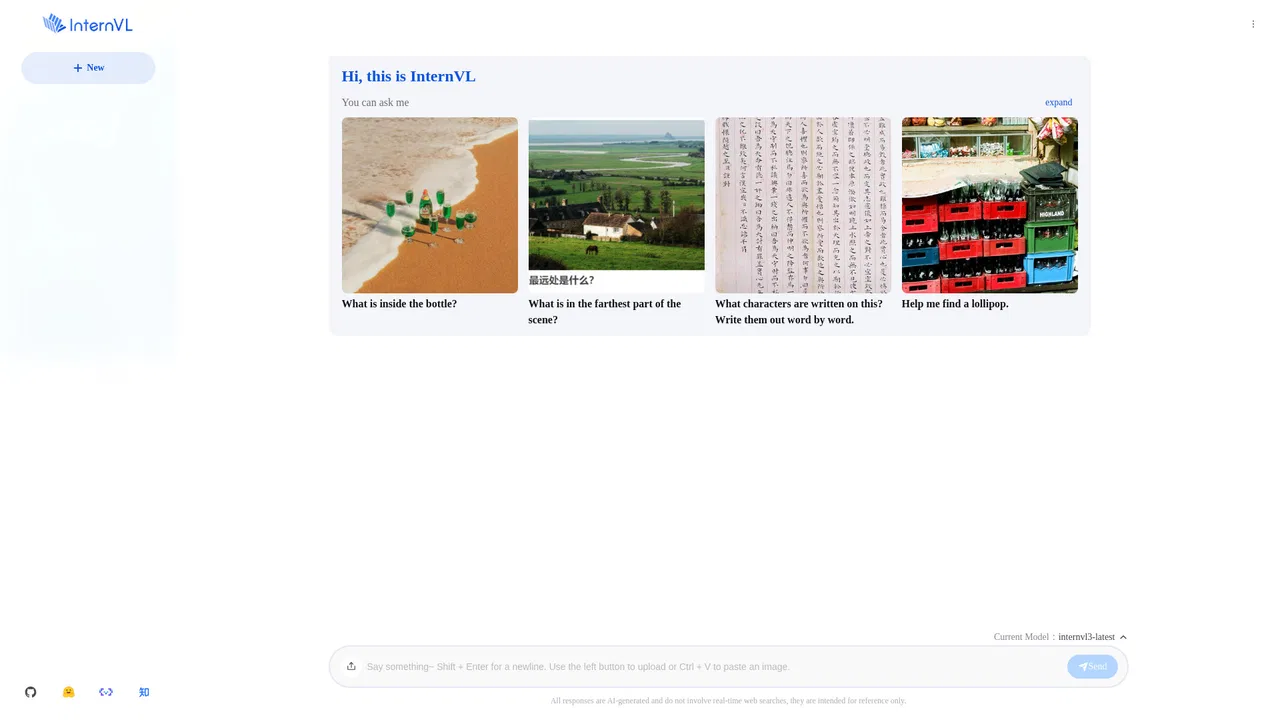
InternVL3 is an open multimodal large language model (MLLM) from OpenGVLab that handles images and text together, spanning visual perception, reasoning, long-context understanding and general text tasks. It is distributed as open weights for research and self-hosting, and can be tried through an official online chat interface.

Ein Side-Panel-KI-Assistent zum Chatten, Bilderlesen und Schreiben mit eigenem API-Schlüssel