



602.966/Monat
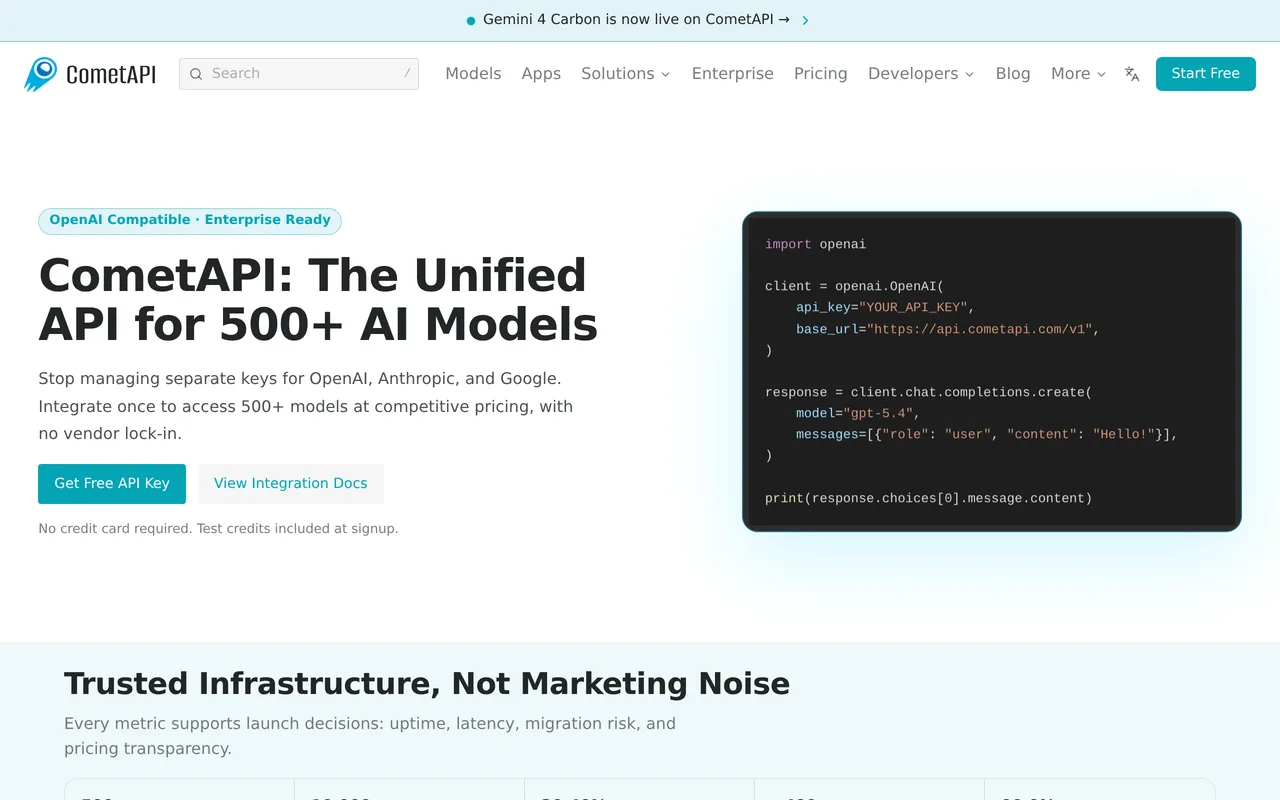
Ein OpenAI-kompatibler API-Schlüssel für über 500 KI-Modelle
KI-EntwicklertoolsRedaktionswert: 4.0Pay-as-you-go (credits)+49,7 %
602.966/Monat+49,7 %
Ein OpenAI-kompatibler API-Schlüssel für über 500 KI-Modelle
Pay-as-you-go (credits)
Vergleiche KI-Produkte für 459 Workflows anhand von Traffic-Schätzungen, Funktionen und Alternativen.
“LLM API”·2.000 Ergebnisse
Neu startenEin OpenAI-kompatibler API-Schlüssel für über 500 KI-Modelle
Ein OpenAI-kompatibler API-Schlüssel für über 500 KI-Modelle

Serverless, dezentrale Inferenz für offene KI-Modelle

Googles multimodaler KI-Assistent und Entwickler-Ökosystem mit Gemini 4 Carbon (Gemini Carbon 4), Gemini 4 Argon, Gemini 3.8 Flash und Gemini 3.1 Pro
Googles multimodaler KI-Assistent und Entwickler-Ökosystem mit Gemini 4 Carbon (Gemini Carbon 4), Gemini 4 Argon, Gemini 3.8 Flash und Gemini 3.1 Pro
Eine OpenAI-kompatible API für über 500 Bild-, Video-, Audio- und LLM-Modelle
Eine OpenAI-kompatible API für über 500 Bild-, Video-, Audio- und LLM-Modelle
Multimodale Basismodelle und KI-native Produkte für Text, Video, Bild, Sprache und Musik
Multimodale Basismodelle und KI-native Produkte für Text, Video, Bild, Sprache und Musik

Eine universelle API für über 500 KI-Modelle und 1.000 Agenten-Tools
KI-Gateway, Observability und Guardrails für LLM-Apps in Produktion
Enterprise-Gateway zu Hunderten KI-Modellen über eine einzige API

OpenAIs Flaggschiff-Assistent mit multimodalen Fähigkeiten, angetrieben von GPT-6 und GPT-5.6 für Reasoning, Coding und Deep Research.
OpenAIs Flaggschiff-Assistent mit multimodalen Fähigkeiten, angetrieben von GPT-6 und GPT-5.6 für Reasoning, Coding und Deep Research.
Eine Memory- und Continual-Learning-Engine, die jedem KI-Agenten dauerhaften Kontext gibt
Eine Memory- und Continual-Learning-Engine, die jedem KI-Agenten dauerhaften Kontext gibt

Ein API-Gateway und LLM-Router für rund 1.000 KI-Modelle
Offene KI-Modelle lokal oder in der Cloud ausführen und entwickeln
Offene KI-Modelle lokal oder in der Cloud ausführen und entwickeln
Eine Cloud für 200+ Modell-APIs, Agent-Sandboxes und GPU-Compute

Eine Suchbasis aus Embeddings, Rerankern und Reader-APIs
Unsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
Unsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.

Eine API für schnelle, kostenkalkulierbare Inferenz von LLMs und multimodalen Modellen
Eine API für schnelle, kostenkalkulierbare Inferenz von LLMs und multimodalen Modellen

Offene Infrastruktur und eine API für Entwickler generativer KI
Offene Infrastruktur und eine API für Entwickler generativer KI
Sprach-KI-Agenten per API entwickeln, testen und produktiv einsetzen
Geteilter GPU-Cluster für offene Modelle zum Pauschaltarif statt pro Token
Geteilter GPU-Cluster für offene Modelle zum Pauschaltarif statt pro Token
Das Open-Source-LLM-Gateway, das Agenten-Anfragen sofort repariert
Fast Apply und agent-optimierte Inferenz für Coding-Agents
Fast Apply und agent-optimierte Inferenz für Coding-Agents
Eine OpenAI-kompatible API für über 190 Text-, Bild-, Video- und Audiomodelle

Eine API für über 10.000 Bild-, Video-, Audio-, 3D- und LLM-Modelle
Pinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.
Pinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.


