01
ApifyOficial
4,1 M/mes
Ejecuta miles de scrapers listos para usar y agentes de IA desde una sola nube
Scraping web con IANota editorial: 4.6Freemium, Precio a consultar+3,9 %

Nimble API registra 0 visitas mensuales con un crecimiento intermensual de — y un modelo de precios De pago. Scrapingdog registra 89.683 visitas mensuales con un crecimiento de -15 % y un modelo de precios Prueba gratuita, De pago.

Nimble API is a web data platform that combines AI-powered extraction with proxy infrastructure. It offers unlocker, crawling and SERP APIs alongside residential, datacenter and mobile proxies, so teams can collect, structure and monitor public web data at scale without building their own scraping stack.

API de web scraping con proxies, navegadores y gestión antibot integrados
| Dimensión / Métrica | | |
|---|---|---|
| Dominio oficial | nimbleapi.io | scrapingdog.com |
| Modelo de precios | De pago | Prueba gratuita, De pago |
| Visitas mensuales | 0 (0) | 89,68 mil (89.683) |
| Variación de tráfico intermensual |
|---|
| 0 (—) |
| -15,89 mil (-15 %) |
| Mercado principal y cuota | 🌐 Global (—) | 🇮🇳 India (26,6 %) |
|---|
| Visitas directas / mes | 0 | 66,34 mil |
|---|
| Valoración de usuarios | 4,3 | 4,3 |
|---|
| Plataformas compatibles | Sitio web | Sitio web |
|---|
Nimble API is a web data platform that combines AI-powered extraction with proxy infrastructure. It offers unlocker, crawling and SERP APIs alongside residential, datacenter and mobile proxies, so teams can collect, structure and monitor public web data at scale without building their own scraping stack.
Automatically parse and structure data from complex, dynamic web pages so downstream systems get clean fields instead of raw markup.
Access residential, datacenter and mobile proxies to route requests reliably and avoid blocks during large collection jobs.
Search, crawl and unlocker endpoints let you gather search results, follow links across sites and reach content behind anti-bot defenses.
Built for ongoing collection pipelines, with the scale and reliability needed for e-commerce, social, real estate and finance datasets.
API de web scraping con proxies, navegadores y gestión antibot integrados
Más de 40 millones de proxies rotativos entre IPs, países y operadores, con renderizado real de Chrome headless para que las páginas dinámicas devuelvan datos completos.
Rotación de huellas, patrones de petición humanos y resolución automática de CAPTCHAs reducen los bloqueos en sitios protegidos sin trabajo de ingeniería extra.
Endpoints específicos para Google SERP, Amazon, Walmart, eBay, YouTube, Google Maps, Google News y más devuelven JSON estructurado y te ahorran escribir parsers.
Enruta peticiones por proxies de países concretos para capturar precios y rankings localizados, y escala de unas pocas peticiones a millones sin cambiar el código.
Ejecuta miles de scrapers listos para usar y agentes de IA desde una sola nube
Gratis / Código abiertoAPI de datos web que convierte cualquier sitio en contenido listo para IA


EspecializadoUna sola clave de API para búsqueda, extracción, navegación y automatización web de agentes
 #3

EspecializadoAPI de búsqueda web y crawler creado para agentes de IA

EspecializadoInfraestructura de datos web para scraping, proxies y datasets listos para IA


Navegadores en la nube para agentes de IA, scraping y automatización que no se bloquean

EspecializadoProxies y API de datos web para scraping y pipelines de IA
Gratis / Código abiertoConvierte cualquier web en JSON estructurado con un prompt, sin selectores

EspecializadoUna sola API que convierte cualquier web en datos JSON listos para agentes

EspecializadoAPIs de scraping, búsqueda y enriquecimiento para agentes de IA
EspecializadoUna llamada a la API para extraer datos limpios y estructurados de cualquier sitio web
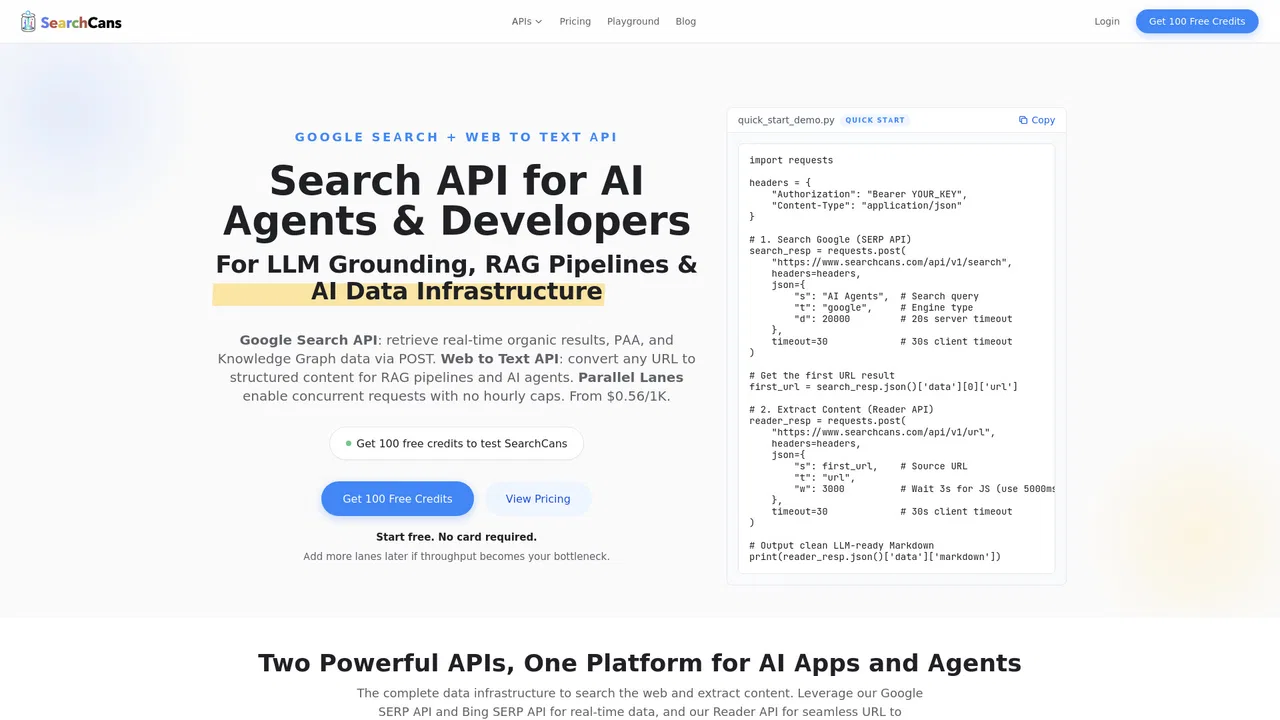
Gratis / Código abiertoSearchCans is an API platform that pairs real-time Google and Bing SERP JSON with a Reader API that converts any page, PDF or Office file into clean Markdown or HTML. It is built for AI agents and RAG pipelines that need live search results plus extracted source text, with parallel lanes instead of hourly rate caps.
Ejecuta miles de scrapers listos para usar y agentes de IA desde una sola nube
Gratis / Código abiertoAPI de datos web que convierte cualquier sitio en contenido listo para IA
EspecializadoInfraestructura de datos web para scraping, proxies y datasets listos para IA
Navegadores en la nube para agentes de IA, scraping y automatización que no se bloquean
EspecializadoProxies y API de datos web para scraping y pipelines de IA
Gratis / Código abiertoConvierte cualquier web en JSON estructurado con un prompt, sin selectores
EspecializadoAPIs de scraping, búsqueda y enriquecimiento para agentes de IA
EspecializadoUna llamada a la API para extraer datos limpios y estructurados de cualquier sitio web
Gratis / Código abiertoSearchCans is an API platform that pairs real-time Google and Bing SERP JSON with a Reader API that converts any page, PDF or Office file into clean Markdown or HTML. It is built for AI agents and RAG pipelines that need live search results plus extracted source text, with parallel lanes instead of hourly rate caps.