01
ExaOficial
1,1 M/mes
EspecializadoAPI de búsqueda web y crawler creado para agentes de IA
AI APINota editorial: 4.5Freemium, Precio a consultar+16,8 %
Qdrant registra 72.992 visitas mensuales con un crecimiento intermensual de -38,4 % y un modelo de precios Freemium, Precio a consultar. Shaped registra 11.871 visitas mensuales con un crecimiento de -39,2 % y un modelo de precios Precio a consultar.
Qdrant is an open-source vector search engine and database, written in Rust, for high-performance similarity search in AI applications.

El motor de relevancia con bucle de retroalimentación
| Dimensión / Métrica | | |
|---|---|---|
| Dominio oficial | qdrant.io | shaped.ai |
| Modelo de precios | Freemium, Precio a consultar | Precio a consultar |
| Visitas mensuales | 72,99 mil (72.992) | 11,87 mil (11.871) |
| Variación de tráfico intermensual | -45,42 mil (-38,4 %) | -7,65 mil (-39,2 %) |
| Mercado principal y cuota | 🇮🇳 India (46 %) | 🇺🇸 Estados Unidos (36,4 %) |
| Visitas directas / mes | 43,79 mil | 4,73 mil |
| Valoración de usuarios | 4,6 | 4,8 |
| Plataformas compatibles | Sitio web | Sitio web |
Qdrant is an open-source vector search engine and database, written in Rust, for high-performance similarity search in AI applications.
Built entirely in Rust with SIMD and a custom Gridstore storage engine for fast, scalable vector search.
Combine dense and sparse vectors in one query, supporting BM25, SPLADE++ and miniCOIL for keyword-plus-vector retrieval.
Store metadata as JSON and apply advanced filters such as nested, text, geo and has_vector, with filters applied during HNSW traversal.
Asymmetric, scalar and binary quantization reduce memory usage by up to 64x while preserving search quality.
El motor de relevancia con bucle de retroalimentación
Recupera, filtra, puntúa y reordena a través de búsqueda semántica, búsqueda por palabras clave y modelos de comportamiento en una sola consulta tipo SQL.
Combina recuperación semántica y por palabras clave, y reordena los resultados según el clic previsto y la interacción de cada usuario.
Los modelos de ML se reentrenan con señales de interacción en vivo, de modo que la calidad del ranking mejora automáticamente con el tráfico.
Ingiere datos directamente de almacenes, herramientas analíticas y pipelines de eventos como Snowflake, Kafka, BigQuery y Shopify, sin ETL.
EspecializadoAPI de búsqueda web y crawler creado para agentes de IA
EspecializadoPlataforma de búsqueda y recuperación con IA para apps y comercio
EspecializadoPlataforma de búsqueda y recuperación con IA para apps y comercio
EspecializadoPinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.
EspecializadoPinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.

Una base de búsqueda construida con embeddings, rerankers y APIs de lectura
Una base de búsqueda construida con embeddings, rerankers y APIs de lectura
EspecializadoUn motor de memoria y aprendizaje continuo que da contexto persistente a cualquier agente de IA
EspecializadoUn motor de memoria y aprendizaje continuo que da contexto persistente a cualquier agente de IA
Gratis / Código abiertoMotor de búsqueda ultrarrápido, autoalojado o en la nube
Gratis / Código abiertoMotor de búsqueda ultrarrápido, autoalojado o en la nube

Zilliz is the company behind Milvus, the open-source vector database, and offers Zilliz Cloud — a fully managed vector database service built for large-scale AI retrieval, RAG, and similarity search workloads.
Zilliz is the company behind Milvus, the open-source vector database, and offers Zilliz Cloud — a fully managed vector database service built for large-scale AI retrieval, RAG, and similarity search workloads.
Gratis / Código abiertoBase de datos de grafos sobre almacenamiento de objetos para la memoria de agentes
Gratis / Código abiertoBase de datos de grafos sobre almacenamiento de objetos para la memoria de agentes
EspecializadoBase de datos vectorial nativa de SQL para aplicaciones GenAI de producción
EspecializadoBase de datos vectorial nativa de SQL para aplicaciones GenAI de producción

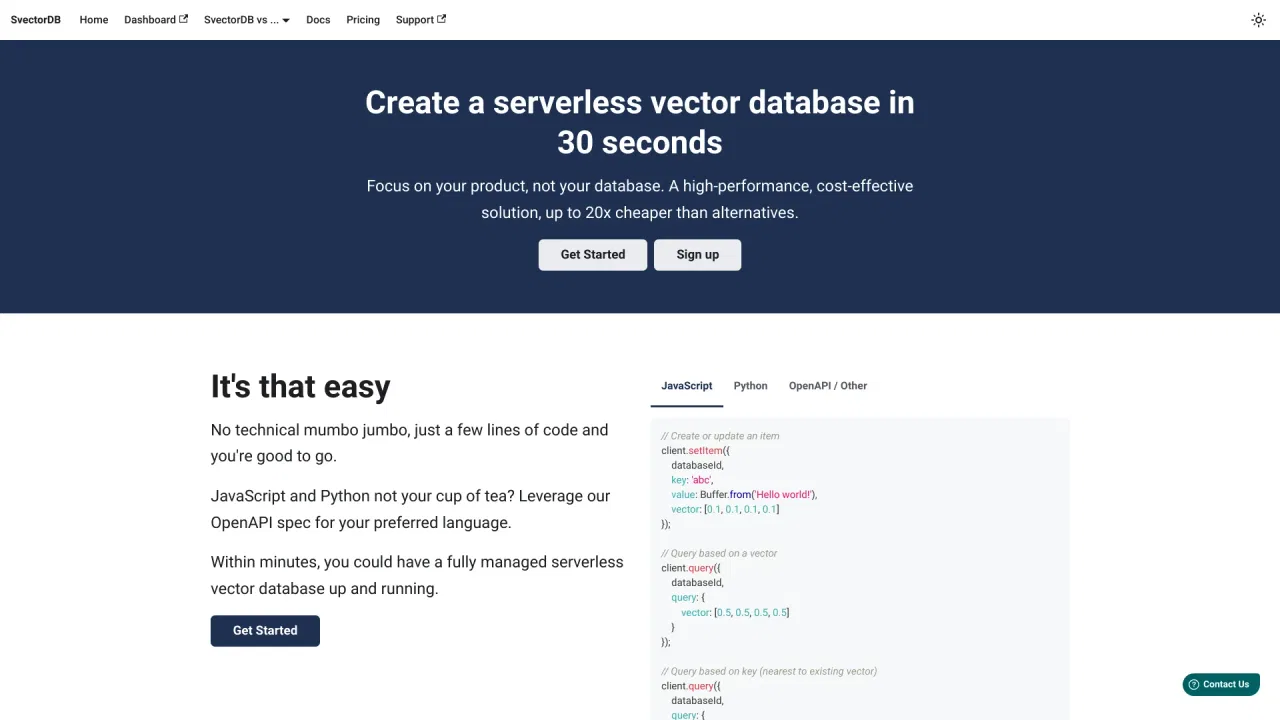
SvectorDB is a natively serverless vector database designed around AWS. It offers pay-per-request pricing, hybrid key-value filtering, built-in text and image vectorizers, and CloudFormation support, making it cheap and simple to add semantic search or recommendations to an existing cloud stack.
SvectorDB is a natively serverless vector database designed around AWS. It offers pay-per-request pricing, hybrid key-value filtering, built-in text and image vectorizers, and CloudFormation support, making it cheap and simple to add semantic search or recommendations to an existing cloud stack.
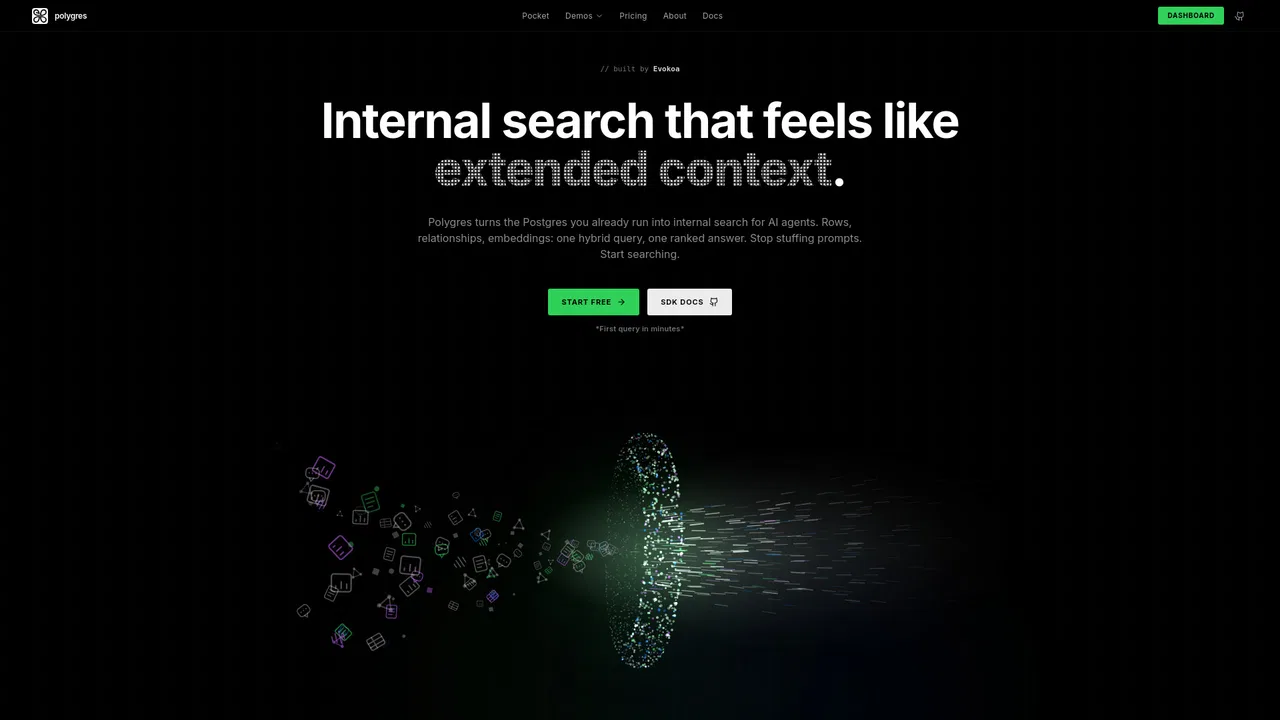
EspecializadoRecuperación de grafos, vectores y texto para agentes de IA en tu Postgres
EspecializadoRecuperación de grafos, vectores y texto para agentes de IA en tu Postgres

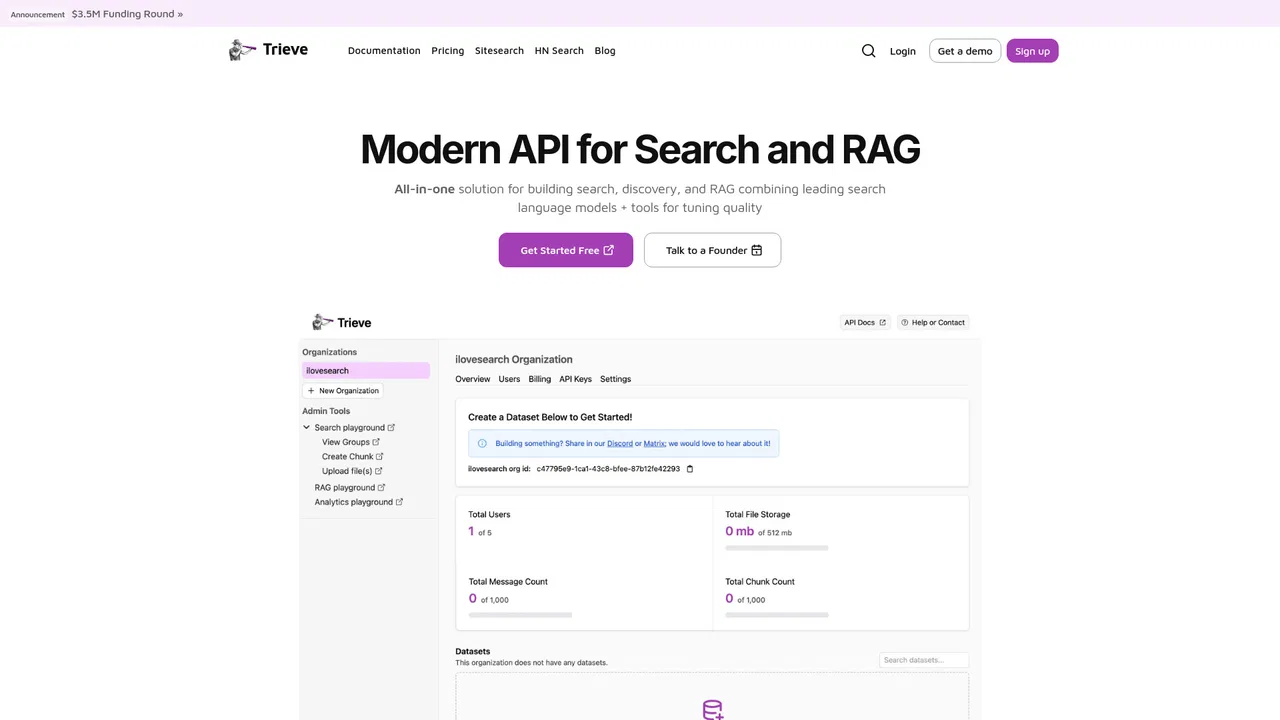
Gratis / Código abiertoTrieve is an AI search and discovery platform and open API for building RAG applications. It combines hybrid search, chunk management, conversational AI and relevance analytics in one system, and can be used as a managed service or self-hosted.
Gratis / Código abiertoTrieve is an AI search and discovery platform and open API for building RAG applications. It combines hybrid search, chunk management, conversational AI and relevance analytics in one system, and can be used as a managed service or self-hosted.