01
ApifyOficial
4,1 M/mes
Amplia plataforma en nube que aloja extractores, rastreadores y actores de automatización preconfigurados para la extracción de datos.
Scraping web con IANota editorial: 4.6Freemium, Precio a consultar+3,9 %

Scrapingdog: API de web scraping alojada que ofrece proxies confiables, renderizado de navegador y endpoints de extracción de datos dedicados. Scrapingdog registra 89.683 visitas mensuales con un crecimiento intermensual de -15 % y un modelo de precios Prueba gratuita, De pago. Thor Data registra 181.966 visitas mensuales con un crecimiento de -3,5 % y un modelo de precios Prueba gratuita, De pago.

API de web scraping con proxies, navegadores y gestión antibot integrados

Proxies y API de datos web para scraping y pipelines de IA
| Dimensión / Métrica | | |
|---|---|---|
| Dominio oficial | scrapingdog.com | thordata.com |
| Modelo de precios | Prueba gratuita, De pago | Prueba gratuita, De pago |
| Visitas mensuales | 89,68 mil (89.683) | 181,97 mil (181.966) |
| Variación de tráfico intermensual | -15,89 mil (-15 %) | -6,55 mil (-3,5 %) |
|---|
| Mercado principal y cuota | 🇮🇳 India (26,6 %) | 🇵🇱 Polonia (8,8 %) |
|---|
| Visitas directas / mes | 66,34 mil | 70,44 mil |
|---|
| Valoración de usuarios | 4,3 | 4,3 |
|---|
| Plataformas compatibles | Sitio web | Sitio web |
|---|
API de web scraping con proxies, navegadores y gestión antibot integrados
Más de 40 millones de proxies rotativos entre IPs, países y operadores, con renderizado real de Chrome headless para que las páginas dinámicas devuelvan datos completos.
Rotación de huellas, patrones de petición humanos y resolución automática de CAPTCHAs reducen los bloqueos en sitios protegidos sin trabajo de ingeniería extra.
Endpoints específicos para Google SERP, Amazon, Walmart, eBay, YouTube, Google Maps, Google News y más devuelven JSON estructurado y te ahorran escribir parsers.
Enruta peticiones por proxies de países concretos para capturar precios y rankings localizados, y escala de unas pocas peticiones a millones sin cambiar el código.
Proxies y API de datos web para scraping y pipelines de IA
Accede a más de 100 M de IP reales rotativas en más de 190 países desde 0,65 $/GB, con rotación y sesiones sticky.
Usa IP móviles reales 4G/5G para objetivos móviles y difíciles de acceder con diversidad de operador.
Obtén resultados precisos en tiempo real de Google, Bing y más, desde 0,70 $ por 1.000 respuestas.
Despliega más de 120 scrapers predefinidos, un Scraping Browser sigiloso y desbloqueo web a escala.
Amplia plataforma en nube que aloja extractores, rastreadores y actores de automatización preconfigurados para la extracción de datos.
Gratis / Código abiertoAPI de extracción orientada a desarrolladores que rastrea y convierte sitios web en markdown o JSON limpios y listos para LLM.


Developer API platform providing live web search, content fetching, cloud browsers, and agentic web automation.

EspecializadoAPI de búsqueda y rastreo web diseñada específicamente para agentes de IA e integración de aplicaciones LLM.

Potente infraestructura integral de datos web que ofrece extensas redes de proxy y API de extracción avanzadas.

EspecializadoInfraestructura de búsqueda que ofrece lectores de documentos de URL a Markdown, embeddings neuronales y endpoints de búsqueda web.

EspecializadoManaged cloud headless browser platform supplying HTTP and WebSocket APIs for web automation.
Gratis / Código abiertoWeb scraping API that extracts structured JSON using natural language prompts instead of CSS selectors.

EspecializadoUna sola API que convierte cualquier web en datos JSON listos para agentes
Unified web data API offering robust web scraping, search, and data enrichment capabilities.
EspecializadoUna llamada a la API para extraer datos limpios y estructurados de cualquier sitio web

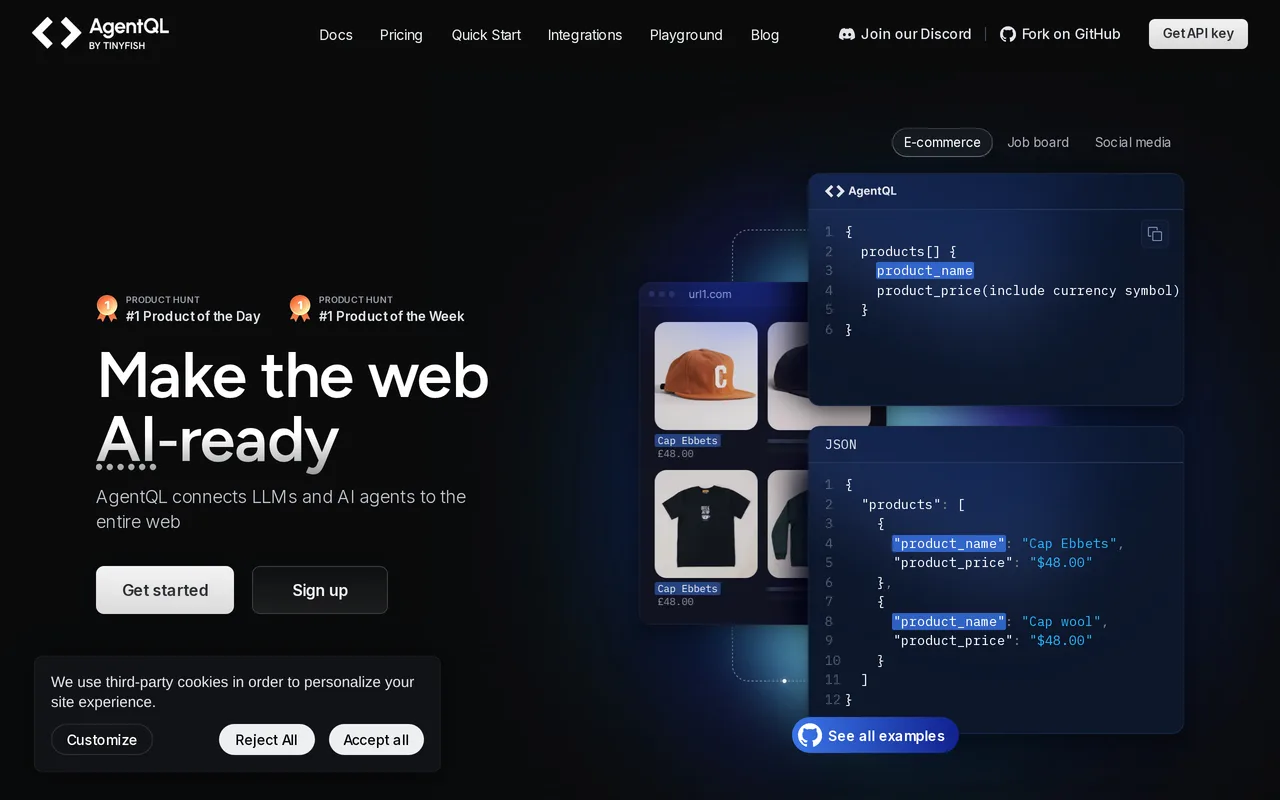
EspecializadoDeveloper toolkit enabling AI agents to extract web data and interact with websites using natural language.
Amplia plataforma en nube que aloja extractores, rastreadores y actores de automatización preconfigurados para la extracción de datos.
Gratis / Código abiertoAPI de extracción orientada a desarrolladores que rastrea y convierte sitios web en markdown o JSON limpios y listos para LLM.
Potente infraestructura integral de datos web que ofrece extensas redes de proxy y API de extracción avanzadas.
EspecializadoInfraestructura de búsqueda que ofrece lectores de documentos de URL a Markdown, embeddings neuronales y endpoints de búsqueda web.
EspecializadoManaged cloud headless browser platform supplying HTTP and WebSocket APIs for web automation.
Gratis / Código abiertoWeb scraping API that extracts structured JSON using natural language prompts instead of CSS selectors.
Unified web data API offering robust web scraping, search, and data enrichment capabilities.
EspecializadoUna llamada a la API para extraer datos limpios y estructurados de cualquier sitio web


