01
370.5万/月
市場調査向けの大きな消費者パネルですが、学術研究やAIチューニングに特化したProleficのような強みはありません。
AIリサーチツール編集部スコア:4.1料金は要問い合わせ+6.6%
Enterpret は月間 51,665 訪問、前月比成長率 -14.1%、料金体系料金は要問い合わせを記録しています。Prolific は月間 18,697,671 訪問、成長率 -1.8%、料金体系有料を記録しています。
AIの学習・評価・研究のための高品質なヒューマンデータ基盤
| 項目 / 指標 |  | |
|---|---|---|
| 公式ドメイン | enterpret.com | prolific.com |
| 料金モデル | 料金は要問い合わせ | 有料 |
| 月間訪問数 | 5.17万 (51,665) | 1869.77万 (18,697,671) |
| 前月比トラフィック増減 | -8472 (-14.1%) |
| -35.2万 (-1.8%) |
| 主要市場とシェア | 🇮🇳 インド (50.4%) | 🇺🇸 アメリカ合衆国 (48.8%) |
|---|
| 月間ダイレクト訪問数 | 4.12万 | 1297.97万 |
|---|
| ユーザー評価 | 4.3 | 4.6 |
|---|
| 対応プラットフォーム | ウェブサイト | ウェブサイト |
|---|
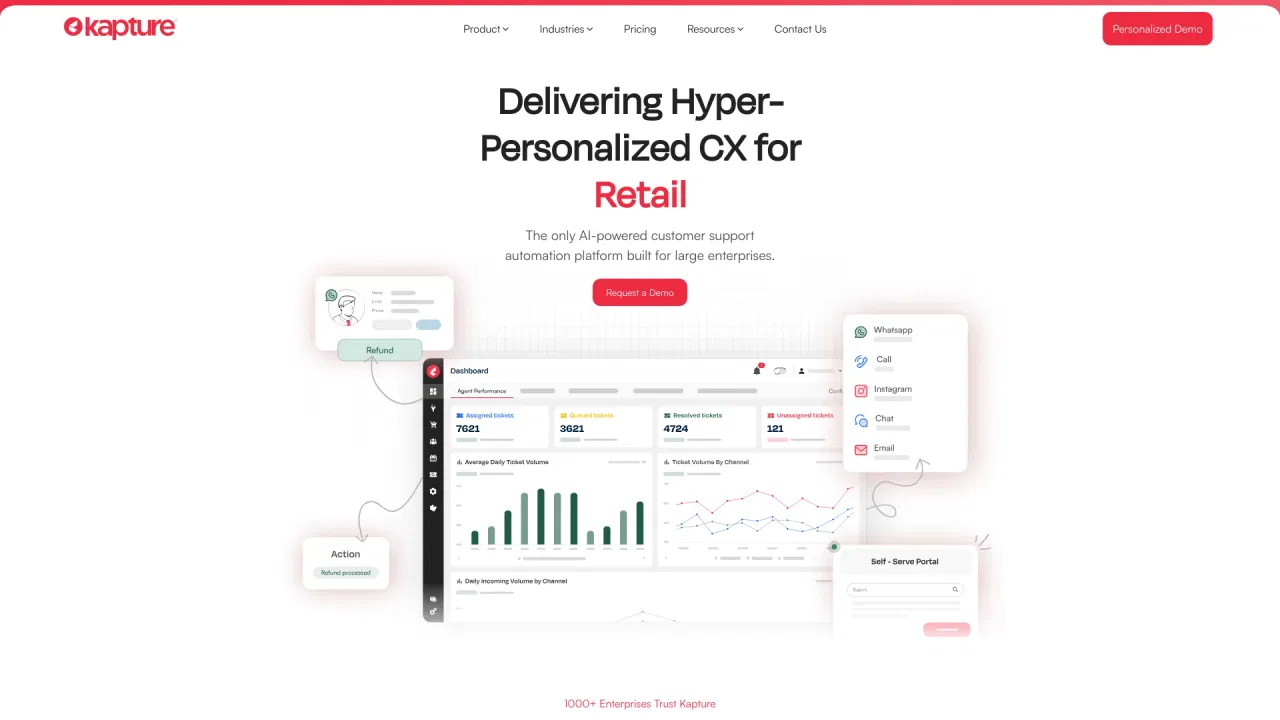
すべての顧客の声を、優先順位付きの実行可能な課題に変える
定義したタクソノミーに沿ってフィードバックとインサイトを分類し、量や言語が増えてもテーマの一貫性を保ちます。
各フィードバックにアカウント、売上、セグメント、プロダクトのコンテキストを付与し、最も損失の大きい問題を可視化します。
自然言語でフィードバックに問い合わせ、リリースの振り返りから繰り返し要望まで実行可能な分析を得られます。
発見事項をJiraやLinearなどに送り、課題を起票して修正を確認するエージェント主導のワークフローを起動します。
AIの学習・評価・研究のための高品質なヒューマンデータ基盤
詳細な属性・職業・行動条件で絞り込み、一般的な群衆ではなく狭く代表性のあるサンプルにアプローチできます。
ファインチューニング用の人間の選好データ収集、安全性評価やレッドチーミング、フィードバックAPIによる自動パイプラインへの組み込みが可能です。
注意力チェック、誠実性スクリーニング、承認ワークフローにより、分析前に雑な回答や不正回答を除外できます。
調査を公開すればすぐに回答収集を開始でき、スクリーニング、クォータ、縦断設計に対応する仕組みを備えています。
市場調査向けの大きな消費者パネルですが、学術研究やAIチューニングに特化したProleficのような強みはありません。


エンタープライズ向けのデータ注釈とAIアライメントを提供しますが、学術調査のセルフサービス募集にはあまり向きません。
無料・オープンソース顧客の声を売上に結びつけるAIフィードバック収集

特化型SuperAnnotate is an AI data platform that combines a collaborative multimodal annotation editor, an expert data-operations team, and the orchestration layer needed to move curated datasets into training, evaluation, and production pipelines. It is aimed at teams building computer vision, NLP, audio, and generative AI systems who need reliable, high-quality ground truth at scale.


特化型ビデオベースの消費者インタビューやAI定性分析に特化していますが、定量的な学術調査パネルへの注力は控えめです。
無料・オープンソース顧客起点のロードマップを支えるエージェント型プロダクト管理システム

特化型専門的な調査向けに検証済みのB2Bプロや医療専門家を提供していますが、一般向けの幅広い学術パネルは不足しています。

無料・オープンソースOpen-source data labeling and evaluation platform for AI workflows, but requires bringing your own annotation workforce.
サポート・営業・サービスを統合するAIカスタマーエクスペリエンス基盤
特化型SuperAnnotate is an AI data platform that combines a collaborative multimodal annotation editor, an expert data-operations team, and the orchestration layer needed to move curated datasets into training, evaluation, and production pipelines. It is aimed at teams building computer vision, NLP, audio, and generative AI systems who need reliable, high-quality ground truth at scale.
無料・オープンソースOpen-source data labeling and evaluation platform for AI workflows, but requires bringing your own annotation workforce.