01
2.3억/월
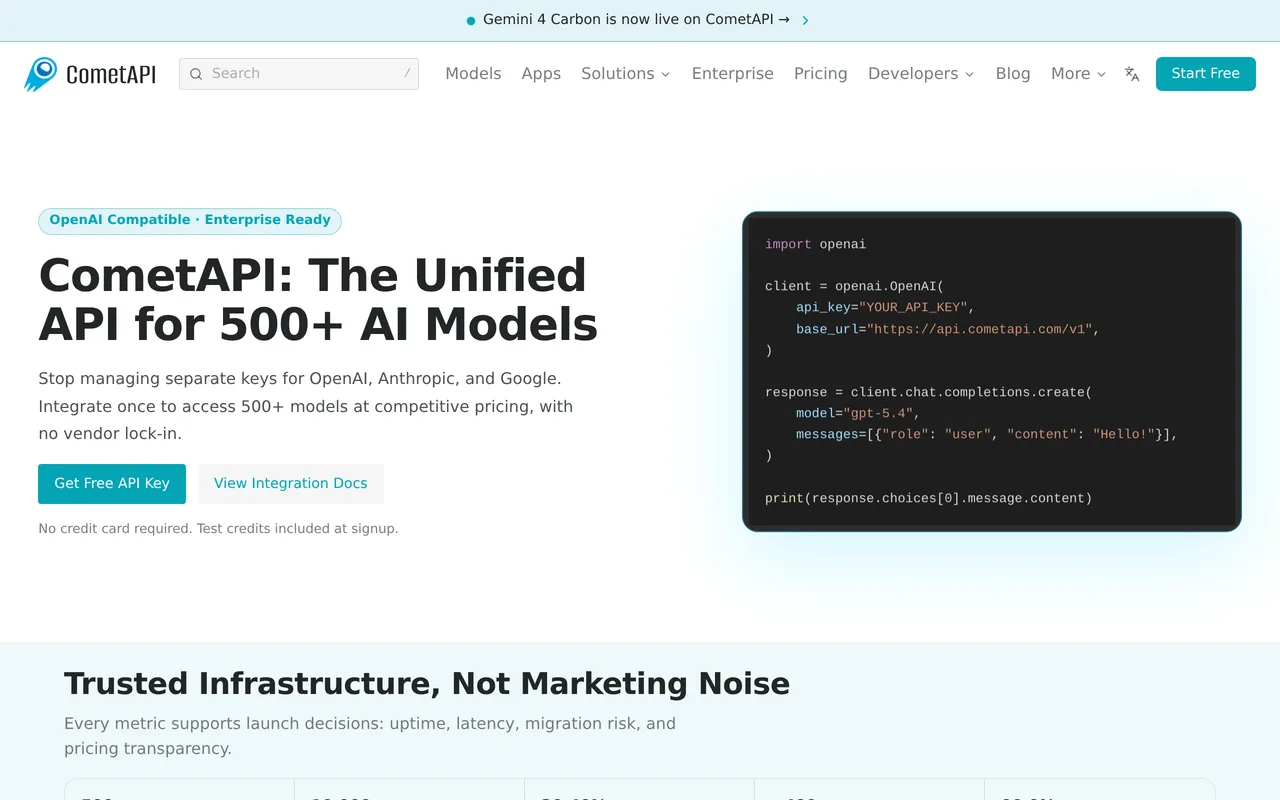
GPT-6 Astra, Sol, Luna와 실시간 멀티모달 에이전트를 배포하기 위한 엔터프라이즈 개발자 플랫폼 및 API.
AI 모델에디터 평점: 4.8유료직접 유입 45%

유료
EmbedAPI는 월간 방문 1,240, 전월 대비 성장률 -19.3%, 무료+유료 가격 모델을 기록합니다. MuAPI는 월간 방문 412,788, 성장률 +13.7%, 무료+유료 가격 모델을 기록합니다.

하나의 API 키로 모든 최전선 AI 모델과 400가지 이미지 스타일 연결
모든 생성 이미지·비디오·오디오 모델을 위한 하나의 API
| 항목 / 지표 | | |
|---|---|---|
| 공식 도메인 | embedapi.com | muapi.ai |
| 가격 모델 | 무료+유료 | 무료+유료 |
| 월간 방문 수 | 1.24천 (1,240) | 41.28만 (412,788) |
| 전월 대비 트래픽 변화량 | -297 (-19.3%) | +4.97만 (+13.7%) |
| 주요 시장 및 점유율 | 🇺🇸 미국 (100%) | 🇮🇳 인도 (24.6%) |
| 월 직접 방문 수 | 487 | 22.74만 |
| 사용자 평점 | 4.3 | 4.3 |
| 지원 플랫폼 | 웹사이트 | 웹사이트 |
하나의 API 키로 모든 최전선 AI 모델과 400가지 이미지 스타일 연결
Claude, GPT, Gemini, Grok, Kimi, Mistral, Llama, DeepSeek, Bedrock 모델을 단일 API 키와 일관된 요청 형식으로 라우팅합니다.
style 매개변수를 붙여 룩(예: 이름 있는 예술 스타일)을 고정합니다. EmbedAPI가 서버 측에서 프롬프트 기교를 주입해 프롬프트를 깔끔하게 유지합니다.
@embedapi/core, @embedapi/cli, @embedapi/agents, embed.js 브라우저 스크립트 또는 일반 REST를 사용할 수 있으며 모두 동일한 자격 증명과 모델 카탈로그를 공유합니다.
하나의 키로 Claude, Gemini, GPT, Bedrock 모델에 스트리밍 요청을 보내 프로덕션 연결 전에 지연, 품질, 동작을 테스트합니다.
모든 생성 이미지·비디오·오디오 모델을 위한 하나의 API
텍스트-투-이미지, 이미지-투-비디오, 텍스트-투-비디오, 업스케일, 배경 제거, 얼굴 교체, 립싱크를 동일한 인증과 결제로 이용합니다.
모델별로 가장 저렴하거나 빠른 공급자를 선택할 수 있고, 통합을 다시 작성하지 않고 가격과 품질 변화에 맞춰 전환합니다.
공개 순위와 리더보드로 모델을 비교하고, 상세 문서를 읽고, 에이전트 작업에는 CLI나 MCP 서버로 연결합니다.
다단계 파이프라인을 만들고 인터랙티브 스튜디오에서 프롬프트를 실험하며, 에이전트와 워크플로 기능으로 여러 모델을 연결해 하나의 결과물로 만듭니다.
GPT-6 Astra, Sol, Luna와 실시간 멀티모달 에이전트를 배포하기 위한 엔터프라이즈 개발자 플랫폼 및 API.

Gemini 모델로 멀티모달 애플리케이션을 구축하기 위한 Google의 신속한 프로토타이핑 IDE이자 개발자 API 워크벤치.

미디어 생성을 위한 초고속 서버리스 인프라와 개발자 API를 제공하지만, 다중 모델 번들링의 추상화 수준은 낮습니다.
Multi-model AI API gateway for calling video, image, music, and chat models via one key.
다양한 미디어 모델을 위한 OpenAI 호환 API를 제공하지만, 커뮤니티와 개발자 생태계는 다소 작습니다.
다양한 미디어 모델을 위한 OpenAI 호환 API를 제공하지만, 커뮤니티와 개발자 생태계는 다소 작습니다.


생성형 미디어 모델을 위한 초고속 저비용 API 추론을 제공하지만, 개발자 도구 모음은 더 특화되어 있습니다.
Unified API gateway providing developer access to diverse image, video, voice, and 3D models.

무료 / 오픈소스Open-source infrastructure project providing a single API to generate images, video, speech, music, and text.
무료 / 오픈소스Open-source infrastructure project providing a single API to generate images, video, speech, music, and text.
Consolidates hundreds of cross-modal AI models into unified gateway endpoints, but with less enterprise infrastructure maturity.
Consolidates hundreds of cross-modal AI models into unified gateway endpoints, but with less enterprise infrastructure maturity.

단일 엔드포인트 아래에 광범위한 파운데이션 모델을 집약하지만, 텍스트와 LLM에 크게 집중되어 있습니다.