01
DeepSeekOficial
372,8 mi/mês
EspecializadoIA de raciocínio open-weight e hospedada de alta eficiência, movida pelo DeepSeek-V4 e pelo R1 a custos de token ultrabaixos.
Large Language Models (LLMs)Nota editorial: 4.8Freemium+4,3%

Groq registra 3.987.936 visitas mensais com crescimento de +10% mês a mês e preços Pago. TokenByte registra 0 visitas mensais com crescimento de 0% e preços Pay-as-you-go.

Inferência de IA ultrarrápida na plataforma LPU e LPX
Uma chave de API para todos os principais modelos de IA
| Dimensão / Métrica | | |
|---|---|---|
| Domínio oficial | groq.com | tokenbyte.ai |
| Modelo de preços | Pago | Pay-as-you-go |
| Visitas mensais | 3,99 mi (3.987.936) | 0 (0) |
| Variação de tráfego mensal |
| +362,74 mil (+10%) |
| 0 (0%) |
| Mercado principal e participação | 🇮🇳 Índia (19,3%) | 🌐 Global (—) |
|---|
| Visitas diretas / mês | 1,7 mi | 0 |
|---|
| Avaliação dos usuários | 4,7 | 4,1 |
|---|
| Plataformas suportadas | Site | Site |
|---|
Inferência de IA ultrarrápida na plataforma LPU e LPX
Aceleradores próprios projetados para inferência em vez de treinamento, ajustados para latência muito baixa.
Acesso hospedado a modelos abertos populares como Llama, Mixtral, Gemma e os modelos de voz Whisper.
Uma API amplamente compatível com formatos de requisição no estilo OpenAI para integração rápida.
Reconhecimento automático de fala com Whisper e recursos de texto em fala para aplicações de voz.
Uma chave de API para todos os principais modelos de IA
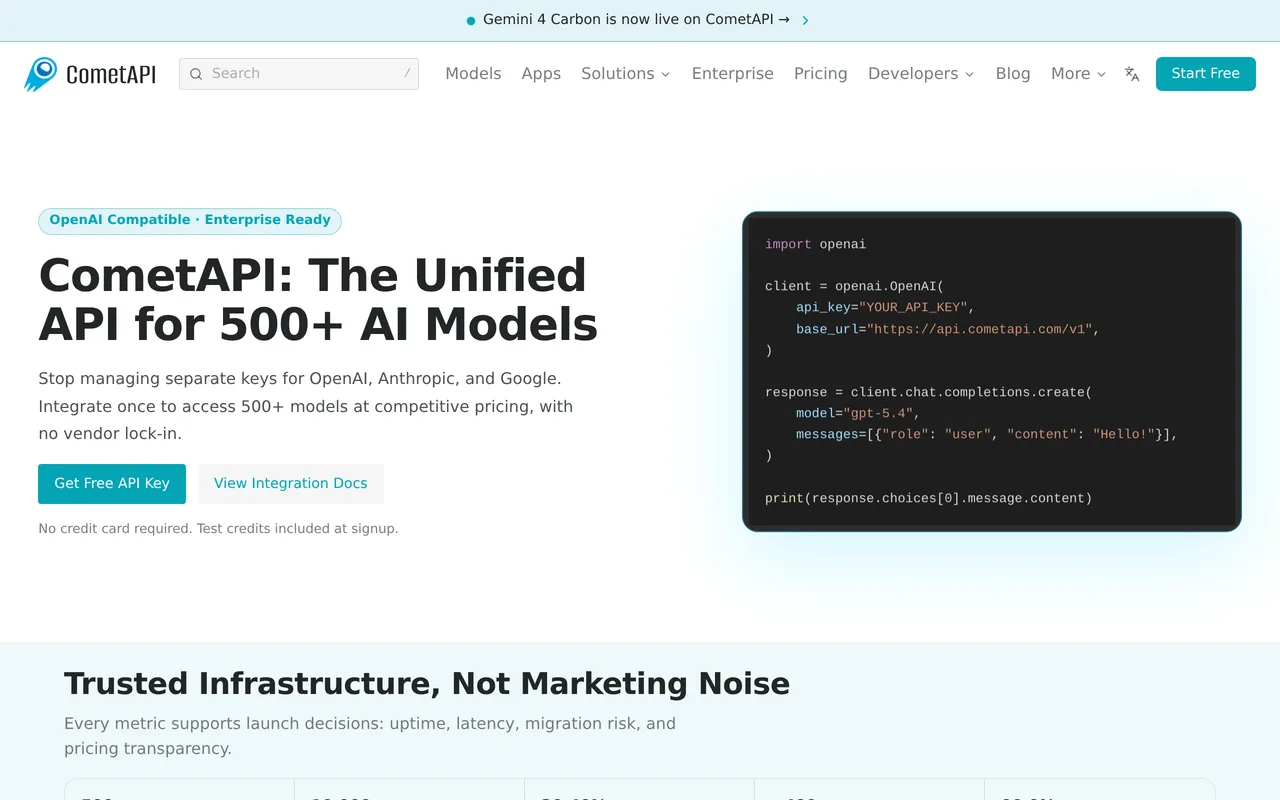
Aponte clientes existentes do SDK da OpenAI para https://api.tokenbyte.ai/v1 e autentique com uma chave do TokenByte para trocar de modelo sem reescrever código.
Acesse modelos da OpenAI, Claude, Gemini, DeepSeek e outros provedores por um conjunto unificado de APIs.
Monitore requisições de API, uso de tokens, distribuição por modelo, latência e gasto em um único painel em tempo real.
Veja tarifas de entrada e saída claramente separadas para cada modelo e estime e compare custos antes de lançar.
EspecializadoIA de raciocínio open-weight e hospedada de alta eficiência, movida pelo DeepSeek-V4 e pelo R1 a custos de token ultrabaixos.

EspecializadoProprietary frontier models with powerful reasoning and multimodal features, but lacking open-weight model hosting and custom inference speeds.


EspecializadoO IDE de prototipagem rápida e bancada de APIs para desenvolvedores do Google, para criar aplicações multimodais com modelos Gemini.

Grátis / Código abertoUma única chave de API para centenas de modelos de IA de todos os provedores

Plataforma de nuvem robusta para inferência de modelos open-source, oferecendo suporte extensivo a ajuste fino, mas velocidades brutas ligeiramente menores.

Nuvem de hardware em escala de wafer que entrega velocidades ultra-rápidas de geração de tokens comparáveis à do Groq, mas com um catálogo de modelos mais especializado.
Inferência sem servidor de alto rendimento para modelos abertos, com excelente velocidade, recursos de ajuste fino e ampla compatibilidade com API.

Grátis / Código abertoUma chave de API compatível com OpenAI para mais de 500 modelos de IA

Grátis / Código abertoUm gateway de IA de código aberto para mais de 100 provedores de LLM


Nuvem de inferência sem servidor de baixo custo que hospeda centenas de modelos de pesos abertos, mas que carece de aceleradores de hardware personalizados como as LPU.

Grátis / Código abertoUma API unificada para mais de 100 modelos de IA, com seguro quando a saída decepciona

Plataforma de IA em nuvem que fornece APIs de modelos sem servidor e instâncias de GPU, mas com menos foco em geração de texto de latência ultrabaixa.
EspecializadoIA de raciocínio open-weight e hospedada de alta eficiência, movida pelo DeepSeek-V4 e pelo R1 a custos de token ultrabaixos.
EspecializadoProprietary frontier models with powerful reasoning and multimodal features, but lacking open-weight model hosting and custom inference speeds.
EspecializadoO IDE de prototipagem rápida e bancada de APIs para desenvolvedores do Google, para criar aplicações multimodais com modelos Gemini.
Grátis / Código abertoUma única chave de API para centenas de modelos de IA de todos os provedores
Plataforma de nuvem robusta para inferência de modelos open-source, oferecendo suporte extensivo a ajuste fino, mas velocidades brutas ligeiramente menores.
Nuvem de hardware em escala de wafer que entrega velocidades ultra-rápidas de geração de tokens comparáveis à do Groq, mas com um catálogo de modelos mais especializado.
Grátis / Código abertoUma chave de API compatível com OpenAI para mais de 500 modelos de IA
Nuvem de inferência sem servidor de baixo custo que hospeda centenas de modelos de pesos abertos, mas que carece de aceleradores de hardware personalizados como as LPU.
Grátis / Código abertoUma API unificada para mais de 100 modelos de IA, com seguro quando a saída decepciona