01
HigressOpen Source
13.318/Monat
Kostenlos / Open SourceOpen-Source-KI-Gateway für LLM-APIs, Agenten und MCP-Server
AI APIRedaktionswert: 4.6Preise auf Anfrage39% direkt
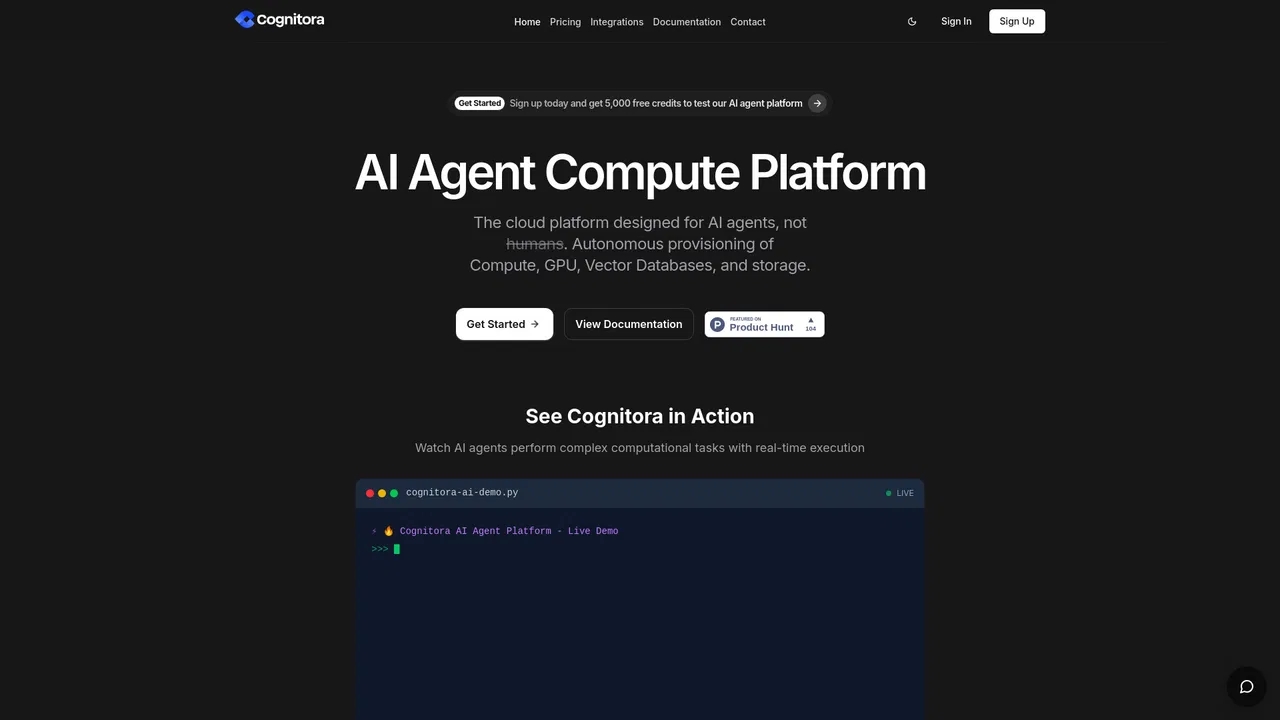
Open-Source-Orchestrierung für verteilte LLM-Inferenz in der eigenen Flotte
Geschätzte monatliche Website-Besuche
Similarweb-Schätzungen für diese Domain, keine aktiven Nutzer. Nur Monate mit Beobachtungen werden gezeigt; Erfassungsdatum und Messzeitraum sind getrennt.
Erfasst am 11.11.2026
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist Cognitora (cognitora.dev) eine KI-Plattform, die unter AI Agent indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0.0%) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Open Source“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Higress (13.318 Besuche/Monat), FlexAI (44.314 Besuche/Monat), RunPod (2,88 Mio. Besuche/Monat).
KV-Cache-Routing ist der absolute Hammer, nie wieder doppeltes Prefilling.
Einfach zu installieren und verdammt schnell.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Leitet jede Anfrage an den Knoten, dessen Cache das längste passende Prompt-Präfix hält, und nutzt die Präfixüberlappung von BLAKE3-Sequenz-Digests, um wiederholte Prefill-Arbeit zu vermeiden.
Eine einzige OpenAI-kompatible API vor vLLM, SGLang, llama.cpp, Apple MLX und einem TRT-LLM-Spawn-Treiber, sodass Sie Engines in einem Cluster mischen können.
Führt Prefill und Decode in getrennten Replikat-Pools mit KV-Übergabe über NixlConnector aus, sodass jede Phase die passende Hardware nutzen kann.
Bezieht Redfish- und NVML-Leistungswerte in die Routing-Bewertung ein, setzt weiche Watt-Obergrenzen pro Knoten und entleert heiße Knoten automatisch, um Energie pro Token zu senken.
Wird als sechs statische Binärdateien unter systemd ohne Kubernetes bereitgestellt oder optional mit einem kube-rs-Operator, der die CRDs InferenceCluster, ModelPool und RoutingPolicy bereitstellt.
Cognitora ist eine Open-Source-Orchestrierungsschicht für verteilte Inferenz großer Sprachmodelle, geschrieben in Rust. Statt eine einzelne Inferenz-Engine bereitzustellen, fasst sie die Engines, die Sie bereits betreiben — vLLM, SGLang, llama.cpp, Apple MLX, einen Spawn-Treiber für TRT-LLM und die eigene Preview-Engine cgn-infer — zu einem Cluster hinter einem einzigen OpenAI-kompatiblen Gateway zusammen. Sie kann anstelle eines Orchestrators wie NVIDIA Dynamo eingesetzt werden; das Projekt positioniert sich mit Unterstützung für mehr Engines, Bare-Metal-Betrieb ohne Kubernetes, der Einbeziehung des Stromverbrauchs in die Planung und dem Verzicht auf eine Python-Kontrollschicht.
Die zentrale Innovation ist das KV-bewusste Routing. Der Router bewertet Knoten nach der längsten Präfixüberlappung verketteter BLAKE3-Digests und nutzt dabei Cache-Ansprüche, die Agents in Heartbeats melden. In realen llama.cpp-Läufen fügte der Router laut Angaben 0,9–2,0 ms bei p50 hinzu. Über das Routing hinaus trennt die Plattform Prefill und Decode auf separate Replikat-Pools (KV-Übergabe über NixlConnector), unterhält einen mehrstufigen RAM-/SSD-KV-Cache mit knotenübergreifendem QUIC-Abruf und bietet austauschbare Offload-Backends wie nixl, lmcache, hicache und kvbm.
Der Stack ist modular: cgn-router für das Routing, cgn-agent zur Überwachung der Engines auf jedem Knoten, cgn-kvcached für den gestuften Cache, cgn-metrics für Prometheus- und Redfish/NVML-Leistungstelemetrie, cgn-ctl als Admin-CLI, ein optionaler Kubernetes-Operator und eine native Preview-Engine. Energiebewusste Planung entleert heiße Knoten, ein geschlossener Autoscaler reagiert auf Leistungswerte, und Gossip-basierte Erkennung macht etcd überflüssig. Zur Sicherheit gehören optionales mTLS, Releases mit SHA-256-Prüfsummen sowie OIDC- oder bereichsbezogene API-Key-Authentifizierung. Das Projekt liefert sechs statische Binärdateien für systemd-Installationen, Helm-Charts für Kubernetes und ein Cluster-Dashboard als einzelne HTML-Datei, das Durchsatz, Latenz-Perzentile, KV-Auslastung und Joule pro Token ohne Grafana darstellt.
Stellen Sie einen einzigen OpenAI-kompatiblen Endpunkt vor vLLM-, llama.cpp- und MLX-Knoten, damit Anwendungen nicht mehr wissen müssen, welche Engine ein Modell bedient.
Nutzen Sie KV-bewusstes Routing und mehrstufigen Cache, um dieselben Prompts nicht auf mehreren Knoten erneut vorzufüllen und den Durchsatz auf vorhandener Hardware zu steigern.
Beginnen Sie mit einigen DGX Sparks, AMD-Rechnern oder Mac Studios mit systemd und statischen Binärdateien und ergänzen Sie QUIC-Föderation, wenn ein Rack nicht mehr reicht.
Setzen Sie leistungsbewusste Admission und Autoscaling ein, damit ausgelastete Knoten Verkehr abgeben und die Flotte nahe ihrem Effizienzoptimum läuft.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | Cognitora | 0 | — | — | Open Source | Aktuell |
| 1 | Higress | 13.318 | -17,9 % | 39% direkt | Preise auf Anfrage | vs Higress |
| 2 | FlexAI | 44.314 | +17,9 % | 37% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs FlexAI |
| 3 | RunPod | 2,88 Mio. | +5,9 % | 57% direkt | Kostenpflichtig | vs RunPod |
| 4 | Salad | 713.519 | +10,4 % | 62% direkt | Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs Salad |
| 5 | boat | 66.870 | +520,8 % | 56% direkt | Kostenlose Testversion, Kostenpflichtig | vs boat |
| 6 | Browser Use | 1,21 Mio. | +41,1 % | 52% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs Browser Use |
Kostenlos / Open SourceOpen-Source-KI-Gateway für LLM-APIs, Agenten und MCP-Server
Kostenlos / Open SourceKI bauen, betreiben und skalieren – von offenen Modellen bis zu gouvernierten Agenten
RunPod is a cloud platform for AI and machine learning workloads that rents GPU compute by the second. It offers Pods for persistent GPU instances, Serverless endpoints that autoscale inference from zero, and multi-node Clusters, plus a Hub of ready-to-deploy open-source models and templates.
RunPod is a cloud platform for AI and machine learning workloads that rents GPU compute by the second. It offers Pods for persistent GPU instances, Serverless endpoints that autoscale inference from zero, and multi-node Clusters, plus a Hub of ready-to-deploy open-source models and templates.

Kostenlos / Open SourceVerteilte GPU-Cloud, die die ungenutzten Consumer-GPUs der Welt orchestriert
Kostenlos / Open SourceVerteilte GPU-Cloud, die die ungenutzten Consumer-GPUs der Welt orchestriert

Kostenlos / Open SourcePersistente Ubuntu-Cloud-VMs für KI-Agenten-Fabriken
Kostenlos / Open SourceBrowser-Agenten und getarnte Cloud-Browser für echte Webaufgaben
Kostenlos / Open SourceBrowser-Agenten und getarnte Cloud-Browser für echte Webaufgaben
Kostenlos / Open SourceRivet is open-source infrastructure for running and scaling AI agents as "Actors" — durable, stateful compute units that live inside your own Node.js or Bun backend. Each Actor keeps persistent state, a filesystem, and a SQLite database, so agents survive restarts, share state, and run code written at runtime without a redeploy. Rivet ships as a single stateless Rust binary and can be self-hosted, run in your VPC, or used through a managed cloud.
Kostenlos / Open SourceRivet is open-source infrastructure for running and scaling AI agents as "Actors" — durable, stateful compute units that live inside your own Node.js or Bun backend. Each Actor keeps persistent state, a filesystem, and a SQLite database, so agents survive restarts, share state, and run code written at runtime without a redeploy. Rivet ships as a single stateless Rust binary and can be self-hosted, run in your VPC, or used through a managed cloud.
Kostenlos / Open SourceSelbst gehostete Cloud-Entwicklungsumgebungen und KI-Coding-Agenten für Unternehmensteams

Kostenlos / Open SourceTogether AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.
Kostenlos / Open SourceTogether AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.
Kostenlos / Open SourceServerlose Cloud-Infrastruktur für KI- und Daten-Workloads
Kostenlos / Open SourceServerlose Cloud-Infrastruktur für KI- und Daten-Workloads

Kostenlos / Open SourceAgenten-native Cloud-Infrastruktur, mit der Coding-Agenten den gesamten Backend-Stack betreiben
Nebius is an AI-focused cloud platform that gives teams non-virtualized NVIDIA GPU clusters, managed MLOps tooling, and a serverless inference layer so they can move from experiment to production on one stack.
Nebius is an AI-focused cloud platform that gives teams non-virtualized NVIDIA GPU clusters, managed MLOps tooling, and a serverless inference layer so they can move from experiment to production on one stack.


