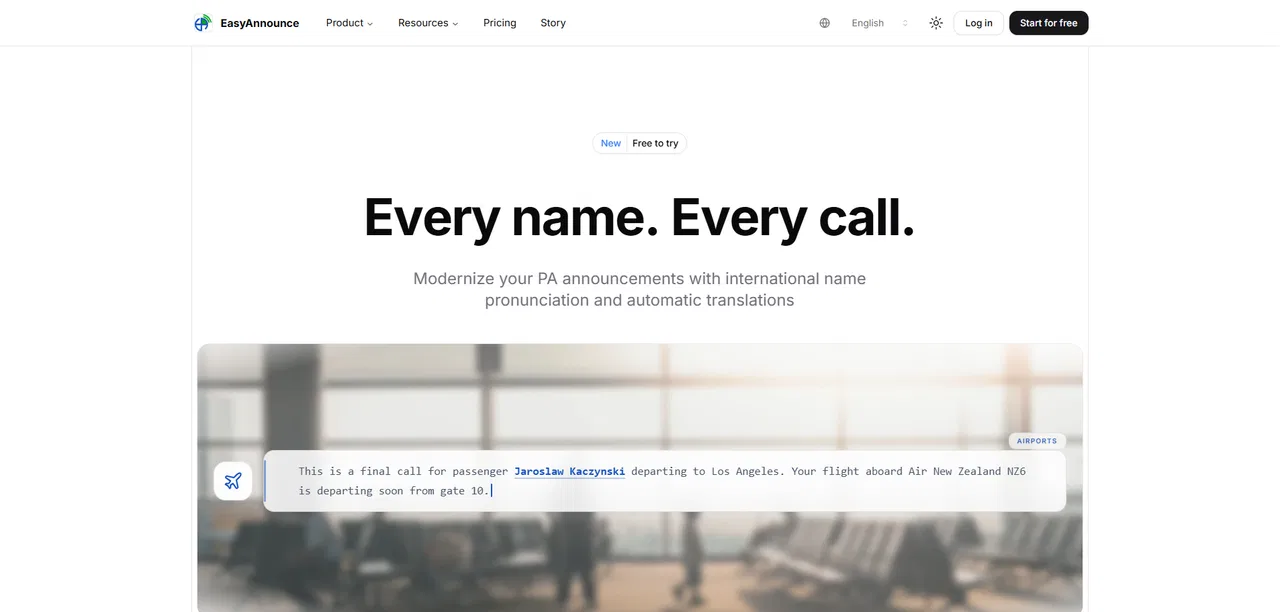
EasyAnnounce widmet sich einem sehr konkreten betrieblichen Problem: dem Ausruf über die Lautsprecheranlage. An Flughäfen, in Kliniken, an Bahnhöfen, in Resorts und großen Cafés müssen Mitarbeitende regelmäßig eine Person namentlich über die PA-Anlage aufrufen – oft in einer Zweitsprache und mit einem Namen, den sie noch nie gesehen haben. Die Folge sind falsch ausgesprochene Namen, wiederholte Durchsagen und ein spürbarer Rückgang der Personen, die tatsächlich verstehen, dass sie gemeint sind. EasyAnnounce ersetzt dieses improvisierte Vorgehen durch einen reproduzierbaren, automatisierten Ablauf.
Die Plattform funktioniert auf zwei Wegen. In der Web-App gibt eine Bedienkraft den Kundennamen und die Durchsage ein, und der Dienst liefert eine vollständige, direkt abspielbare Audiodatei zurück. Im Hintergrund entscheidet ein mit Millionen von Namen trainiertes Aussprachemodell, wie der Name gesprochen werden sollte, und eine Sprachsynthese-Pipeline spricht die gesamte Durchsage mit einer einzigen, konsistenten Stimme. Optional erzeugt EasyAnnounce zusätzlich eine übersetzte Fassung der kompletten Durchsage, damit die angesprochene Person sie in einer wahrscheinlich besser verständlichen Sprache hört.
Für Teams, die bereits Voice Agents oder automatisierte Aufrufsysteme betreiben, stellt eine REST-API dieselben Funktionen programmatisch bereit: Kundennamen per POST senden und fertiges Audio empfangen – oder Aussprachehinweise und Sprachvorhersagen abrufen, um die eigene TTS-Pipeline zu speisen. EasyAnnounce wurde entwickelt, um unterschiedliche PA-Systeme an unterschiedlichen Standorten zu verbinden, sodass Durchsagen zur Wiedergabe an einen Partnerstandort gesendet werden können, ohne dass eine der Seiten ihre Hardware ändert. Namen werden verarbeitet und nicht gespeichert; erzeugtes Audio wird unter anonymisierten Kennungen abgelegt und automatisch gelöscht.