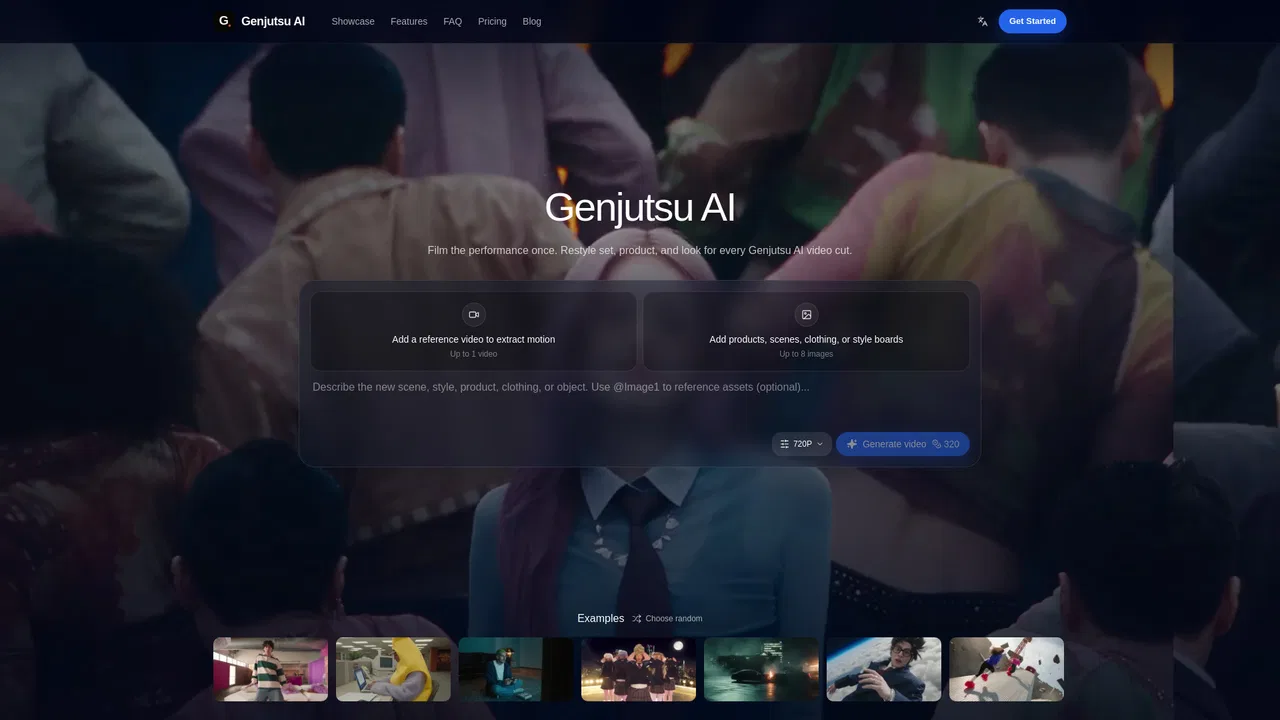
Genjutsu AI verfolgt einen anderen Ansatz als reine Text-zu-Video-Generatoren. Statt jedes Einzelbild aus Sprache zu erfinden, behandelt es aufgezeichnete Bewegung und Timing, Kameraführung und Performance als Wahrheitsquelle und gestaltet die Welt um diesen Take herum neu. Das macht es gut geeignet für Arbeiten, bei denen Kontinuität zählt: eine bereits abgenommene Performance, ein bestimmter Tanzrhythmus oder eine festgelegte Kamerabewegung, die einen Produkt- oder Garderobenwechsel überstehen muss.
Ein typischer Durchlauf hat drei Eingaben: ein virales Template wählen (oder ein eigenes Referenzvideo hochladen, oft 4–30 Sekunden mit klar erkennbarer Subjektbewegung), ein bis zwei Fotos von Personen oder Objekten hinzufügen und optional einen Prompt schreiben, der benennt, welche Bewegung und welches Timing fixiert bleiben und was sich ändern darf. Die Generierung läuft direkt auf der Startseite, sodass Anmeldung, Credits und deine private Bibliothek an einem Ort liegen und fehlgeschlagene Generierungen Credits automatisch zurückgeben.
Es richtet sich an Menschen, deren Engpass der Kalender und nicht die Ideen sind. Growth-Marketer lokalisieren Packaging und Szenenstyling aus einem abgenommenen Take, Musik- und Performance-Creator erzeugen mehrere Looks aus einem Template, Solo-Creator werten Handy-Material auf, ohne den Schnitt neu zu bauen, und Agenturen teilen eine fixierte Performance und iterieren bis zur Freigabe. Der Preis ist creditbasiert über Abos oder Einzelpakete, wobei die Credit-Kosten vor dem Rendern angezeigt werden.