Kostenlos / Open SourcePreise, Funktionen und Fähigkeiten von KI-Modellen an einem Ort vergleichen

Unabhängiges LLM-Leaderboard für Fähigkeit, Preis, Tempo und Benchmarks

Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist LLMBoard.ai (llmboard.ai) eine KI-Plattform, die unter Large Language Models (LLMs) indexiert ist und 378 monatliche Besuche mit einem Traffic-Delta von +378 (0 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Vereinigte Staaten (100 % Traffic-Anteil) und sie arbeitet mit einem Preismodell „Kostenlos“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Countless.dev (787 Besuche/Monat), Models.dev (200.451 Besuche/Monat), LLM Price Check (8255 Besuche/Monat).
Beste Übersicht für LLM-Benchmarks und Preise.
Sehr nützlich, könnte aber mehr Audio-Modelle zeigen.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
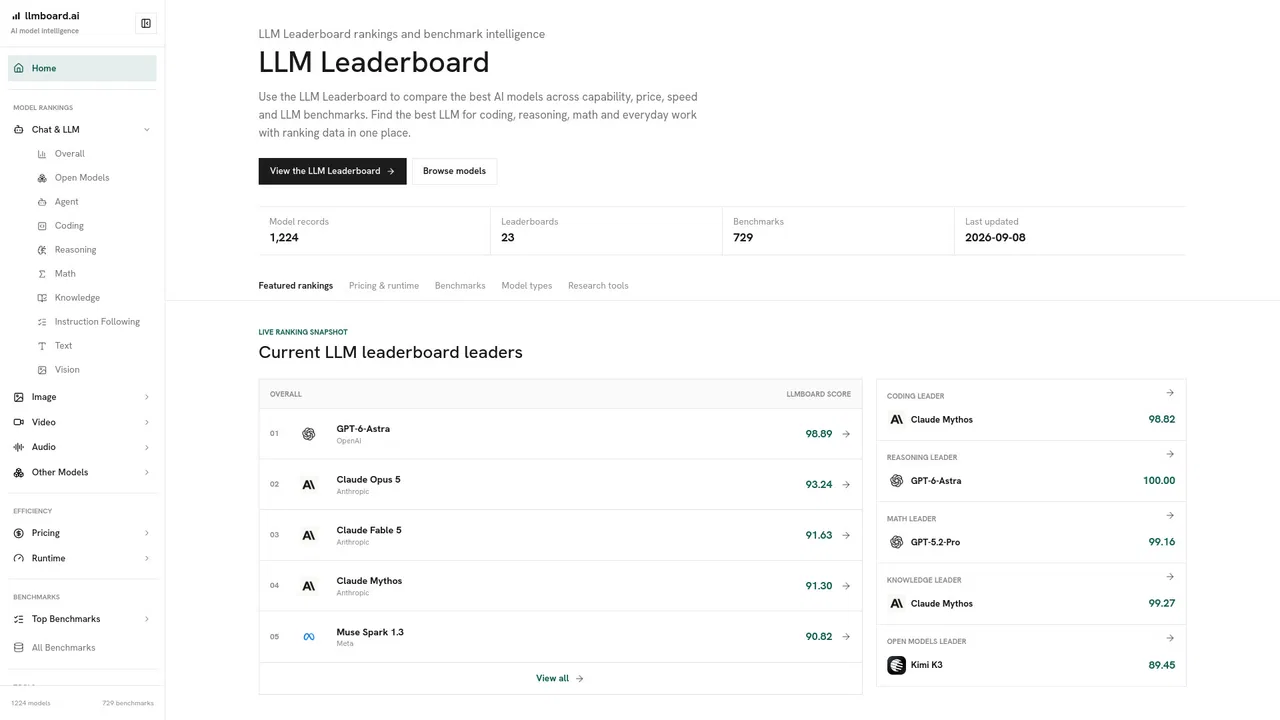
Getrennte Ranglisten für allgemeinen Chat, Coding, Reasoning, Mathematik, Wissen, Instruktionsbefolgung, Agentenaufgaben, Vision, Bild, Video, Audio und Embeddings – Vergleich passend zur echten Arbeit.
Einzelne Evaluierungen wie GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval und MMMU-Pro, jeweils mit Rohreihenfolge und Abdeckungsdetails.
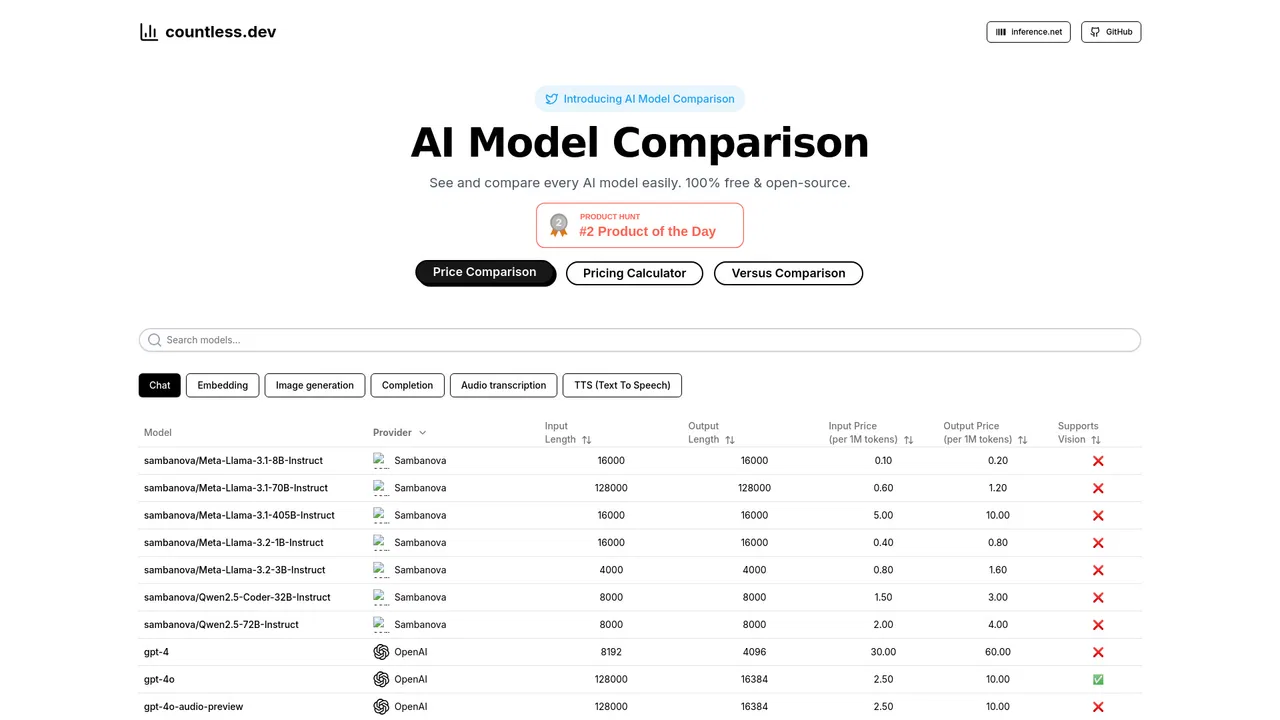
Eigene Preisansichten für Chat-Token, Bild, Video und Audio sowie der Zusammenhang von Kosten und Fähigkeit, um echten Mehrwert zusätzlicher Ausgaben zu erkennen.
Ranglisten zu Ausgabegeschwindigkeit und Latenz neben Anbieterzuverlässigkeit – die operative Seite der Modellwahl, nicht nur Benchmark-Punkte.
Ein filterbarer Katalog nach Anbieter, Typ, Modalität und Preis, mit veröffentlichten Regeln zu Scoring, Abdeckung und Modellzuordnung zur Prüfbarkeit der Rankings.
LLMBoard.ai beantwortet eine Frage, die sich alle paar Wochen ändert: Welches Modell sollten wir tatsächlich einsetzen? Die Seite pflegt einen laufend aktualisierten Katalog aus Modell-Datensätzen und Benchmark-Ergebnissen und präsentiert sie als aufgabenbezogene Leaderboards: allgemeiner Chat und LLM, Agenten, Coding, Reasoning, Mathematik, Wissen, Instruktionsbefolgung sowie eigene Bereiche für Vision, Bildgenerierung und -bearbeitung, Video, Text-zu-Sprache, Sprache-zu-Text und Embeddings. Jede Rangliste stützt sich auf benannte Benchmarks wie GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval und MMMU-Pro.
Der Unterschied zu einem Ranking mit einer einzigen Zahl: Die Signale werden bewusst getrennt. Leistungswerte stehen neben Preis, Laufzeitlatenz und Anbieterzuverlässigkeit, sodass ein Benchmark-Spitzenreiter nicht automatisch als bester Wert oder stabilste Wahl dargestellt wird. Es gibt eigene Preisseiten für Chat-Token, Bild, Video und Audio sowie Ansichten zu Geschwindigkeit und Zuverlässigkeit. Der Bereich Scoring und Daten dokumentiert Modellzuordnung und Bewertungsregeln, und jede Benchmark-Seite zeigt die Rohreihenfolge und Abdeckung, damit die Evidenz prüfbar ist.
Zielgruppe sind Engineering-Teams, Produktmanager und Forschende, die Modelle für eine konkrete Arbeitslast bewerten, ebenso wie alle, die den Vergleich offener mit proprietären Frontier-Modellen verfolgen. Es ist eine Informations- und Vergleichsressource: Die Seite hostet die Modelle nicht, und Ergebnisse sollten als Ausgangspunkt für eigene Tests gelten.
Verzeichnis filtern und Coding- oder Reasoning-Spitzenreiter gegen Token-Preis und Durchsatz abwägen, um Qualität und Budget zu erfüllen.
Benchmark-Seiten, Abdeckungshinweise und Preisansichten nutzen, um die Modellwahl gegenüber Stakeholdern zu belegen statt auf Anbietermarketing zu vertrauen.
Offene Spitzenmodelle gegenüber proprietären Frontier-Modellen über Zeit mit konsistenten Benchmark-Daten und der veröffentlichten Methode beobachten.
Live-Rankings, Anbieterzuverlässigkeit und Preise je Modalität heranziehen, um Empfehlungen zwischen gehosteten APIs und offenen Modellen zu stützen.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | LLMBoard.ai | 378 | 0 % | 33% direkt | Kostenlos | Aktuell |
| 1 | Countless.dev | 787 | -45,8 % | 40% direkt | Kostenlos | vs Countless.dev |
| 2 | Models.dev | 200.451 | -3,9 % | 68% direkt | Kostenlos | vs Models.dev |
| 3 | LLM Price Check | 8255 | -34,7 % | 39% direkt | Kostenlos | vs LLM Price Check |
| 4 | Surge AI | 245.142 | +6,6 % | 53% direkt | Preise auf Anfrage | vs Surge AI |
| 5 | thisorthis.ai | 2250 | -43,7 % | 39% direkt | Kostenlos | vs thisorthis.ai |
| 6 | ModelFusion | 119 | -88,2 % | 43% direkt | Freemium | vs ModelFusion |
Kostenlos / Open SourcePreise, Funktionen und Fähigkeiten von KI-Modellen an einem Ort vergleichen

Kostenlos / Open SourceOpen-Source-Datenbank für KI-Modelle, Preise und Fähigkeiten

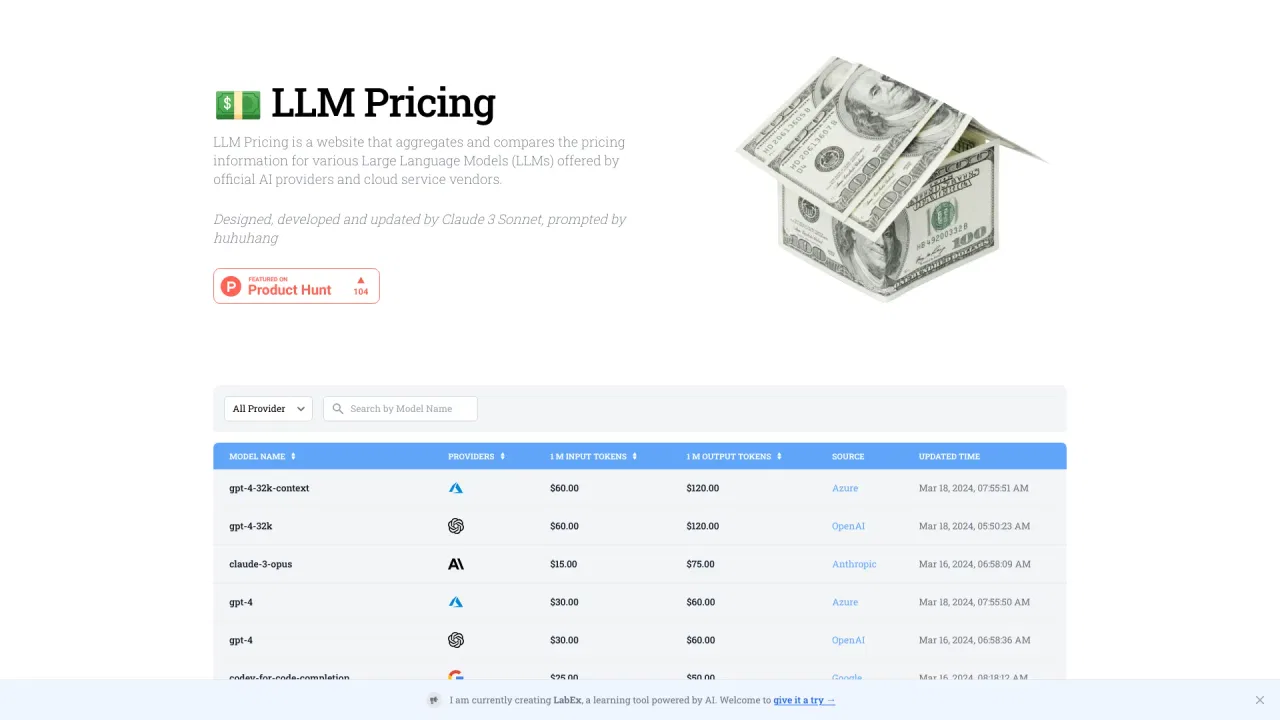
SpezialisiertLLM-API-Tokenpreise aller großen Anbieter im Vergleich

Expertische menschliche Daten und Evaluation für das Training von Frontier-KI

Jeden Monat für die beste KI abstimmen und das Live-Ranking verfolgen

Kostenloser LLM-Toolkit: Kostenrechner, Prompts und Modellvergleich

Ein kostenloses Archiv, wie jedes KI-Modell dieselben 100 Fragen beantwortete

The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
SpezialisiertTokenkosten von über 400 KI-Modellen vergleichen

Crowdsourcing-Arena, in der KI-Modelle antreten und Menschen das beste Design-Ergebnis küren

Wähle deinen KI-Stack und beweise ihn an echter Arbeit

Die wichtigsten KI-News und ihre Anwendung, in fünf Minuten pro Tag