01
2,2 Mio./Monat
Chatte mit über 30 führenden KI-Modellen in einem aufgeräumten Workspace
KI-ChatbotRedaktionswert: 3.9Freemium23% direkt

2,2 Mio./Monat
Chatte mit über 30 führenden KI-Modellen in einem aufgeräumten Workspace
Freemium

Multimodale Modelle nebeneinander bewerten und vergleichen
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist Non finito (nonfinito.xyz) eine KI-Plattform, die unter KI-Modelle indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Freemium“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Chatbot App (2,17 Mio. Besuche/Monat), Future AGI (121.741 Besuche/Monat), Appen (665.840 Besuche/Monat).
Perfekt, um Modelle direkt zu vergleichen.
Sehr nützlich für die Evaluierung von Vision-Modellen.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
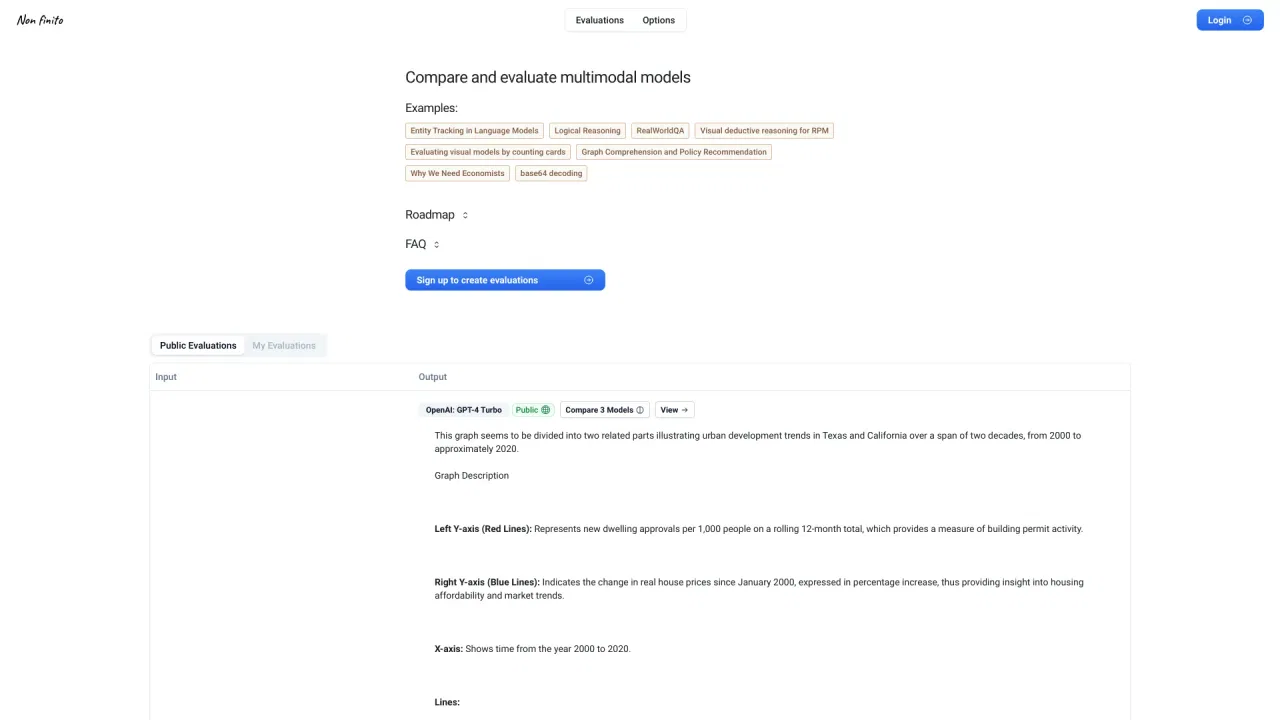
Ein Prompt läuft gegen mehrere Modelle, die Ausgaben stehen in parallelen Spalten; für größere Vergleiche gibt es Mehrmodell-Ansichten.
Jede Antwort lässt sich als bestanden oder fehlgeschlagen markieren und wird so zu einem nachverfolgbaren Modellverhalten.
Evaluationen bleiben im eigenen Workspace oder werden geteilt, damit andere Prompts und Ergebnisse prüfen und wiederverwenden können.
Beispiel-Evaluationen decken Sprachschlussfolgern, visuelle Analogien, Zählen, Diagrammverständnis und strukturierte Dekodierung ab.
Öffentliche Evaluationen nennen OpenAI o1, DeepSeek R1, Qwen QwQ 32B Preview und xAI Grok 2 bei identischen Eingaben.
Non finito behandelt Modellqualität als etwas, das gemessen wird, statt als Selbstverständlichkeit. Der Kernablauf ist einfach: Prompt schreiben, zwei oder mehr Modelle auswählen, Antworten nebeneinander lesen. Die öffentlichen Evaluationen reichen von Denkaufgaben — etwa dem kleinsten ungeraden Primfaktor einer großen Zahl — über visuell-deduktives Schlussfolgern und Real-World-QA, RPM-artige visuelle Analogien, Kartenzählaufgaben, Diagrammverständnis und Policy-Empfehlungen, Entity Tracking bis zur base64-Dekodierung. Verglichen werden unter anderem OpenAI o1, DeepSeek R1, Qwen QwQ 32B Preview und xAI Grok 2 bei identischen Eingaben.
Über den reinen Vergleich hinaus hält die Plattform für jede Antwort ein Urteil fest. Evaluationen lassen sich als bestanden oder fehlgeschlagen markieren, wodurch ein Stapel Transkripte eher zu einem erneut lesbaren Scoreboard wird. So lässt sich prüfen, ob ein neues Modell bei den eigenen Prompts tatsächlich besser ist als die Vorgängerversion, statt einem Leaderboard mit fremden Aufgaben zu vertrauen.
Evaluationen können privat im eigenen Workspace bleiben oder öffentlich geteilt werden, damit andere sie ansehen und vergleichen können; die Seite lädt zum Registrieren und Erstellen eigener Evaluationen ein. Es ist ein schlankes Recherchewerkzeug, also eher eine fokussierte Oberfläche als eine Enterprise-Suite mit automatisierten Scoring-Pipelines.
Das eigene Prompt-Set gegen das neu veröffentlichte Modell laufen lassen und Urteile mit der Vorgängerversion vergleichen.
Wichtige Prompts mit festgehaltenen Ergebnissen zentral halten, damit Regressionen bei Modell-Updates sichtbar werden.
Dieselben Anweisungen gegen mehrere kommerzielle und offene Modelle laufen lassen, um den passenden Kandidaten zu finden.
Veröffentlichte Evaluationen mit vollständigen Denkverläufen nebeneinander eignen sich gut für Lehre zu Modellverhalten und Fehlerbildern.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | Non finito | 0 | 0 % | — | Freemium | Aktuell |
| 1 | Chatbot App | 2,17 Mio. | -9,7 % | 23% direkt | Freemium | vs Chatbot App |
| 2 | Future AGI | 121.741 | -7,8 % | 59% direkt | Freemium, Usage-based | vs Future AGI |
| 3 | Appen | 665.840 | +0,2 % | 36% direkt | Preise auf Anfrage | vs Appen |
| 4 | Label Studio | 137.199 | -16,1 % | 34% direkt | Preise auf Anfrage, Kostenlos | vs Label Studio |
| 5 | ModelScope | 3,09 Mio. | +5,1 % | 68% direkt | Kostenlos | vs ModelScope |
| 6 | CanIRun.ai | 284.892 | -20,1 % | 48% direkt | Kostenlos | vs CanIRun.ai |
Chatte mit über 30 führenden KI-Modellen in einem aufgeräumten Workspace
Chatte mit über 30 führenden KI-Modellen in einem aufgeräumten Workspace

Kostenlos / Open SourceSelbstverbessernde KI-Agenten bauen, simulieren, evaluieren und überwachen
Kostenlos / Open SourceSelbstverbessernde KI-Agenten bauen, simulieren, evaluieren und überwachen

Von Menschen validierte Trainingsdaten und Evaluierung für Frontier-KI-Modelle
Von Menschen validierte Trainingsdaten und Evaluierung für Frontier-KI-Modelle

Kostenlos / Open SourceLabel Studio is an open-source data labeling and AI evaluation platform from HumanSignal. It handles images, video, audio, text, documents, time series and agent traces in one flexible workspace, and connects to your ML pipeline through an API, Python SDK and webhooks.
Kostenlos / Open SourceLabel Studio is an open-source data labeling and AI evaluation platform from HumanSignal. It handles images, video, audio, text, documents, time series and agent traces in one flexible workspace, and connects to your ML pipeline through an API, Python SDK and webhooks.
Kostenlos / Open SourceModelScope (魔搭社区) is an open-source AI community and model service platform that hosts thousands of pretrained models, datasets, and ready-to-run demos, backed by Alibaba Cloud infrastructure.
Kostenlos / Open SourceModelScope (魔搭社区) is an open-source AI community and model service platform that hosts thousands of pretrained models, datasets, and ready-to-run demos, backed by Alibaba Cloud infrastructure.

SpezialisiertPrüfen, welche lokalen KI-Modelle Ihre GPU oder Ihr Mac wirklich ausführt
SpezialisiertPrüfen, welche lokalen KI-Modelle Ihre GPU oder Ihr Mac wirklich ausführt

Alle führenden KI-Modelle in einem Chat – zu einem Abopreis
Alle führenden KI-Modelle in einem Chat – zu einem Abopreis
Suprmind is a multi-model decision intelligence platform that runs five frontier AIs in a single conversation, lets them challenge each other's answers, and exports the result as a shareable decision document.
Suprmind is a multi-model decision intelligence platform that runs five frontier AIs in a single conversation, lets them challenge each other's answers, and exports the result as a shareable decision document.

Enterprise-KI-Infrastruktur, bei der Software und menschliche Experten zusammenarbeiten
Enterprise-KI-Infrastruktur, bei der Software und menschliche Experten zusammenarbeiten
Bewerte jedes Frontier-Modell anhand deiner eigenen Workflows
Bewerte jedes Frontier-Modell anhand deiner eigenen Workflows
Kostenlos / Open SourceQuelloffene KI-Modelle für Bild, Video und 3D entdecken, herunterladen und damit erzeugen.
Kostenlos / Open SourceQuelloffene KI-Modelle für Bild, Video und 3D entdecken, herunterladen und damit erzeugen.
Wikis.ai is a multi-model AI workspace where one question goes to several leading models at once and the answers appear side by side. It pairs a model-comparison chat with a deep-research mode that scans the web and assembles a sourced report, plus an AI Wiki of editorially structured explainers. You keep one credit balance covering chat, research and reports.
Wikis.ai is a multi-model AI workspace where one question goes to several leading models at once and the answers appear side by side. It pairs a model-comparison chat with a deep-research mode that scans the web and assembles a sourced report, plus an AI Wiki of editorially structured explainers. You keep one credit balance covering chat, research and reports.