01
2110/Monat
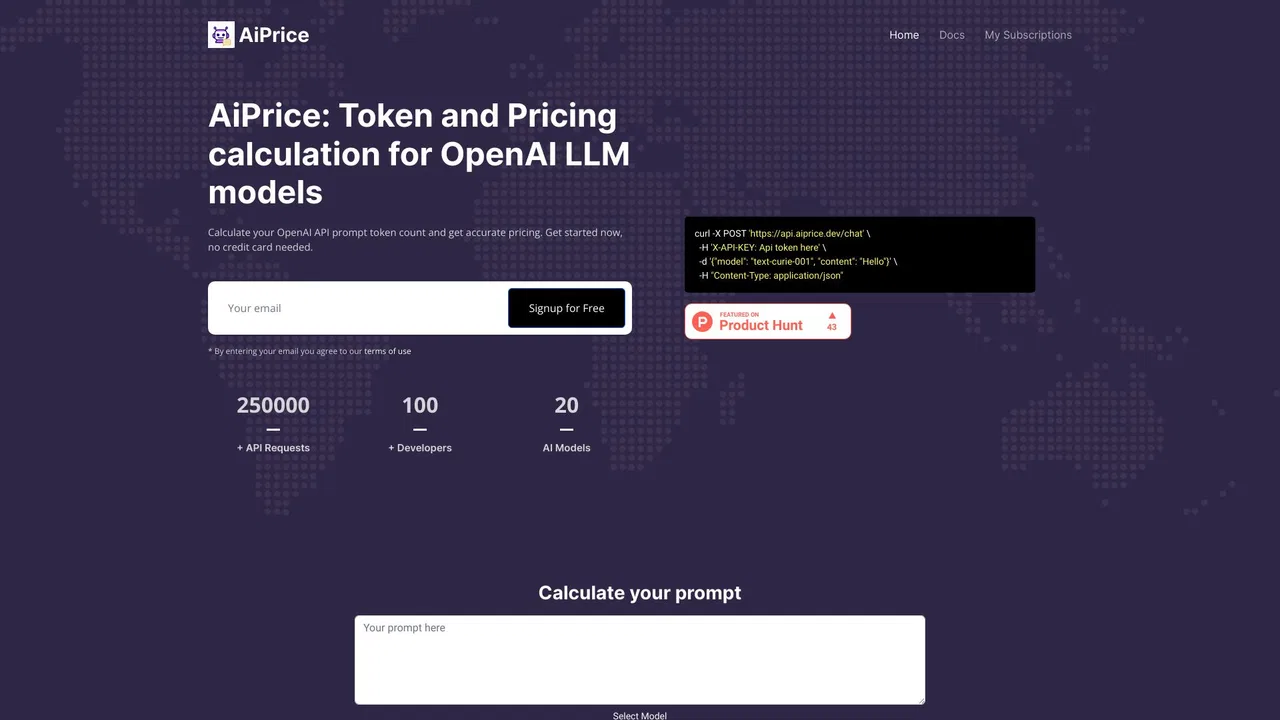
OpenAI-Prompt-Tokens und Kosten schätzen, bevor Sie die API aufrufen
AI APIRedaktionswert: 4.0Freemium39% direkt
LLM-Prompts mit einem REST-API-Aufruf komprimieren und Token-Kosten senken
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
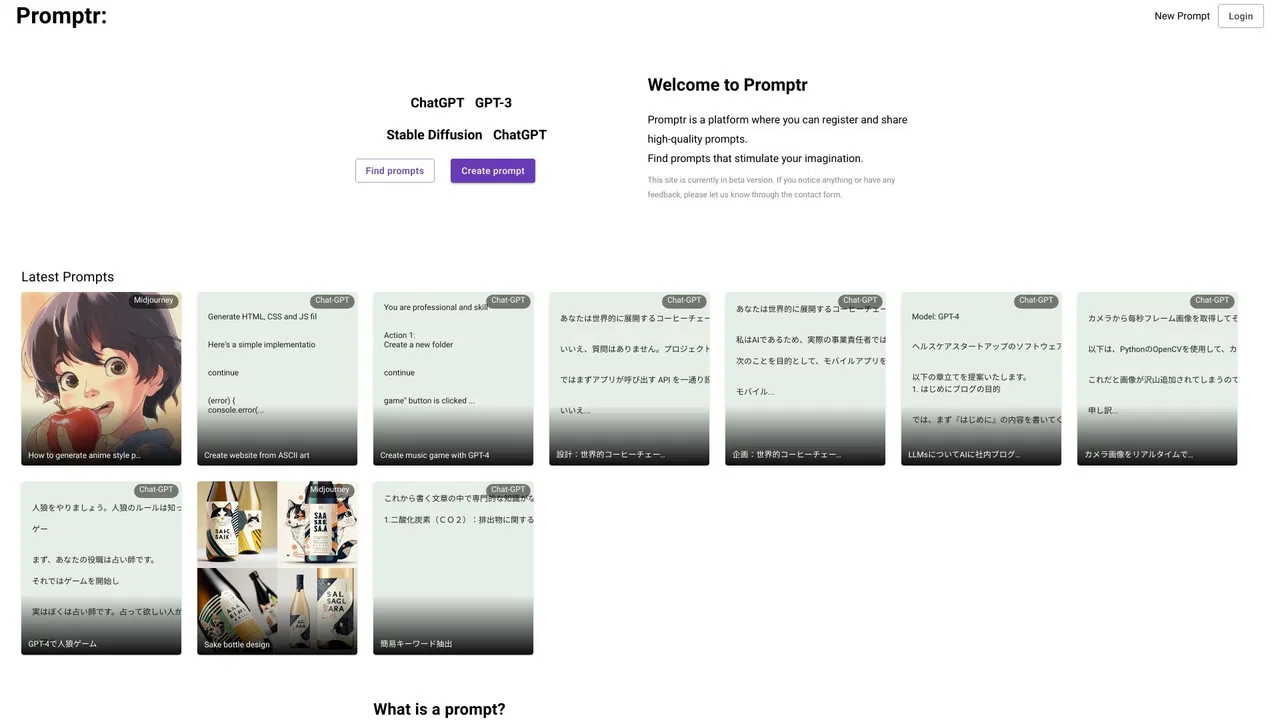
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist Promptr (promptr.dev) eine KI-Plattform, die unter Sonstiges indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Pay-as-you-go“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören AiPrice (2110 Besuche/Monat), Edgee (6558 Besuche/Monat), Caveman (171.826 Besuche/Monat).
Gute Idee, spart Token bei langen Systemprompts.
Warteliste nervt, aber API funktioniert solide.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Sende deinen Prompt an einen einzigen REST-Endpunkt und erhalte eine kürzere Version als Klartext, direkt weiterverwendbar für dein Modell.
Der Anbieter nennt bis zu 40 % geringere LLM-Inputkosten, mit einem Rechenbeispiel, das 45 % Reduktion bei einem Beispiel-Prompt zeigt.
Beispiele zum Einfügen für curl, Python, JavaScript und C# sorgen dafür, dass die Integration Minuten statt Tage dauert.
Umschließe Abschnitte mit Tags, um sie von der Komprimierung auszunehmen oder ein bestimmtes Verhältnis für den Block zu setzen.
Als unverändert markierter Text wird nicht berechnet, sodass du kritische Anweisungen schützen kannst.
Promptr adressiert ein sehr konkretes Kostenproblem: lange Prompts an Large Language Models werden pro Token abgerechnet, und dieselbe ausführliche Anweisung hunderte Male zu wiederholen, summiert sich schnell. Die API nimmt den Text eines Prompts und gibt eine dichtere, komprimierte Form zurück, die die Bedeutung bewahrt und redundante Formulierungen weglässt. Das Beispiel der Seite komprimiert eine 136-Token-Anweisung über einen KI-Agenten, der eine Spielzeugfirmen-Website entwirft, auf etwa 75 Tokens — laut Anbieter eine Reduktion um 45 %.
Die Integration ist bewusst minimal. Du schickst deinen Prompt als JSON-String per POST an den compress-Endpunkt, mit einem API-Token im Header, und erhältst den komprimierten Text als Klartext zurück. Die Dokumentation enthält fertige Snippets für curl, Python, JavaScript und C#, sodass der Dienst als ein zusätzlicher Schritt vor deinem Modellaufruf eingefügt werden kann. Das Verhalten lässt sich inline über Tags steuern: Text in einem promptr compress="false"-Block bleibt unangetastet und unberechnet, oder du setzt ein explizites Verhältnis wie 0,5 oder 0,8, um zu bestimmen, wie stark ein Abschnitt gekürzt wird.
Die Preisseite stellt den Nutzen als Ersparnis dar. Bei 1 US-Dollar pro 1 Mio. von Promptr verarbeiteter Input-Tokens zeigt sie einen einmaligen gpt-4-turbo-Prompt für 10 US-Dollar ohne Komprimierung gegenüber 7 US-Dollar mit ihr — rund 30 % gespart — sowie größere Einsparungen bei häufiger Wiederverwendung eines Prompts. Der Zugang läuft derzeit über eine Warteliste. Da Komprimierung naturgemäß verlustbehaftet ist und die Ausgabequalität von der Aufgabe abhängt, ist es sinnvoll, Promptr mit eigenen Prompts zu testen, bevor du es breit einsetzt.
Komprimiere ausführliche Anweisungen, die jeder Anfrage vorangestellt werden, und senke die Input-Tokens pro Aufruf durchgängig.
Füge den REST-Aufruf als einen Schritt vor deinem Modellaufruf ein, mithilfe des mitgelieferten Python- oder JavaScript-Snippets.
Prüfe die Ersparnis mit echtem Traffic, um die Kostenwirkung der Komprimierung vor höherer Nutzung abzuschätzen.
Komprimiere Prompts, die über viele Agent-Schritte hinweg wiederverwendet werden, wo der Anbieter die größten prozentualen Einsparungen zeigt.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | Promptr | 0 | 0 % | — | Pay-as-you-go | Aktuell |
| 1 | AiPrice | 2110 | -57,8 % | 39% direkt | Freemium | vs AiPrice |
| 2 | Edgee | 6558 | +96,9 % | 41% direkt | Freemium, Preise auf Anfrage | vs Edgee |
| 3 | Caveman | 171.826 | -15,5 % | 37% direkt | Freemium, Preise auf Anfrage | vs Caveman |
| 4 | Unsloth AI | 887.457 | -17,6 % | 30% direkt | Kostenlos | vs Unsloth AI |
| 5 | IndexInstantly | 11.273 | +579,9 % | 67% direkt | Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs IndexInstantly |
| 6 | Temp Mail Generator (TempMail) | 3375 | -58,6 % | 40% direkt | Freemium | vs Temp Mail Generator (TempMail) |
OpenAI-Prompt-Tokens und Kosten schätzen, bevor Sie die API aufrufen
Agent-Gateway, das LLM-Token-Kosten routet, komprimiert und überwacht

Kostenlos / Open SourceToken-Kosten von KI-Agenten senken – mit wiederherstellbarer Kontextkomprimierung und smartem Modell-Routing
Kostenlos / Open SourceToken-Kosten von KI-Agenten senken – mit wiederherstellbarer Kontextkomprimierung und smartem Modell-Routing
Kostenlos / Open SourceUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
Kostenlos / Open SourceUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
URLs und Backlinks in Minuten in Googles Warteschlange bringen
URLs und Backlinks in Minuten in Googles Warteschlange bringen
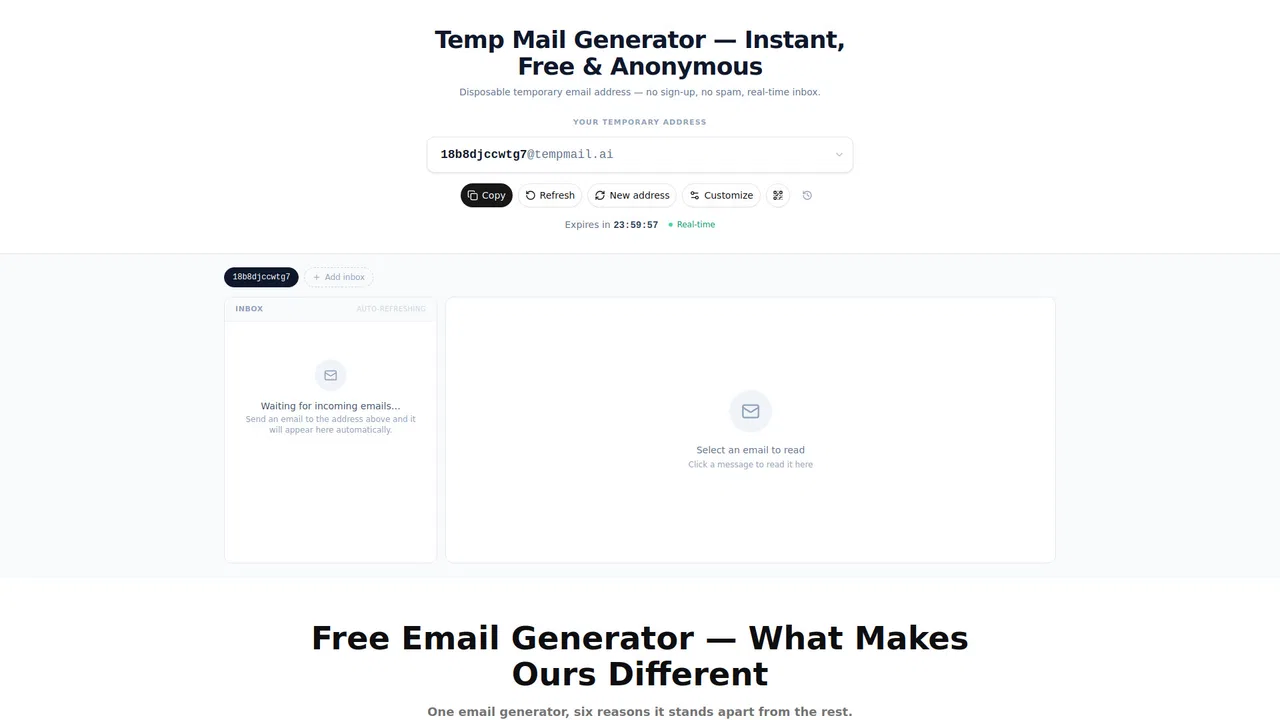
Kostenlose Wegwerf-Mailadressen mit Echtzeit-Postfach und ohne Anmeldung
Kostenlose Wegwerf-Mailadressen mit Echtzeit-Postfach und ohne Anmeldung
Low-Code-Authentifizierungsinfrastruktur mit Login, Sessions, Tokens und KI-Bedrohungserkennung
Low-Code-Authentifizierungsinfrastruktur mit Login, Sessions, Tokens und KI-Bedrohungserkennung

Automatische URL-Indexierung für Google und Bing – ohne Handarbeit
Automatische URL-Indexierung für Google und Bing – ohne Handarbeit
KI-Low-Code-Workflows, die planen und sich anpassen
Representation Engineering für echte Kontrolle über KI-Modelle

Kostenlos / Open SourceEin überprüfbarer API-Schlüssel für Claude, GPT, Kimi und Grok zu einem Bruchteil des Listenpreises
Kostenlos / Open SourceHoncho is an open-source memory layer for AI agents. It ingests messages, indexes them, and runs background reasoning so agents can recall who a user is, what happened before, and what to do next — across sessions, tools, and machines.
Kostenlos / Open SourceHoncho is an open-source memory layer for AI agents. It ingests messages, indexes them, and runs background reasoning so agents can recall who a user is, what happened before, and what to do next — across sessions, tools, and machines.