01
4,9 Mio./Monat
Kostenlose Online-OCR, die jedes Bild in editierbaren Text verwandelt
KI-OCRRedaktionswert: 3.8Freemium+0,8 %

4,9 Mio./Monat+0,8 %
Kostenlose Online-OCR, die jedes Bild in editierbaren Text verwandelt
Freemium
OCR-Helfer, der Screenshots im Browser zu Erkenntnissen macht
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist Screenova (chromewebstore.google.com) eine KI-Plattform, die unter KI-OCR indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0.0%) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Freemium“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Image to Text (4,87 Mio. Besuche/Monat), Sider (2,64 Mio. Besuche/Monat), HARPA AI (537.461 Besuche/Monat).
Zieht schnell Text aus Screenshots, wenn es klappt.
Nach zwei Tagen nur noch Abstürze.
Ganz praktisch.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
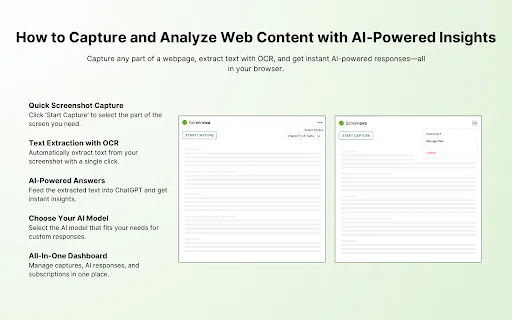
Markiere einen beliebigen Bereich einer Webseite und erfasse ihn direkt aus der Browser-Symbolleiste – ohne separate Desktop-App.
Optische Zeichenerkennung wandelt Screenshots, Bilder und erfasste Seitenbereiche in bearbeitbaren, kopierbaren Text um.
Sende den extrahierten Text an ein KI-Modell und erhalte verständliche Erklärungen, kurze Zusammenfassungen oder verdichtete Kernpunkte.
Verwandle dichte Absätze – Meeting-Notizen, Anleitungen, lange Beiträge – in eine übersichtliche Checkliste der nächsten Schritte.
Wechsle zwischen verschiedenen Chat-Modellstufen, von schnellen leichten Antworten bis zu leistungsfähigerem Reasoning, je nach Aufgabe.
Screenova basiert auf einem einfachen Ablauf: erfassen, lesen, verstehen. Du machst einen Screenshot eines beliebigen Seitenbereichs, die Erweiterung liest den Text per optischer Zeichenerkennung aus dem Bild und übergibt ihn an ein KI-Modell, das Konzepte erklärt, eine Zusammenfassung erstellt oder einen unübersichtlichen Textblock in eine kurze Aufgabenliste verwandelt. Es ist die Art von Werkzeug, die Reibung bei Recherche, Lernen und Informationsverarbeitung still reduziert.
Da sie in der Browser-Symbolleiste sitzt, funktioniert sie auf nahezu jeder Website: technische Dokumentation, in einen Chat eingefügte Vorlesungsfolien, ein gescannter Beleg oder ein langer Thread, der verdichtet werden soll. Die Store-Seite nennt die Auswahl unter bekannten Chat-Modellen (ChatGPT 3.5 und 4 werden genannt), sodass du je nach Aufgabe zwischen schnellen Antworten und stärkerem Reasoning wählen kannst. Alles läuft über einen einzigen Erfassungsvorgang ohne komplexe Oberfläche, weshalb die Lernkurve nahezu null ist.
Das Projekt wird unabhängig vom Screenova.app-Team gepflegt, erhebt laut eigener Angabe keine Verkaufsdaten von Nutzern und beschränkt die Erfassung auf Website-Inhalte. Die Nutzerbasis ist klein und es gibt noch keine Bewertungen, weshalb es eher als praktisches Hilfsmittel denn als schwergewichtiges Unternehmenswerkzeug zu sehen ist. Die Versionshistorie ist kurz, aber der Store-Eintrag ist weiterhin veröffentlicht und installierbar.
Erfasse Folien oder Buchseiten am Bildschirm, extrahiere den Text und erhalte eine Zusammenfassung zum Wiederholen.
Fasse lange Artikel, Papers oder Dokumentationen zusammen, ohne Absätze in eine andere App zu kopieren.
Erfasse einen Chat- oder E-Mail-Verlauf und mache daraus in Sekunden eine kurze Aufgabenliste.
Erfasse einen Fehler, ein Dashboard oder eine Oberfläche und lass die KI in einfacher Sprache erklären, was sie bedeuten.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | Screenova | 0 | — | — | Freemium | Aktuell |
| 1 | Image to Text | 4,87 Mio. | +0,8 % | 25% direkt | Freemium | vs Image to Text |
| 2 | Sider | 2,64 Mio. | -10,6 % | 64% direkt | Freemium | vs Sider |
| 3 | HARPA AI | 537.461 | +99,3 % | 76% direkt | Freemium | vs HARPA AI |
| 4 | AnswersAi | 61.703 | +22,6 % | 35% direkt | Kostenpflichtig | vs AnswersAi |
| 5 | Bild-zu-Text-Konverter | 181.470 | -15,6 % | 46% direkt | Freemium | vs Bild-zu-Text-Konverter |
| 6 | Image to Text CC | 308.299 | +0,6 % | 21% direkt | Freemium | vs Image to Text CC |
Kostenlose Online-OCR, die jedes Bild in editierbaren Text verwandelt
Kostenlose Online-OCR, die jedes Bild in editierbaren Text verwandelt
KI-Seitenleiste und Browser-Agent für Lesen, Schreiben und Recherche
KI-Seitenleiste und Browser-Agent für Lesen, Schreiben und Recherche
Ein Browser-Agent, der alle großen KI-Modelle mit Web-Automatisierung vereint

Aufgabe fotografieren, Antwort sofort erhalten
Aufgabe fotografieren, Antwort sofort erhalten

SpezialisiertKostenlose Online-OCR, die Fotos, Screenshots und Scans in editierbaren Text verwandelt
SpezialisiertKostenlose Online-OCR, die Fotos, Screenshots und Scans in editierbaren Text verwandelt

Kostenloses Online-OCR, das Bilder und Scans in editierbaren Text verwandelt
Kostenloses Online-OCR, das Bilder und Scans in editierbaren Text verwandelt
Zusammenfassen, speichern und schreiben mit KI direkt im Browser
Zusammenfassen, speichern und schreiben mit KI direkt im Browser
SpezialisiertEditierbaren Text per OCR aus Bildern, Scans und Handschrift gewinnen
SpezialisiertEditierbaren Text per OCR aus Bildern, Scans und Handschrift gewinnen
Kostenloses Online-KI-OCR für Bilder, Tabellen und PDFs
Ein-Klick-KI-Assistent für Browser, Texte und Recherche
Ein-Klick-KI-Assistent für Browser, Texte und Recherche

All-in-One-KI-Assistent für Web, Browser, Desktop und Mobilgeräte
All-in-One-KI-Assistent für Web, Browser, Desktop und Mobilgeräte

Jedes Bild per KI beschreiben – ausführliche Beschreibungen, Captions, Prompts und Textextraktion an einem Ort
Jedes Bild per KI beschreiben – ausführliche Beschreibungen, Captions, Prompts und Textextraktion an einem Ort


