Einheitliche Observability, Security und Incident Response für Engineering-Teams im Cloud-Maßstab

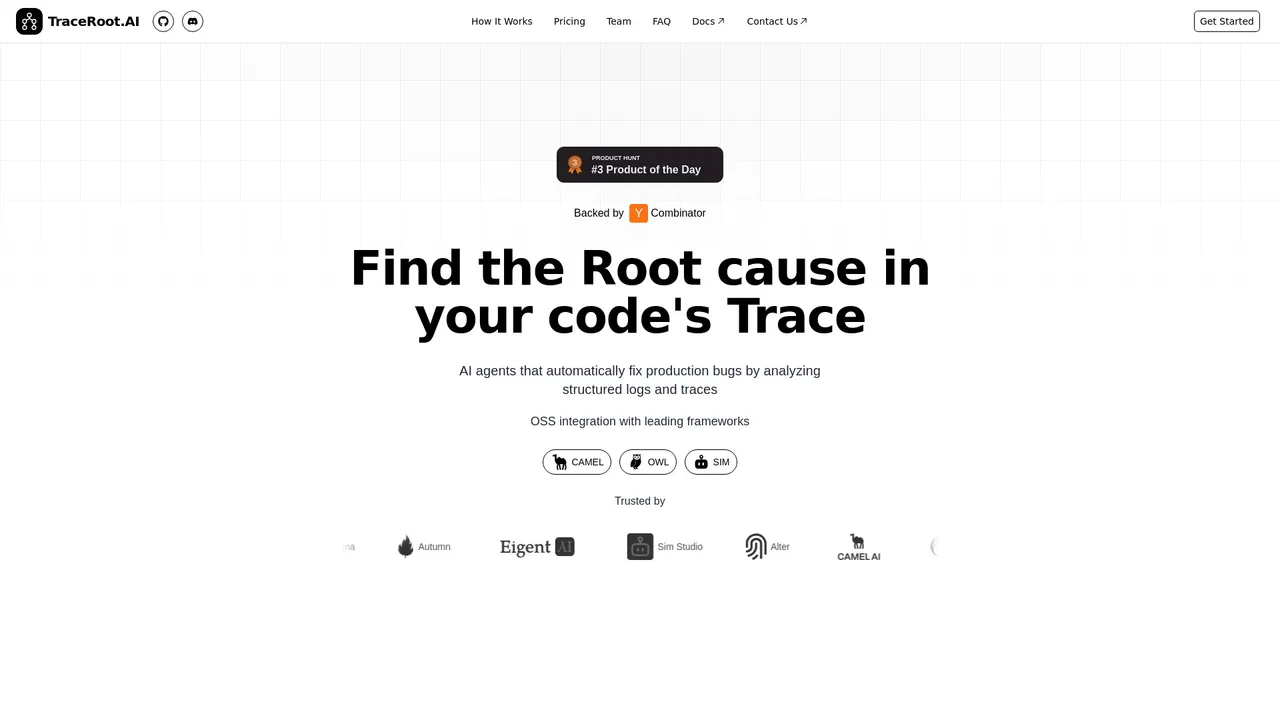
TraceRoot is an open-source, Y Combinator-backed observability platform that continuously improves AI agents using evidence from real production traffic. It traces every model and tool call, detects failing runs with LLM judges, groups them into root-cause signals, and lets a background coding agent reproduce and patch bugs against your GitHub repo.
Geschätzte monatliche Website-Besuche
Similarweb-Schätzungen für diese Domain, keine aktiven Nutzer. Nur Monate mit Beobachtungen werden gezeigt; Erfassungsdatum und Messzeitraum sind getrennt.
Erfasst am 11.11.2026

Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist TraceRoot (traceroot.ai) eine KI-Plattform, die unter KI-Entwicklertools indexiert ist und 2070 monatliche Besuche mit einem Traffic-Delta von -2484 (-54,5 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Vereinigte Staaten (100 % Traffic-Anteil) und sie arbeitet mit einem Preismodell „Free + Paid“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Datadog (5,18 Mio. Besuche/Monat), Raindrop (42.807 Besuche/Monat), Arize AI (249.028 Besuche/Monat).
Endlich eine Observability-Plattform die für Agenten Sinn macht, TraceRoot fängt Silent Failures extrem gut ab.
Setup mit Python SDK ging super schnell, spart jede Menge manuelle Logs.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Capture every model call, tool call, and response with inputs, outputs, latency, and cost in a timeline view.
Define good behavior with LLM judges that flag failing runs, then cluster recurring failures into root-cause signals.
An agent reproduces failures in a sandbox connected to your GitHub repo and proposes patches down to the commit, file, and line.
Run evals against golden datasets, compare versions, and catch regressions before merging.
Deploy the full stack with Docker, use native Python and TypeScript SDKs, and keep everything on OpenTelemetry.
TraceRoot is an open-source, Y Combinator-backed observability platform that continuously improves AI agents using evidence from real production traffic. It traces every model and tool call, detects failing runs with LLM judges, groups them into root-cause signals, and lets a background coding agent reproduce and patch bugs against your GitHub repo.
Find the runs where the agent claimed success but actually failed, and trace them back to the exact tool call or prompt that broke.
Measure success rate, latency, and cost per agent version and catch quiet drift after each deploy.
Turn production signals into verified patches routed through your coding agent and validated with evals.
Instrument a generic agent with the TraceRoot CLI, install the SDK, and get traces flowing in minutes.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | TraceRoot | 2070 | -54,5 % | 39% direkt | Free + Paid | Aktuell |
| 1 | Datadog | 5,18 Mio. | -4,8 % | 53% direkt | Freemium, Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage, Kostenlos | vs Datadog |
| 2 | Raindrop | 42.807 | -18,4 % | 55% direkt | Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs Raindrop |
| 3 | Arize AI | 249.028 | +3,2 % | 43% direkt | Kostenpflichtig, Preise auf Anfrage | vs Arize AI |
| 4 | honeyhive.ai | 8835 | -52,5 % | 79% direkt | Freemium, Preise auf Anfrage | vs honeyhive.ai |
| 5 | Superlog | 1313 | -75,2 % | 39% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage, Kostenlos | vs Superlog |
| 6 | Middleware | 35.967 | -12,3 % | 25% direkt | Freemium, Preise auf Anfrage | vs Middleware |
Einheitliche Observability, Security und Incident Response für Engineering-Teams im Cloud-Maßstab

Fehler in deinen KI-Agenten finden und beheben, bevor Nutzer sie sehen

Kostenlos / Open SourceAgent-Observability, Evaluation und kontinuierliche Verbesserung für Produktions-KI

AI-Agenten im Produktivbetrieb beobachten, bewerten und überwachen

Kostenlos / Open SourceObservability für das KI-Zeitalter: fehlende Telemetrie finden und Produktionsfehler beheben
Full-Stack-Observability mit KI-SRE-Agent, der Probleme mitbehebt

Kostenlos / Open SourceMaxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.

Kostenlos / Open SourceOpen-Source-Observability, die die Fehler deines KI-Agenten findet — und behebt

Kostenlos / Open SourceSelbstverbessernde KI-Agenten bauen, simulieren, evaluieren und überwachen

LLM-Evaluation, Observability und Red Teaming unternehmensweit standardisieren

Die Kollaborationsschicht für KI-Engineering-Teams

Verfolge, evaluiere und liefere KI-Modelle und Agenten in einer verbundenen Umgebung.