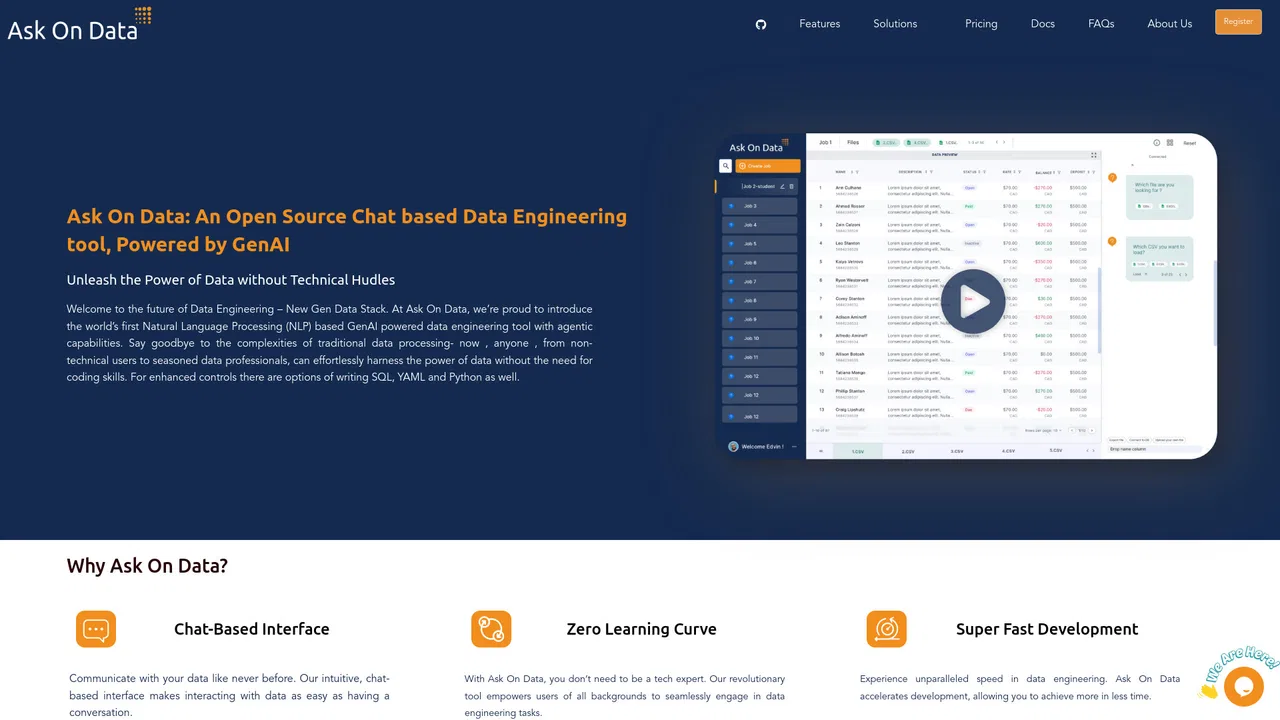
Ask On Data apunta a la parte de la ingeniería de datos que históricamente ha exigido más ceremonia: pasar de una petición de negocio a un pipeline que funcione. En lugar de cablear transformaciones a mano, escribes lo que necesitas en lenguaje natural y un agente convierte esa intención en un pipeline estructurado, mostrando una vista previa en vivo de los datos tras cada instrucción. Además del chat acepta SQL, Python y ediciones directas de YAML, así que los equipos no quedan encajonados cuando una transformación requiere precisión.
La plataforma está construida sobre Python y React, y los pipelines que genera son trabajos de Apache Spark que se pueden orquestar y programar. Entre los componentes de apoyo figuran Langchain, Ollama y Airbyte. Los trabajos se pueden lanzar a mano o programar con una frecuencia fija usando semántica de carga completa, incremental o truncate-and-load, y el historial completo de acciones ofrece trazabilidad además de deshacer cualquier paso.
Ask On Data se ofrece como proyecto de código abierto y también como servicio gestionado en la nube; la opción gestionada elimina el trabajo de infraestructura y mantenimiento y permite desplegar en la nube que elijas. El proveedor lo posiciona como un ahorro considerable frente a stacks tradicionales de ingeniería de datos, en gran medida porque los pipelines se escriben en una fracción del tiempo habitual. Los casos de uso documentados abarcan integración de datos como joins y unions, limpieza, preparación, cálculos personalizados y trabajo de transformación más amplio.