01
HigressCódigo abierto
13,3 mil/mes
Gratis / Código abiertoGateway de IA de código abierto para APIs LLM, agentes y servidores MCP
AI APINota editorial: 4.6Precio a consultar39% directo
Orquestación de inferencia LLM distribuida y de código abierto para tu propia flota
Visitas web mensuales estimadas
Estimaciones de Similarweb para este dominio, no usuarios activos. Solo se muestran meses con observaciones; la fecha de recopilación es distinta del periodo medido.
Recopilado el 11 nov 2026
Es la valoración de nuestro equipo editorial sobre 5, no una media de opiniones de usuarios. Los puntos de vista de esta página los redacta una IA a partir de lo que sabemos del producto. No son reseñas de clientes.
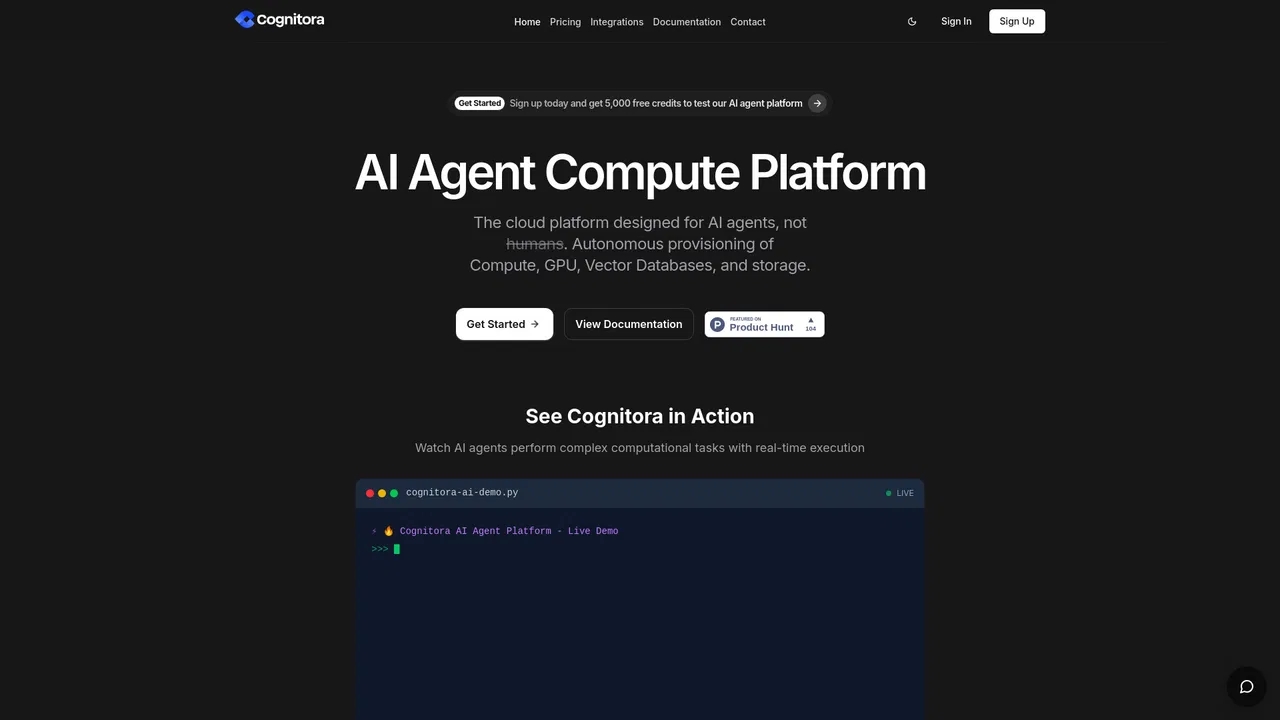
Según la telemetría de OpenAITools.app verificada el 2026-11-11, Cognitora (cognitora.dev) es una plataforma de IA indexada en AI Agent que genera 0 visitas mensuales con una variación de tráfico intermensual de +0 (0.0%). Su principal mercado geográfico es Global (— de cuota de tráfico), y opera con un modelo de precios Open Source. Entre las principales alternativas competidoras por volumen mensual se incluyen Higress (13,32 mil visitas/mes), FlexAI (44,31 mil visitas/mes), RunPod (2,88 M visitas/mes).
El enrutamiento por caché de prefijos es una auténtica maravilla para agilizar clústeres vLLM.
Instalación limpia y rendimiento brutal.
Perspectivas sintetizadas por IA a partir de la inspección del sitio, precios y comparativas de categoría; no son testimonios individuales de clientes.
Envía cada petición al nodo cuya caché contiene el prefijo de prompt coincidente más largo, usando la coincidencia de prefijo de digests BLAKE3 para evitar trabajo de prefill repetido.
Una única API compatible con OpenAI delante de vLLM, SGLang, llama.cpp, Apple MLX y un controlador de TRT-LLM, de modo que puedes mezclar motores en un mismo clúster.
Ejecuta prefill y decode en grupos de réplicas separados con cesión de KV mediante NixlConnector, permitiendo que cada fase use el hardware más adecuado.
Incorpora lecturas de potencia Redfish y NVML a la puntuación de enrutamiento, aplica límites suaves de vatios por nodo y drena nodos calientes de forma automática para reducir la energía por token.
Se despliega como seis binarios estáticos bajo systemd sin Kubernetes, o con un operador kube-rs opcional que expone los CRD InferenceCluster, ModelPool y RoutingPolicy.
Cognitora es una capa de orquestación de código abierto para inferencia distribuida de grandes modelos de lenguaje, escrita en Rust. En lugar de ofrecer un único motor de inferencia, une los motores que ya operas —vLLM, SGLang, llama.cpp, Apple MLX, un controlador de arranque de TRT-LLM y su propio motor en vista previa cgn-infer— en un solo clúster tras una única pasarela compatible con OpenAI. Puede desplegarse en lugar de un orquestador como NVIDIA Dynamo, y el proyecto se posiciona por admitir más motores, funcionar en bare metal sin Kubernetes, incorporar el consumo eléctrico a la planificación y prescindir de un plano de control en Python.
Su innovación central es el enrutamiento consciente de KV. El enrutador puntúa los nodos por la mayor coincidencia de prefijo de digests BLAKE3 encadenados, usando las declaraciones de caché que los agentes informan en sus latidos. En ejecuciones reales de llama.cpp, el enrutador añadió entre 0,9 y 2,0 ms en p50. Más allá del enrutamiento, la plataforma separa el prefill del decode en grupos de réplicas distintos (cediendo la caché KV mediante NixlConnector), mantiene una caché KV multinivel en RAM/SSD con recuperación QUIC entre nodos y ofrece backends de descarga intercambiables como nixl, lmcache, hicache y kvbm.
El stack es modular: cgn-router para el enrutamiento, cgn-agent para supervisar los motores de cada nodo, cgn-kvcached para la caché por niveles, cgn-metrics para Prometheus y telemetría de potencia Redfish/NVML, cgn-ctl como CLI de administración, un operador de Kubernetes opcional y un motor nativo en vista previa. La planificación consciente de la energía drena nodos calientes, un autoescalador en lazo cerrado reacciona a las lecturas de potencia y el descubrimiento por gossip elimina la necesidad de etcd. En seguridad incluye mTLS opcional, versiones con suma de comprobación SHA-256 y autenticación OIDC o por claves de API con alcance. El proyecto ofrece seis binarios estáticos para instalaciones con systemd, charts de Helm para Kubernetes y un panel de clúster en un solo archivo HTML que visualiza rendimiento, percentiles de latencia, uso de KV y julios por token sin necesidad de Grafana.
Coloca un único endpoint compatible con OpenAI delante de nodos vLLM, llama.cpp y MLX para que las aplicaciones dejen de preocuparse por qué motor sirve cada modelo.
Usa enrutamiento consciente de KV y caché multinivel para dejar de reprocesar los mismos prompts en varios nodos y mejorar el rendimiento del hardware existente.
Empieza en unos pocos DGX Spark, equipos AMD o Mac Studio con systemd y binarios estáticos, y añade federación QUIC cuando superes un solo rack.
Aplica admisión y autoescalado conscientes de la potencia para que los nodos ocupados cedan tráfico y la flota opere cerca de su punto óptimo de eficiencia.
Comparación de telemetría lado a lado de herramientas de IA competidoras en la misma categoría principal
| Posición | Herramienta de IA | Visitas mensuales | Crecimiento intermensual | Cuota de tráfico directo | Precios | Comparativa directa |
|---|---|---|---|---|---|---|
| ● | Cognitora | 0 | — | — | Open Source | Actual |
| 1 | Higress | 13,32 mil | -17,9 % | 39% directo | Precio a consultar | vs Higress |
| 2 | FlexAI | 44,31 mil | +17,9 % | 37% directo | Freemium, De pago, Precio a consultar | vs FlexAI |
| 3 | RunPod | 2,88 M | +5,9 % | 57% directo | De pago | vs RunPod |
| 4 | Salad | 713,52 mil | +10,4 % | 62% directo | Prueba gratuita, De pago, Precio a consultar | vs Salad |
| 5 | boat | 66,87 mil | +520,8 % | 56% directo | Prueba gratuita, De pago | vs boat |
| 6 | Browser Use | 1,21 M | +41,1 % | 52% directo | Freemium, De pago, Precio a consultar | vs Browser Use |
Gratis / Código abiertoGateway de IA de código abierto para APIs LLM, agentes y servidores MCP
Gratis / Código abiertoConstruye, ejecuta y escala IA, desde modelos abiertos hasta agentes gobernados
RunPod is a cloud platform for AI and machine learning workloads that rents GPU compute by the second. It offers Pods for persistent GPU instances, Serverless endpoints that autoscale inference from zero, and multi-node Clusters, plus a Hub of ready-to-deploy open-source models and templates.
RunPod is a cloud platform for AI and machine learning workloads that rents GPU compute by the second. It offers Pods for persistent GPU instances, Serverless endpoints that autoscale inference from zero, and multi-node Clusters, plus a Hub of ready-to-deploy open-source models and templates.

Gratis / Código abiertoNube de GPU distribuida que orquesta las GPU de consumo inactivas del mundo
Gratis / Código abiertoNube de GPU distribuida que orquesta las GPU de consumo inactivas del mundo

Gratis / Código abiertoVM de Ubuntu persistentes en la nube para fábricas de agentes de IA
Gratis / Código abiertoAgentes de navegador y navegadores en la nube sigilosos
Gratis / Código abiertoAgentes de navegador y navegadores en la nube sigilosos
Gratis / Código abiertoRivet is open-source infrastructure for running and scaling AI agents as "Actors" — durable, stateful compute units that live inside your own Node.js or Bun backend. Each Actor keeps persistent state, a filesystem, and a SQLite database, so agents survive restarts, share state, and run code written at runtime without a redeploy. Rivet ships as a single stateless Rust binary and can be self-hosted, run in your VPC, or used through a managed cloud.
Gratis / Código abiertoRivet is open-source infrastructure for running and scaling AI agents as "Actors" — durable, stateful compute units that live inside your own Node.js or Bun backend. Each Actor keeps persistent state, a filesystem, and a SQLite database, so agents survive restarts, share state, and run code written at runtime without a redeploy. Rivet ships as a single stateless Rust binary and can be self-hosted, run in your VPC, or used through a managed cloud.
Gratis / Código abiertoEntornos de desarrollo en la nube autoalojados y agentes de código con IA para empresas

Gratis / Código abiertoTogether AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.
Gratis / Código abiertoTogether AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.
Gratis / Código abiertoInfraestructura cloud serverless para cargas de trabajo de IA y datos
Gratis / Código abiertoInfraestructura cloud serverless para cargas de trabajo de IA y datos

Gratis / Código abiertoInfraestructura cloud nativa para agentes que deja que los agentes de código gestionen todo el backend
Nebius is an AI-focused cloud platform that gives teams non-virtualized NVIDIA GPU clusters, managed MLOps tooling, and a serverless inference layer so they can move from experiment to production on one stack.
Nebius is an AI-focused cloud platform that gives teams non-virtualized NVIDIA GPU clusters, managed MLOps tooling, and a serverless inference layer so they can move from experiment to production on one stack.


