01
ExaOficial
1,1 M/mes
API de búsqueda web y crawler creado para agentes de IA
AI APINota editorial: 4.5Freemium, Precio a consultar+16,8 %

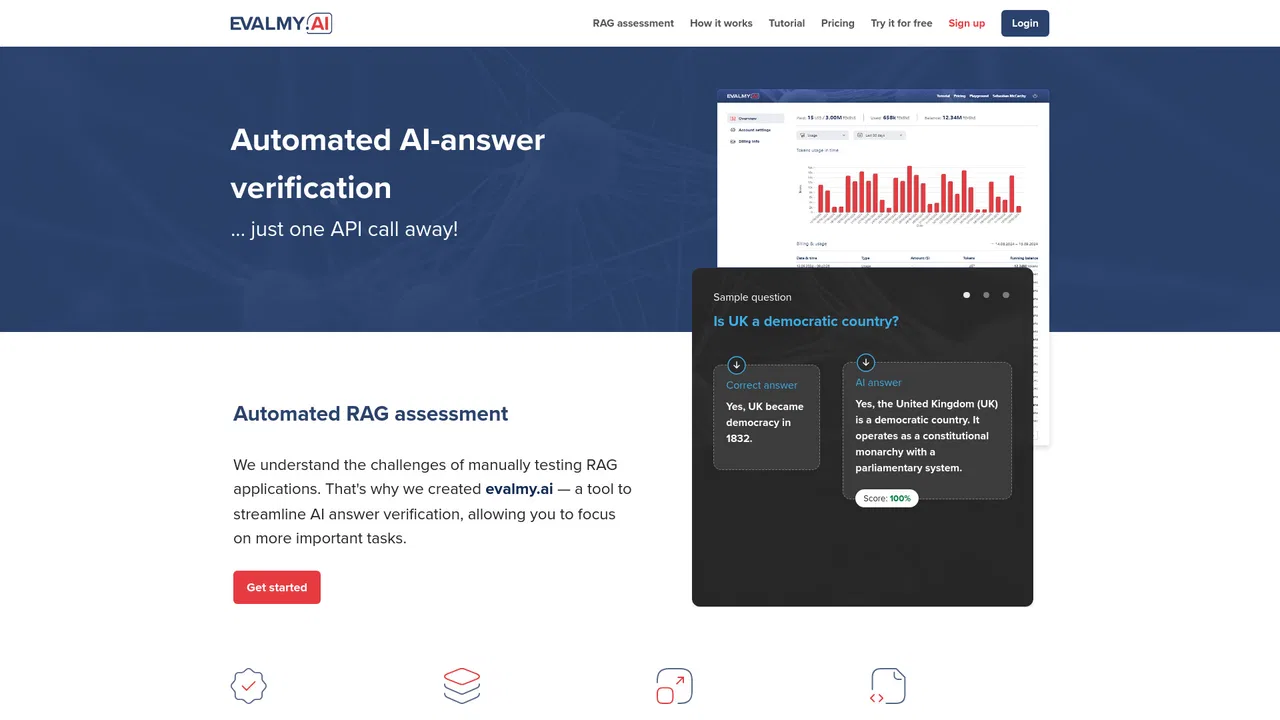
Verificación automática de respuestas de IA con una sola llamada a la API
Es la valoración de nuestro equipo editorial sobre 5, no una media de opiniones de usuarios. Los puntos de vista de esta página los redacta una IA a partir de lo que sabemos del producto. No son reseñas de clientes.
Según la telemetría de OpenAITools.app verificada el 2026-11-11, EvalMy.AI (evalmy.ai) es una plataforma de IA indexada en Testing con IA que genera 0 visitas mensuales con una variación de tráfico intermensual de +0 (0 %). Su principal mercado geográfico es Global (— de cuota de tráfico), y opera con un modelo de precios Freemium. Entre las principales alternativas competidoras por volumen mensual se incluyen Exa (1,06 M visitas/mes), Confident AI (83,4 mil visitas/mes), Scale (616,92 mil visitas/mes).
Excelente para evaluar respuestas de LLM.
Muy buena API y SDK en Python.
Perspectivas sintetizadas por IA a partir de la inspección del sitio, precios y comparativas de categoría; no son testimonios individuales de clientes.
Una única métrica equilibrada que combina completitud, corrección y contradicción, de modo que la respuesta se evalúa más allá de la similitud superficial.
Llama al endpoint de evaluación desde cualquier lenguaje o flujo de trabajo e incorpora la verificación de respuestas a los procesos de desarrollo y CI/CD.
Importa el cliente evalmyai, envía pares de respuestas esperada/real y obtén un resultado estructurado directamente en tu código Python.
Validación lista para usar más ajustes de puntuación semántica que permiten adaptar el rigor al perfil de riesgo.
La capacidad crece o se reduce según el número de modelos, el tamaño del conjunto de preguntas y la frecuencia de prueba, sin gestionar infraestructura.
EvalMy.AI es una herramienta de pruebas en la nube creada por el equipo de ciencia de datos de Profinit para equipos que entregan funciones basadas en LLM y en generación aumentada por recuperación (RAG). En lugar de calificar a mano, se envía un par de respuestas esperada y real y se recibe una puntuación. La puntuación la produce el C3-Score, una métrica cualitativa que descompone una buena respuesta en tres aspectos: completitud (no falta ningún dato importante), corrección (no hay información adicional ni inventada, es decir, sin alucinaciones) y contradicción (no hay incoherencias lógicas dentro de la respuesta).
El producto está pensado para integrarse más que para usarse como panel independiente. Una API REST permite llamar al endpoint de evaluación desde cualquier lenguaje o canalización, y un cliente Python oficial permite evaluar pares de respuestas directamente en el código. Como las comprobaciones se ejecutan como simples llamadas a la API, pueden lanzarse automáticamente en cada despliegue, encajando de forma natural en CI/CD y en herramientas de ML populares como LangChain. Las opciones de configuración permiten ajustar los parámetros de puntuación semántica según distintos perfiles de riesgo.
El servicio se ofrece como SaaS que escala según el número de modelos, el tamaño del conjunto de preguntas y la frecuencia de prueba. El precio es por tokens: los primeros adoptantes reciben una gran asignación gratuita de tokens y el uso adicional se vende en pequeños paquetes de recarga.
Puntúa automáticamente un conjunto fijo de preguntas tras cada cambio de modelo o prompt para detectar regresiones antes de que lleguen al usuario.
Comprueba que el contexto recuperado produce respuestas completas, sin alucinaciones ni contradicciones internas en cada despliegue.
Añade un paso de puntuación a la canalización para que la compilación falle cuando la calidad cae por debajo de un umbral definido.
Ejecuta el mismo conjunto de evaluación en configuraciones candidatas y usa las diferencias del C3-Score para decidir qué versión lanzar.
Comparación de telemetría lado a lado de herramientas de IA competidoras en la misma categoría principal
| Posición | Herramienta de IA | Visitas mensuales | Crecimiento intermensual | Cuota de tráfico directo | Precios | Comparativa directa |
|---|---|---|---|---|---|---|
| ● | EvalMy.AI | 0 | 0 % | — | Freemium | Actual |
| 1 | Exa | 1,06 M | +16,8 % | 57% directo | Freemium, Precio a consultar | vs Exa |
| 2 | Confident AI | 83,4 mil | -3,3 % | 35% directo | Freemium, De pago, Precio a consultar | vs Confident AI |
| 3 | Scale | 616,92 mil | +12,5 % | 31% directo | Precio a consultar | vs Scale |
| 4 | Maxim AI | 121,35 mil | +10 % | 32% directo | Contact for Pricing, Free Open Source | vs Maxim AI |
| 5 | AI or Not | 375,86 mil | +12,3 % | 18% directo | Freemium, Precio a consultar | vs AI or Not |
| 6 | Future AGI | 121,74 mil | -7,8 % | 59% directo | Freemium, Usage-based | vs Future AGI |
API de búsqueda web y crawler creado para agentes de IA

Estandariza la evaluación, la observabilidad y el red teaming de LLM en toda la organización
Estandariza la evaluación, la observabilidad y el red teaming de LLM en toda la organización
Scale is an enterprise AI company that supplies the data, evaluation and deployment layers behind production AI. Its Data Engine sources and labels training data for frontier models, its evaluation work benchmarks model capability, and its platform teams help enterprises and governments move AI systems from pilot into real operations.
Scale is an enterprise AI company that supplies the data, evaluation and deployment layers behind production AI. Its Data Engine sources and labels training data for frontier models, its evaluation work benchmarks model capability, and its platform teams help enterprises and governments move AI systems from pilot into real operations.

Gratis / Código abiertoMaxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.
Gratis / Código abiertoMaxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.

API multimodal de detección de IA que identifica imágenes, texto, audio, vídeo y deepfakes sintéticos
API multimodal de detección de IA que identifica imágenes, texto, audio, vídeo y deepfakes sintéticos

Gratis / Código abiertoConstruye, simula, evalúa y monitoriza agentes de IA que se mejoran solos
Gratis / Código abiertoConstruye, simula, evalúa y monitoriza agentes de IA que se mejoran solos

Una base de búsqueda construida con embeddings, rerankers y APIs de lectura
Una base de búsqueda construida con embeddings, rerankers y APIs de lectura

Gratis / Código abiertoObservabilidad, evaluación y gobernanza de agentes para equipos de plataforma de IA
Gratis / Código abiertoObservabilidad, evaluación y gobernanza de agentes para equipos de plataforma de IA

Infraestructura de agentes verificada para sistemas empresariales críticos
Infraestructura de agentes verificada para sistemas empresariales críticos
Una llamada a la API para extraer datos limpios y estructurados de cualquier sitio web
Una llamada a la API para extraer datos limpios y estructurados de cualquier sitio web

Una sola clave API para más de 70 modelos de IA, 1.000+ API de datos y herramientas web

La capa de seguridad para agentes de voz y chat: probar, hacer red team y monitorizar
La capa de seguridad para agentes de voz y chat: probar, hacer red team y monitorizar


