Gratis / Código abiertoCompara precios, funciones y capacidades de modelos de IA en un solo lugar

Leaderboard independiente de LLM: capacidad, precio, velocidad y benchmarks

Es la valoración de nuestro equipo editorial sobre 5, no una media de opiniones de usuarios. Los puntos de vista de esta página los redacta una IA a partir de lo que sabemos del producto. No son reseñas de clientes.
Según la telemetría de OpenAITools.app verificada el 2026-11-11, LLMBoard.ai (llmboard.ai) es una plataforma de IA indexada en Large Language Models (LLMs) que genera 378 visitas mensuales con una variación de tráfico intermensual de +378 (0 %). Su principal mercado geográfico es Estados Unidos (100 % de cuota de tráfico), y opera con un modelo de precios Gratis. Entre las principales alternativas competidoras por volumen mensual se incluyen Countless.dev (787 visitas/mes), Models.dev (200,45 mil visitas/mes), LLM Price Check (8,26 mil visitas/mes).
El mejor sitio para comparar precios y rendimiento de LLMs.
Muy completo y actualizado.
Perspectivas sintetizadas por IA a partir de la inspección del sitio, precios y comparativas de categoría; no son testimonios individuales de clientes.
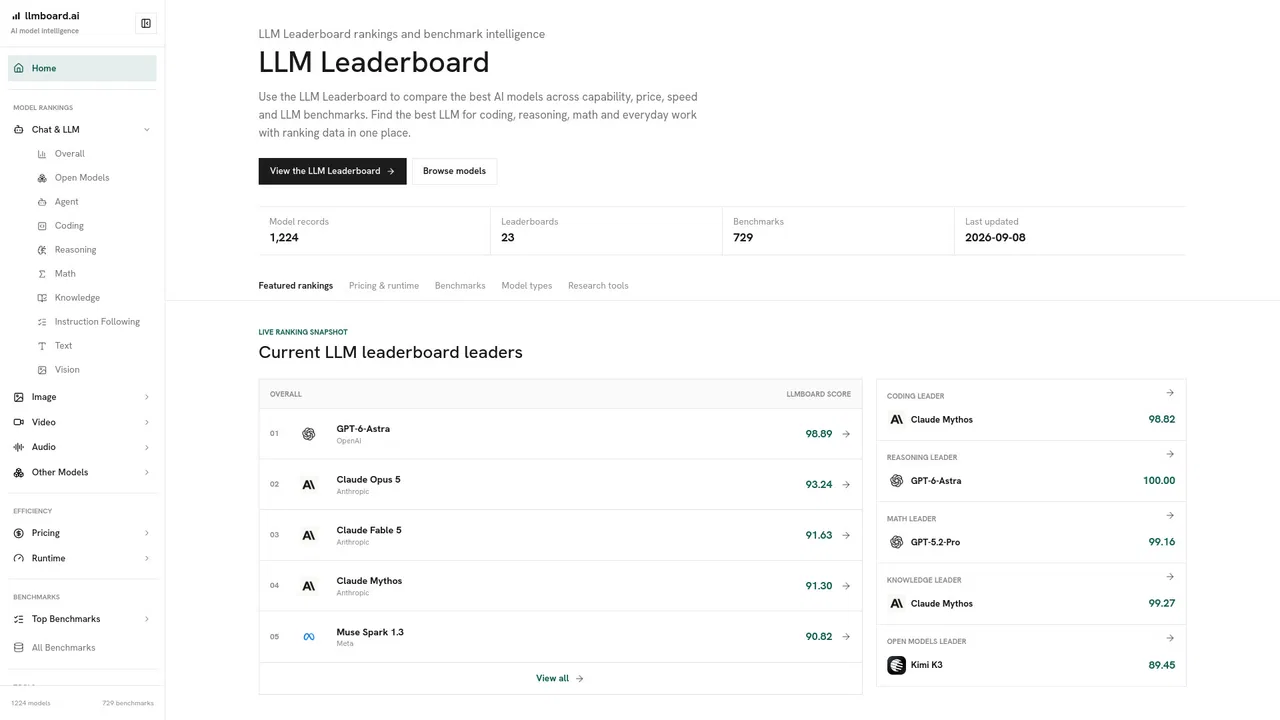
Clasificaciones independientes para chat general, código, razonamiento, matemáticas, conocimiento, seguimiento de instrucciones, tareas de agente, visión, imagen, vídeo, audio y embeddings, para comparar según el trabajo real.
Evaluaciones individuales como GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval y MMMU-Pro, cada una con el orden bruto y detalles de cobertura.
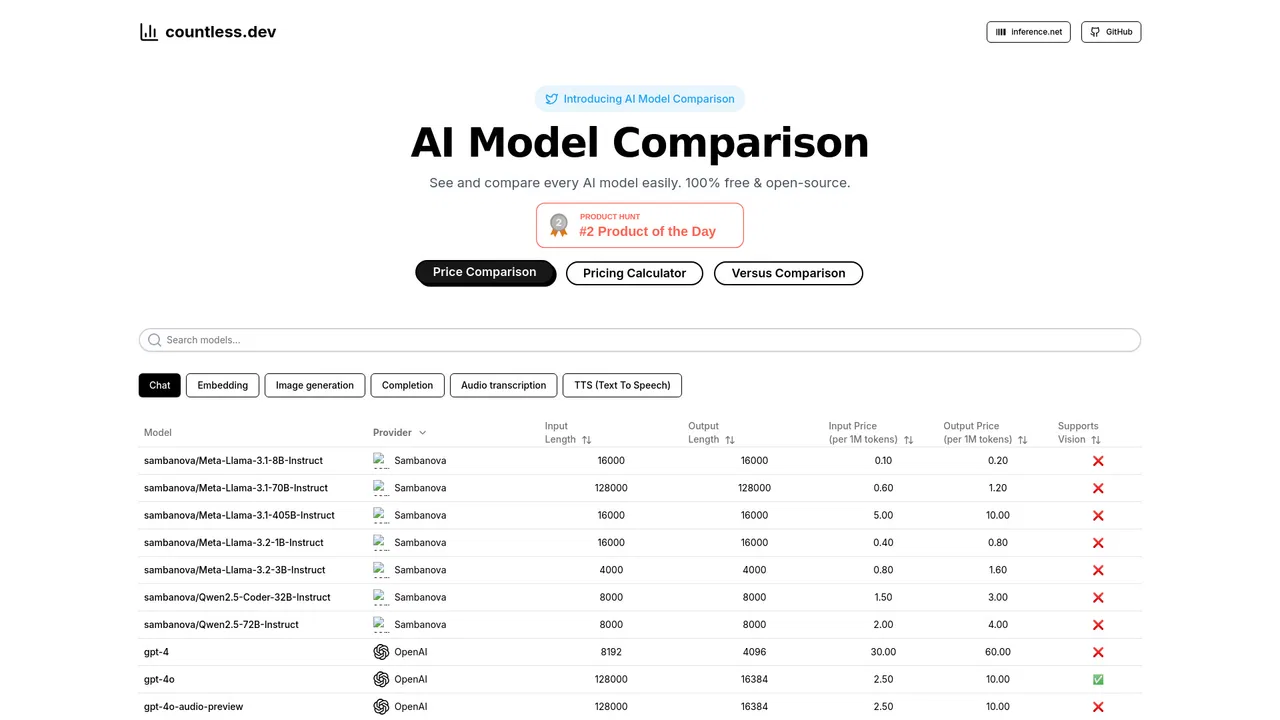
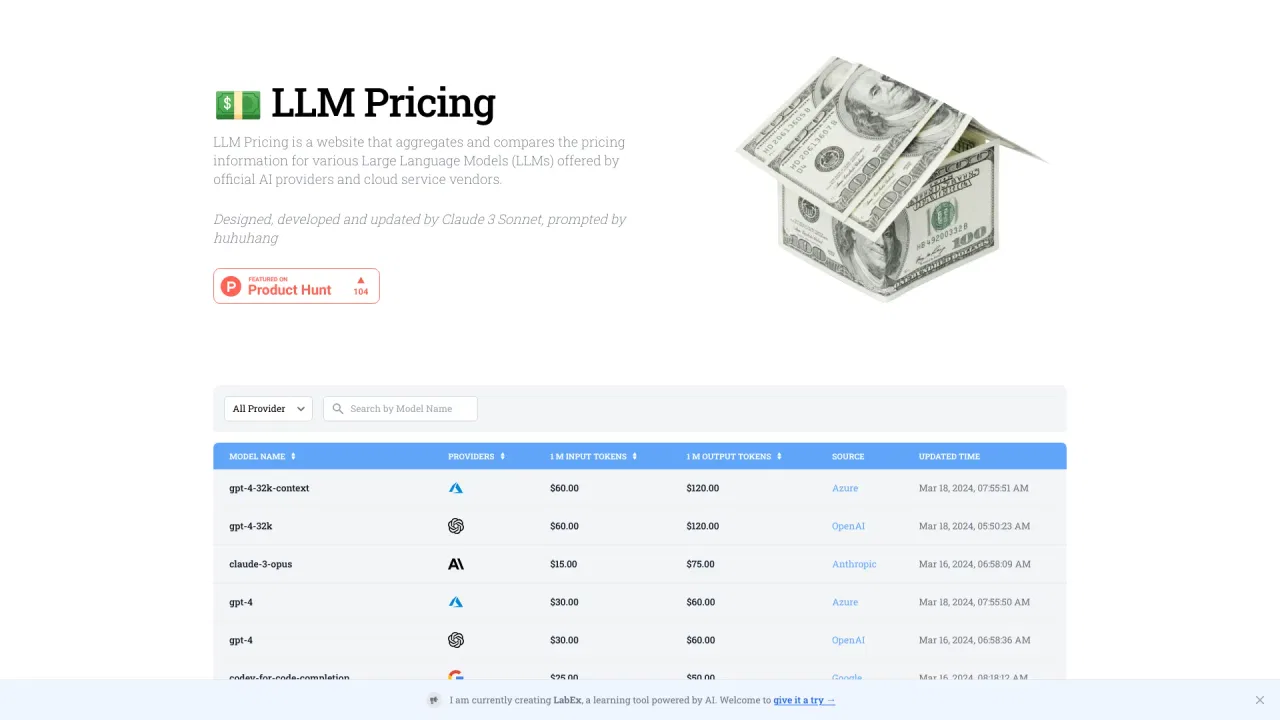
Vistas de precios para tokens de chat, imagen, vídeo y audio, además del eje coste-capacidad para ver dónde el gasto extra realmente mejora la salida.
Rankings de velocidad de salida y latencia junto a señales de fiabilidad del proveedor, cubriendo el lado operativo de la elección de modelo.
Catálogo filtrable por proveedor, tipo, modalidad y precio, con reglas publicadas de puntuación, cobertura y mapeo de modelos para auditar los rankings.
LLMBoard.ai responde a una pregunta que cambia cada pocas semanas: ¿qué modelo deberíamos usar realmente? Mantiene un catálogo de modelos y resultados de benchmarks en actualización continua y lo presenta como leaderboards organizados por tarea: chat y LLM general, agentes, código, razonamiento, matemáticas, conocimiento, seguimiento de instrucciones, además de apartados de visión, generación y edición de imagen, vídeo, texto a voz, voz a texto y embeddings. Cada clasificación se apoya en benchmarks concretos como GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval y MMMU-Pro.
Lo que lo distingue de un ranking de una sola cifra es que separa las señales a propósito. Las puntuaciones de capacidad van aparte del precio, la latencia y la fiabilidad del proveedor, de modo que un modelo líder en un benchmark no se presenta automáticamente como el más rentable o el más estable en producción. Hay páginas de precios dedicadas a tokens de chat, imagen, vídeo y audio, junto con vistas de velocidad y fiabilidad. La sección de puntuación y datos documenta el mapeo y las reglas de puntuación, y cada página de benchmark muestra el orden bruto y la cobertura para poder juzgar la evidencia.
Está dirigido a equipos de ingeniería, product managers e investigadores que evalúan modelos para una carga de trabajo concreta, además de a quien sigue la comparación entre modelos abiertos y propietarios de frontera. Es un recurso de información y comparación: no aloja los modelos, y los resultados deben tomarse como punto de partida para tus propias pruebas.
Filtra el directorio y compara los líderes en código o razonamiento con el precio por token y el rendimiento para elegir un modelo que cumpla calidad y presupuesto.
Usa páginas de benchmarks, notas de cobertura y vistas de precios para justificar la elección ante las partes interesadas en lugar de apoyarte en el marketing del proveedor.
Observa a los líderes de pesos abiertos frente a los modelos propietarios de frontera usando datos de benchmark consistentes y el método de puntuación publicado.
Extrae rankings en vivo, fiabilidad de proveedores y precios por modalidad para respaldar recomendaciones entre API alojadas y modelos abiertos.
Comparación de telemetría lado a lado de herramientas de IA competidoras en la misma categoría principal
| Posición | Herramienta de IA | Visitas mensuales | Crecimiento intermensual | Cuota de tráfico directo | Precios | Comparativa directa |
|---|---|---|---|---|---|---|
| ● | LLMBoard.ai | 378 | 0 % | 33% directo | Gratis | Actual |
| 1 | Countless.dev | 787 | -45,8 % | 40% directo | Gratis | vs Countless.dev |
| 2 | Models.dev | 200,45 mil | -3,9 % | 68% directo | Gratis | vs Models.dev |
| 3 | LLM Price Check | 8,26 mil | -34,7 % | 39% directo | Gratis | vs LLM Price Check |
| 4 | Surge AI | 245,14 mil | +6,6 % | 53% directo | Precio a consultar | vs Surge AI |
| 5 | thisorthis.ai | 2,25 mil | -43,7 % | 39% directo | Gratis | vs thisorthis.ai |
| 6 | ModelFusion | 119 | -88,2 % | 43% directo | Freemium | vs ModelFusion |
Gratis / Código abiertoCompara precios, funciones y capacidades de modelos de IA en un solo lugar

Gratis / Código abiertoBase de datos de código abierto de modelos de IA, precios y capacidades

EspecializadoCompara los precios por token de las principales API de LLM

Datos humanos expertos y evaluación para entrenar IA de frontera

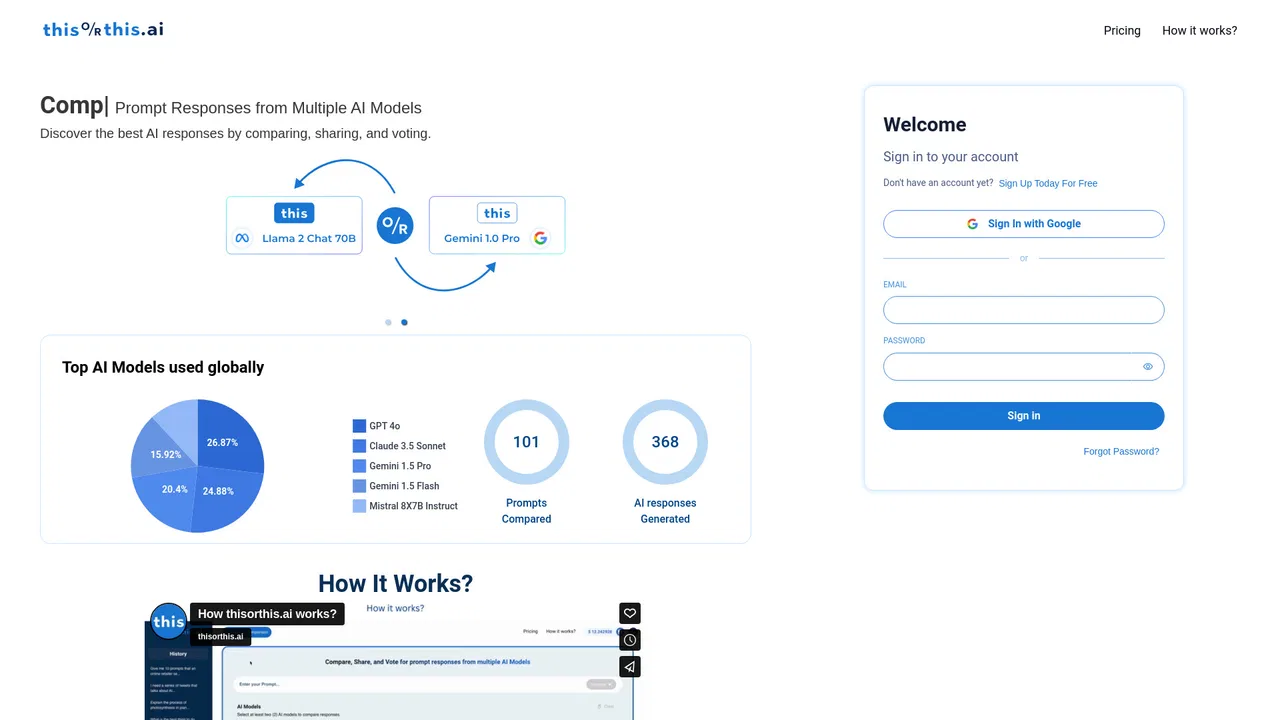
Vota cada mes por la mejor IA y sigue la clasificación en directo

Kit LLM gratuito: calculadoras de coste, prompts y comparación de modelos

Un archivo gratuito de cómo respondió cada modelo de IA a las mismas 100 preguntas

The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
EspecializadoCompara el coste por token de más de 400 modelos de IA

Arena colaborativa donde los modelos de IA compiten y las personas coronan el mejor diseño

Elige tu stack de IA y demuéstralo con trabajo real

Las noticias de IA más relevantes y cómo aplicarlas, en cinco minutos al día