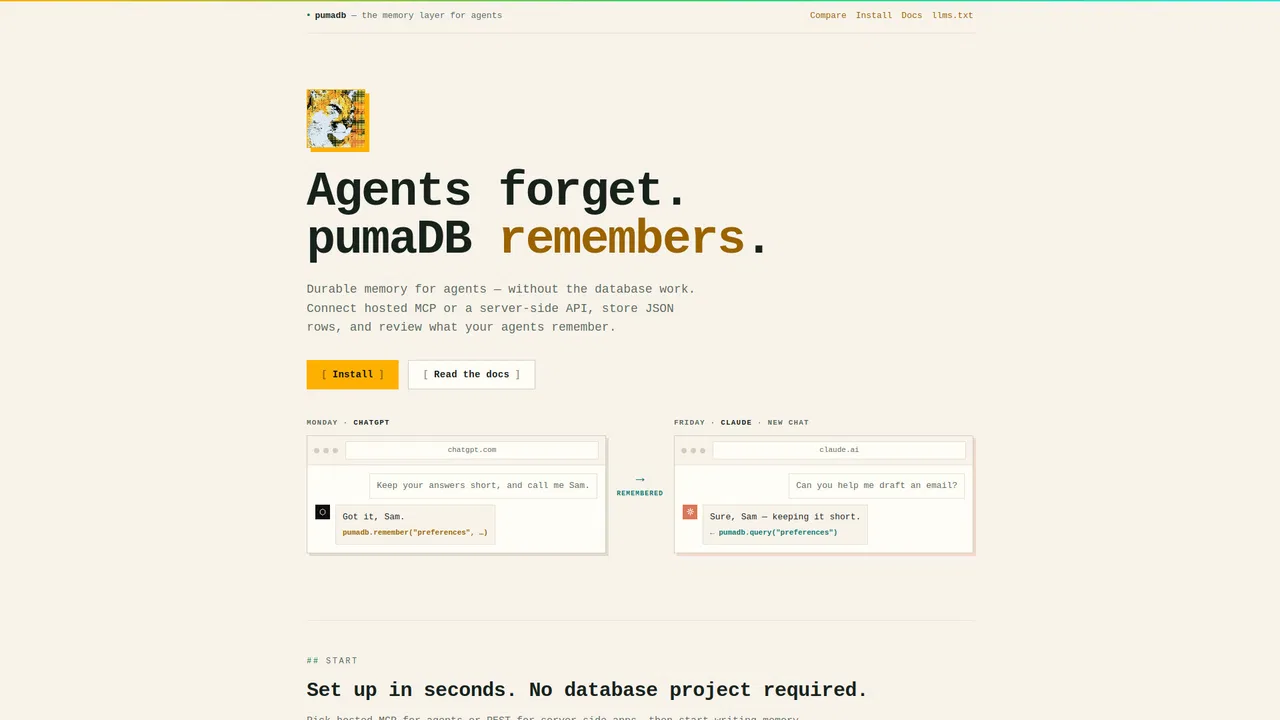
pumaDB resuelve una molestia muy concreta: cada asistente de IA empieza cada conversación con amnesia. Explicas tu stack, tus convenciones y el error que persigues, cierras la pestaña y al día siguiente lo vuelves a explicar todo. pumaDB sustituye ese ritual por un almacén de memoria alojado que vive fuera de cualquier modelo o proveedor concreto. Un dato escrito en una sesión de ChatGPT puede recuperarse en un chat completamente nuevo de Claude, sin pegar nada entre medias.
Por dentro es deliberadamente sencillo. La memoria se guarda en tablas con nombre de pequeños registros estructurados; las categorías que destaca el equipo son convenciones de proyecto, preferencias del usuario, recortes de investigación, estado de tareas, notas de traspaso y referencias técnicas ya revisadas. Se accede a esos datos por dos vías: una API REST con claves bearer para backends, workers, CLI y funciones serverless que tú controlas, y un punto MCP alojado en api/mcp al que Codex, ChatGPT, Claude, OpenClaw y otros clientes HTTP en streaming se conectan mediante inicio de sesión OAuth. Ambas superficies operan sobre las mismas tablas y filas.
El gran argumento es la ausencia de configuración. No hay proyecto de base de datos que aprovisionar, ni migraciones de esquema que vigilar, ni clave de API que pegar en el cliente: el inicio de sesión por correo gestiona OAuth para las conexiones MCP. El servicio lo lleva un equipo pequeño con base en Melbourne y está pensado para personas que quieren que sus agentes recuerden y para equipos que buscan una memoria organizativa compartida.