01
ElevenLabsOficial
42,4 M/mes
Plataforma de audio con IA para voz, agentes, música y doblaje
Generador de voz con IANota editorial: 4.8Freemium, De pago, Precio a consultar+26,1 %

Freemium, De pago, Precio a consultar
Guía independiente y consola de producción para los modelos de voz y música de ByteDance Seed
Es la valoración de nuestro equipo editorial sobre 5, no una media de opiniones de usuarios. Los puntos de vista de esta página los redacta una IA a partir de lo que sabemos del producto. No son reseñas de clientes.
Según la telemetría de OpenAITools.app verificada el 2026-11-11, Seed Audio AI (seedaudioai.ai) es una plataforma de IA indexada en AI API que genera 0 visitas mensuales con una variación de tráfico intermensual de +0 (0 %). Su principal mercado geográfico es Global (— de cuota de tráfico), y opera con un modelo de precios Prueba gratuita, Precio a consultar. Entre las principales alternativas competidoras por volumen mensual se incluyen ElevenLabs (42,4 M visitas/mes), Typecast AI (1,23 M visitas/mes), Meta AI Demos (177,81 mil visitas/mes).
La clonación de voz da miedo de lo real que suena.
Falta más documentación en español.
Perspectivas sintetizadas por IA a partir de la inspección del sitio, precios y comparativas de categoría; no son testimonios individuales de clientes.
Síntesis de voz a gran escala con prosodia natural, control emocional y replicación de voz zero-shot a partir de una breve muestra de referencia.
Reconocimiento automático del habla basado en modelos de lenguaje, diseñado para mantener la precisión entre acentos, idiomas, ruido de fondo y condiciones acústicas diversas.
Composición y edición musical controlada con dirección precisa de estilo, instrumentación y arreglo.
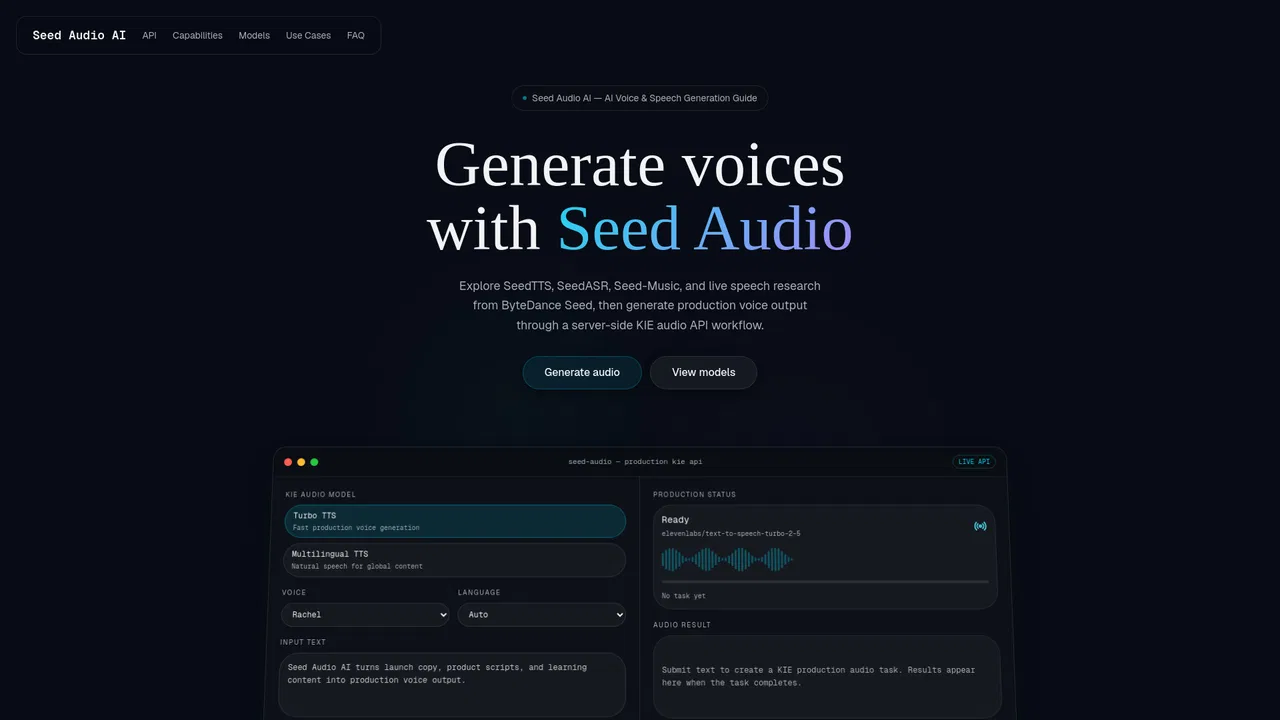
Genera audio de producción desde el navegador con endpoints KIE —Turbo TTS, Multilingual v2, Dialogue v3 y Audio Isolation— manteniendo las claves API en el servidor.
Locutores con nombre como Rachel, Adam o Bella y opciones de idioma que incluyen inglés, mandarín, japonés, español, francés y coreano para contenido global.
Seed Audio AI combina documentación de investigación y herramientas prácticas. Explica qué hace cada modelo de audio de ByteDance Seed —SeedTTS para síntesis de voz y replicación de voces, SeedASR para reconocimiento automático del habla, Seed-Music para composición controlada e Interpretación en vivo para comprensión de voz en tiempo real— y luego permite ejecutar solicitudes de producción reales desde una consola integrada. Las fichas de modelo, una tabla comparativa y el desglose por casos de uso ayudan a elegir el modelo adecuado antes de escribir el primer prompt.
La consola es la mitad práctica del producto. Se elige un estilo de voz (Turbo TTS para rapidez, Multilingual TTS para habla global natural), se selecciona un locutor predefinido como Rachel, Adam, Bella, Antoni o Elli, se define el idioma y se envía un texto de hasta 500 caracteres. Las solicitudes se enrutan por endpoints de la API de audio KIE en el servidor —text-to-speech-turbo-2-5, multilingual v2, dialogue v3 y audio isolation— de modo que las credenciales nunca llegan al navegador.
Al ser una guía independiente, el sitio deja claro que no es una propiedad oficial de ByteDance ni BytePlus y enlaza a fuentes primarias como las páginas de ByteDance Seed Speech, el artículo de Seed-TTS y el informe técnico de Seed-ASR. Desarrolladores, equipos de localización, educadores y creadores lo usan para evaluar las capacidades de audio de Seed y producir voz con rapidez sin montar su propia infraestructura de inferencia. No hay tarifa pública: el acceso gira en torno a una prueba gratuita y acuerdos por contacto para volúmenes mayores.
Produce locuciones y narraciones largas para vídeos, pódcasts y audiolibros, y replica tu propia voz para mantener una identidad de marca coherente entre episodios.
Evalúa SeedTTS y SeedASR para interfaces de voz, dictado y transcripción, usando la consola para prototipar antes de conectar una API empresarial.
Genera voces localizadas con acentos regionales para que apps, e-learning y medios suenen nativos en cada mercado.
Crea lecciones habladas, feedback de pronunciación y materiales accesibles sin reservar un estudio de grabación.
Comparación de telemetría lado a lado de herramientas de IA competidoras en la misma categoría principal
| Posición | Herramienta de IA | Visitas mensuales | Crecimiento intermensual | Cuota de tráfico directo | Precios | Comparativa directa |
|---|---|---|---|---|---|---|
| ● | Seed Audio AI | 0 | 0 % | — | Prueba gratuita, Precio a consultar | Actual |
| 1 | ElevenLabs | 42,4 M | +26,1 % | 44% directo | Freemium, De pago, Precio a consultar | vs ElevenLabs |
| 2 | Typecast AI | 1,23 M | -3,9 % | 53% directo | Freemium | vs Typecast AI |
| 3 | Meta AI Demos | 177,81 mil | +4,3 % | 54% directo | Gratis | vs Meta AI Demos |
| 4 | Murf AI | 519,64 mil | -2,8 % | 44% directo | Freemium | vs Murf AI |
| 5 | Voicemaker | 501 mil | -11,3 % | 21% directo | Freemium, De pago, Precio a consultar | vs Voicemaker |
| 6 | FineVoice | 401,51 mil | -1,2 % | 34% directo | Freemium | vs FineVoice |
Plataforma de audio con IA para voz, agentes, música y doblaje
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.

Prueba demos experimentales de IA directamente de los laboratorios de Meta
Prueba demos experimentales de IA directamente de los laboratorios de Meta
Crea voces IA naturales, agentes de voz y doblaje en una sola plataforma
Crea voces IA naturales, agentes de voz y doblaje en una sola plataforma
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
El estudio de voz con IA todo en uno para locuciones, clonado y audio
El estudio de voz con IA todo en uno para locuciones, clonado y audio
EspecializadoUn paquete de ventajas con créditos gratis y descuentos de decenas de herramientas punteras para desarrolladores de IA
EspecializadoUn paquete de ventajas con créditos gratis y descuentos de decenas de herramientas punteras para desarrolladores de IA

Kit de voz con IA todo en uno para generar, clonar y editar audio
Kit de voz con IA todo en uno para generar, clonar y editar audio

AudioPod AI is a browser-based audio studio that covers text to speech, voice cloning, podcast and audiobook production, music generation, stem separation, transcription and noise removal, with a developer API for embedding the same engine in your own product.
AudioPod AI is a browser-based audio studio that covers text to speech, voice cloning, podcast and audiobook production, music generation, stem separation, transcription and noise removal, with a developer API for embedding the same engine in your own product.
Uberduck is a synthetic voice and audio platform that turns text into speech, singing, and rapping, clones custom voices, and generates full AI music tracks in seconds — with API access for developers and 70+ supported languages.
Uberduck is a synthetic voice and audio platform that turns text into speech, singing, and rapping, clones custom voices, and generates full AI music tracks in seconds — with API access for developers and 70+ supported languages.

Cambiador de voz con IA en tiempo real, clonación y agentes de voz
Cambiador de voz con IA en tiempo real, clonación y agentes de voz
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.


