br-AI-n adopte une approche « local-first ». Plutôt que de transmettre vos requêtes à une API distante, elle télécharge une fois le modèle à poids ouverts dans le cache du navigateur, puis effectue l'inférence dans l'environnement isolé de l'extension via WebAssembly et l'accélération WebGPU, avec un chemin SIMD monothread optimisé en secours sur les machines sans GPU exploitable. Comme tout s'exécute en local, il n'y a ni facturation au token, ni abonnement mensuel, ni clé API à coller.
L'extension réside dans le panneau latéral de Chrome et s'ouvre en un clic depuis n'importe quel onglet. Sélectionnez du texte sur une page pour faire apparaître un widget flottant d'actions rapides : résumé, explication de concepts ou correction grammaticale sans quitter la page, puis poursuivez la conversation dans la carte flottante. Le bouton « joindre le contexte de la page » importe le texte de l'onglet actif directement dans la conversation, ce qui facilite le traitement de longs documents. Les modèles de raisonnement affichent leurs étapes de réflexion de manière dépliable dans l'interface.
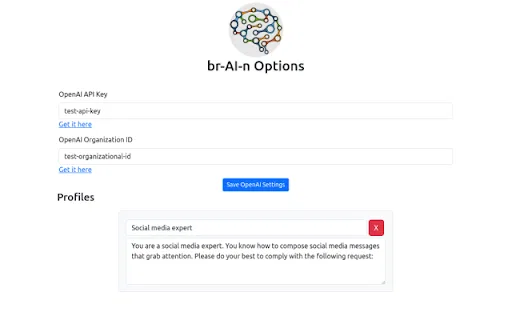
Si vous disposez déjà de votre propre infrastructure d'inférence, br-AI-n peut aussi servir de façade pour des backends locaux comme Ollama, LM Studio et llama.cpp, en déléguant la charge à une machine dédiée tout en conservant l'interface Chrome. Les outils web optionnels (recherche, lecture de l'onglet actif, exécution de code en sandbox) sont désactivés par défaut et protégés par un interrupteur réseau « fail-closed » : l'extension reste donc entièrement hors ligne tant que vous ne les activez pas explicitement. Les personas sont personnalisables via des profils prédéfinis (assistant, code, résumé, traduction, correction grammaticale) et des invites système illimitées.