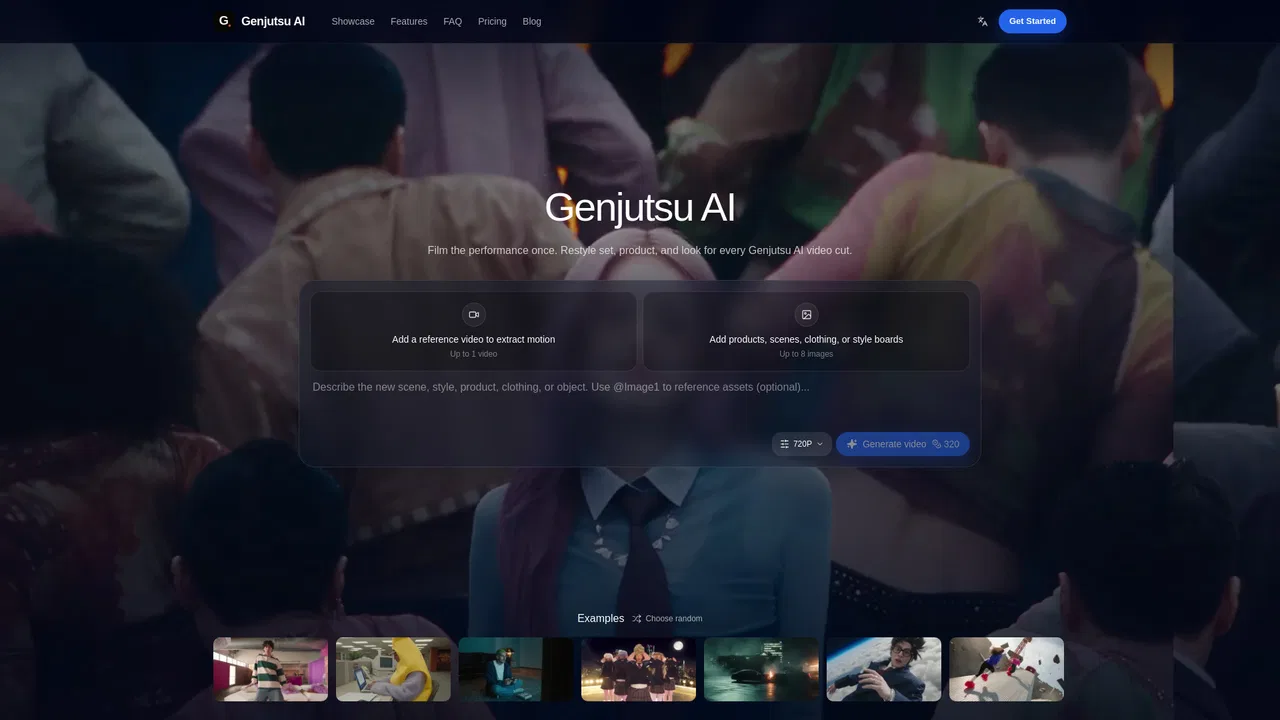
Genjutsu AI adopte une approche différente des générateurs vidéo purement textuels. Au lieu d'inventer chaque image à partir du langage, il traite le mouvement et le timing enregistrés, le trajet de caméra et la performance comme la source de vérité, puis restyle le monde autour de cette prise. Cela le rend adapté aux travaux où la continuité compte : une performance déjà validée, un rythme de danse précis ou un mouvement de caméra verrouillé qui doit survivre à un changement de produit ou de garde-robe.
Une génération typique comporte trois entrées : choisir un template viral (ou télécharger sa propre vidéo de référence, souvent de 4 à 30 secondes avec un mouvement de sujet lisible), ajouter une ou deux photos de qui ou de quoi doit apparaître, et éventuellement rédiger un prompt indiquant quel mouvement et quel timing restent verrouillés et ce qui peut changer. La génération s'exécute directement sur la page d'accueil : connexion, crédits et bibliothèque privée restent au même endroit, et les générations échouées rendent automatiquement les crédits.
Il s'adresse aux personnes dont le goulot d'étranglement est le calendrier, pas les idées. Les marketeurs growth localisent packaging et stylisme de scène à partir d'une prise validée, les créateurs musicaux et de performance tirent plusieurs looks d'un seul template, les créateurs solo améliorent des images tournées au téléphone sans refaire le montage, et les agences partagent une performance verrouillée et itèrent jusqu'à validation du créatif. Le tarif est basé sur des crédits, par abonnement ou packs ponctuels, avec le coût en crédits affiché avant le rendu.