01
2,1 k/mois
Estimez les tokens et le coût de vos prompts OpenAI avant l'appel API
AI APINote de la rédaction : 4.0Freemium39% direct
Compressez les prompts de LLM en un appel REST et réduisez le coût en tokens
C'est l'évaluation de notre rédaction, sur 5, et non une moyenne d'avis d'utilisateurs. Les points de vue de cette page sont rédigés par une IA à partir de ce que nous savons du produit. Ce ne sont pas des avis clients.
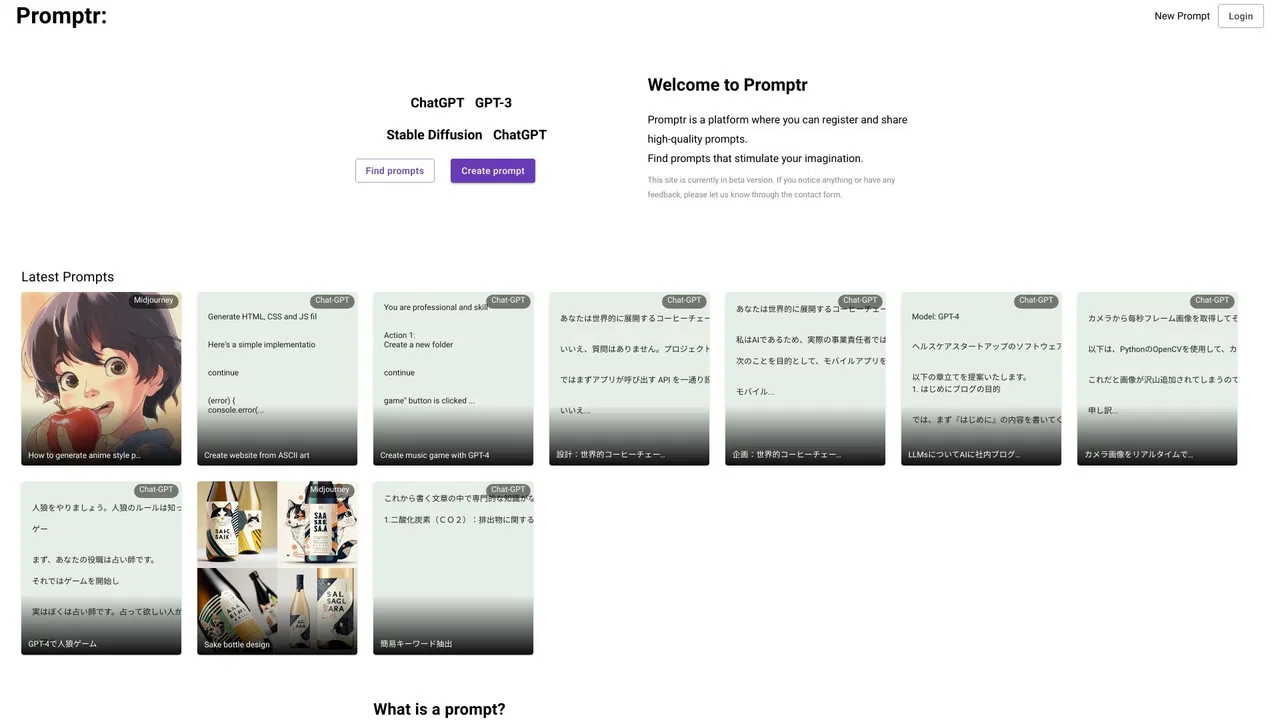
Selon la télémétrie OpenAITools.app vérifiée le 2026-11-11, Promptr (promptr.dev) est une plateforme d'IA indexée sous Autres générant 0 visites mensuelles avec un delta de trafic mensuel de +0 (0 %). Son marché géographique principal est Global (— de part de trafic), et elle fonctionne selon un modèle tarifaire Pay-as-you-go. Les principales alternatives concurrentes par volume mensuel incluent AiPrice (2,11 k visites/mois), Edgee (6,56 k visites/mois), Caveman (171,83 k visites/mois).
Réduit bien les tokens sur les gros prompts.
Faut passer par la liste d'attente, dommage.
Points de vue synthétisés par IA à partir de l’inspection du site, des tarifs et du comparatif catégoriel — il ne s’agit pas d’avis clients individuels.
Envoyez votre prompt à un point de terminaison REST unique et recevez une version plus courte en texte brut, prête pour le modèle.
Le fournisseur annonce jusqu'à 40 % de coût d'entrée en moins, avec un exemple montrant une réduction de 45 % sur un prompt type.
Des exemples prêts à copier sont fournis pour curl, Python, JavaScript et C#, pour une intégration en minutes plutôt qu'en jours.
Encadrez des sections de balises pour les exclure de la compression ou fixer un ratio précis pour ce bloc.
Le texte marqué comme à préserver n'est pas facturé, ce qui permet de protéger des instructions critiques.
Promptr s'attaque à un problème de coût très précis : les prompts longs envoyés aux grands modèles de langage sont facturés au token, et répéter les mêmes instructions détaillées des centaines de fois s'accumule vite. Son API prend le texte d'un prompt et renvoie une forme plus dense et compressée qui conserve le sens tout en supprimant les formulations redondantes. L'exemple du site compresse une instruction de 136 tokens sur un agent IA concevant le site d'une entreprise de jouets jusqu'à environ 75 tokens, présenté comme une réduction de 45 %.
L'intégration est volontairement minimale. Vous envoyez votre prompt en chaîne JSON via POST au point de terminaison compress avec un jeton d'API dans l'en-tête, et recevez le texte compressé en clair. La documentation fournit des extraits prêts à l'emploi pour curl, Python, JavaScript et C#, de sorte que le service s'insère comme une étape supplémentaire avant votre appel au modèle. Vous pouvez aussi piloter le comportement en ligne avec des balises : encadrez du texte dans un bloc promptr compress="false" pour le laisser intact et non facturé, ou fixez un ratio explicite comme 0,5 ou 0,8 pour décider de l'intensité de la réduction.
La page tarifaire présente la valeur en termes d'économies. À 1 dollar par million de tokens d'entrée traités par Promptr, elle illustre un prompt ponctuel gpt-4-turbo coûtant 10 dollars sans compression contre 7 avec, soit environ 30 % d'économies, et davantage lorsqu'un prompt est réutilisé de nombreuses fois. L'accès passe actuellement par une liste d'attente. La compression étant par nature destructive et la qualité de sortie dépendant de la tâche, il est prudent de tester Promptr sur vos propres prompts avant un déploiement large.
Compressez les instructions verbeuses ajoutées à chaque requête, réduisant les tokens d'entrée sur tous les appels.
Insérez l'appel REST comme une étape devant votre appel au modèle, à l'aide de l'extrait Python ou JavaScript fourni.
Mesurez les économies sur du trafic réel pour estimer l'impact sur les coûts avant d'augmenter votre usage.
Compressez les prompts réutilisés sur de nombreuses étapes d'agent, là où le fournisseur affiche les plus fortes économies en pourcentage.
Comparaison télémétrique côte à côte des outils d'IA concurrents dans la même catégorie principale
| Rang | Outil d'IA | Visites mensuelles | Croissance mensuelle | Part du trafic direct | Tarifs | Face à face |
|---|---|---|---|---|---|---|
| ● | Promptr | 0 | 0 % | — | Pay-as-you-go | Actuel |
| 1 | AiPrice | 2,11 k | -57,8 % | 39% direct | Freemium | vs AiPrice |
| 2 | Edgee | 6,56 k | +96,9 % | 41% direct | Freemium, Tarifs sur demande | vs Edgee |
| 3 | Caveman | 171,83 k | -15,5 % | 37% direct | Freemium, Tarifs sur demande | vs Caveman |
| 4 | Unsloth AI | 887,46 k | -17,6 % | 30% direct | Gratuit | vs Unsloth AI |
| 5 | IndexInstantly | 11,27 k | +579,9 % | 67% direct | Essai gratuit, Payant, Tarifs sur demande | vs IndexInstantly |
| 6 | Temp Mail Generator (TempMail) | 3,38 k | -58,6 % | 40% direct | Freemium | vs Temp Mail Generator (TempMail) |
Estimez les tokens et le coût de vos prompts OpenAI avant l'appel API
Passerelle d'agents qui route, compresse et observe vos dépenses de tokens LLM

Gratuit / Open sourceRéduisez le coût en tokens de vos agents IA grâce à la compression récupérable et au routage intelligent des modèles
Gratuit / Open sourceRéduisez le coût en tokens de vos agents IA grâce à la compression récupérable et au routage intelligent des modèles
Gratuit / Open sourceUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
Gratuit / Open sourceUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
Placez URLs et backlinks dans la file d'attente de Google en quelques minutes
Placez URLs et backlinks dans la file d'attente de Google en quelques minutes
Adresses e-mail jetables gratuites avec boîte de réception en temps réel, sans inscription
Adresses e-mail jetables gratuites avec boîte de réception en temps réel, sans inscription
Infrastructure d'authentification low-code avec connexion, sessions, jetons et détection de menaces par IA
Infrastructure d'authentification low-code avec connexion, sessions, jetons et détection de menaces par IA

Indexation automatique d'URL pour apparaître sur Google et Bing
Indexation automatique d'URL pour apparaître sur Google et Bing
Des workflows low-code IA qui planifient et s'adaptent
L'ingénierie des représentations pour vraiment contrôler les modèles d'IA

Gratuit / Open sourceUne clé d'API vérifiable pour Claude, GPT, Kimi et Grok à une fraction du prix officiel
Gratuit / Open sourceHoncho is an open-source memory layer for AI agents. It ingests messages, indexes them, and runs background reasoning so agents can recall who a user is, what happened before, and what to do next — across sessions, tools, and machines.
Gratuit / Open sourceHoncho is an open-source memory layer for AI agents. It ingests messages, indexes them, and runs background reasoning so agents can recall who a user is, what happened before, and what to do next — across sessions, tools, and machines.