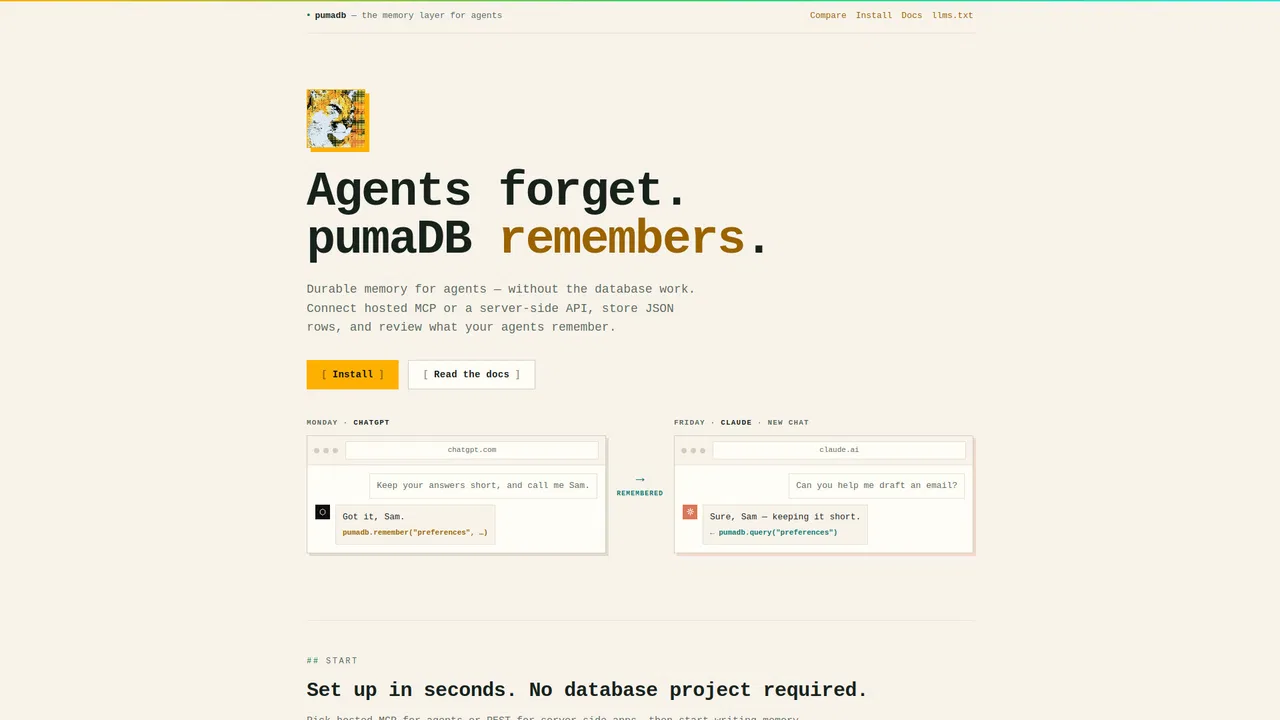
pumaDB répond à un agacement très concret : chaque assistant d'IA démarre chaque conversation avec amnésie. Vous expliquez votre stack, vos conventions et le bug que vous traquez, vous fermez l'onglet, et le lendemain vous recommencez. pumaDB remplace ce rituel par un stockage de mémoire hébergé, indépendant de tout modèle ou fournisseur. Un fait écrit dans une session ChatGPT peut être rappelé dans une conversation Claude toute nouvelle, sans rien coller entre les deux.
En interne, la conception est volontairement simple. La mémoire vit dans des tables nommées contenant de petits enregistrements structurés — les catégories mises en avant par l'équipe sont les conventions de projet, les préférences utilisateur, les extraits de recherche, l'état des tâches, les notes de transmission et les références techniques déjà relues. L'accès se fait par deux voies : une API REST à clés bearer pour les backends, workers, CLI et fonctions serverless que vous contrôlez, et un point de terminaison MCP hébergé sur api/mcp auquel Codex, ChatGPT, Claude, OpenClaw et d'autres clients HTTP en streaming se connectent via une connexion OAuth. Les deux surfaces opèrent sur les mêmes tables et les mêmes lignes.
L'argument principal est l'absence de configuration. Aucun projet de base de données à provisionner, aucune migration de schéma à surveiller, aucune clé d'API à coller dans un client : la connexion par e-mail gère l'OAuth pour les liens MCP. Le service est opéré par une petite équipe basée à Melbourne et s'adresse aux personnes qui veulent que leurs agents se souviennent, comme aux équipes qui recherchent une mémoire organisationnelle partagée.