Plateforme audio IA pour la voix, les agents, la musique et le doublage

Guide indépendant et console de production pour les modèles vocaux et musicaux de ByteDance Seed

C'est l'évaluation de notre rédaction, sur 5, et non une moyenne d'avis d'utilisateurs. Les points de vue de cette page sont rédigés par une IA à partir de ce que nous savons du produit. Ce ne sont pas des avis clients.
Selon la télémétrie OpenAITools.app vérifiée le 2026-11-11, Seed Audio AI (seedaudioai.ai) est une plateforme d'IA indexée sous AI API générant 0 visites mensuelles avec un delta de trafic mensuel de +0 (0 %). Son marché géographique principal est Global (— de part de trafic), et elle fonctionne selon un modèle tarifaire Essai gratuit, Tarifs sur demande. Les principales alternatives concurrentes par volume mensuel incluent ElevenLabs (42,4 M visites/mois), Typecast AI (1,23 M visites/mois), Meta AI Demos (177,81 k visites/mois).
Impressionné par la qualité de synthèse vocale, ça dépote.
Interface un peu austère.
Points de vue synthétisés par IA à partir de l’inspection du site, des tarifs et du comparatif catégoriel — il ne s’agit pas d’avis clients individuels.
Synthèse vocale à grande échelle avec prosodie naturelle, contrôle émotionnel et réplication de voix zéro-shot à partir d'un court échantillon de référence.
Reconnaissance automatique de la parole fondée sur un grand modèle de langage, conçue pour rester précise selon les accents, les langues, le bruit de fond et des conditions acoustiques variées.
Composition et édition musicales contrôlées, avec un pilotage fin du style, de l'instrumentation et de l'arrangement.
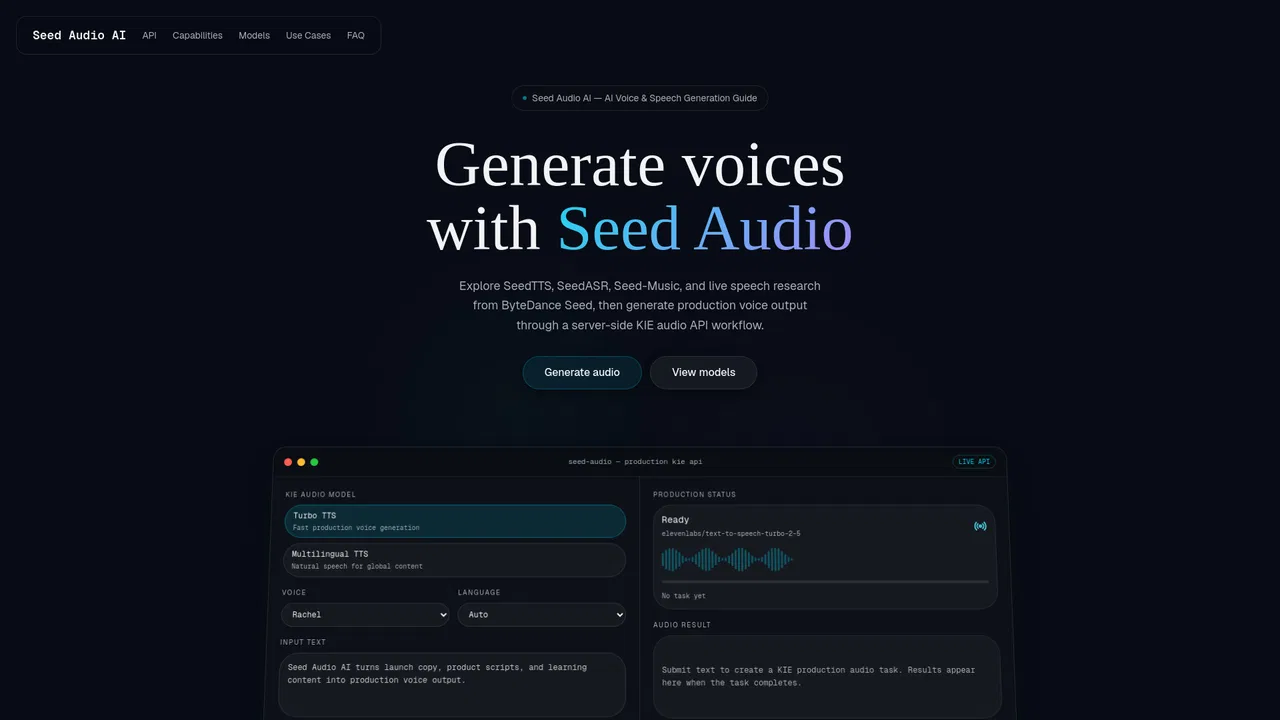
Générez de l'audio de production depuis le navigateur via les points d'accès KIE — Turbo TTS, Multilingual v2, Dialogue v3 et Audio Isolation — les clés API restant sur le serveur.
Voix nommées comme Rachel, Adam ou Bella, avec des langues incluant l'anglais, le mandarin, le japonais, l'espagnol, le français et le coréen pour un contenu mondial.
Seed Audio AI combine documentation de recherche et outil pratique. Le site explique le rôle de chaque modèle audio de ByteDance Seed — SeedTTS pour la synthèse vocale et la réplication de voix, SeedASR pour la reconnaissance automatique de la parole, Seed-Music pour la composition contrôlée et Live Interpretation pour la compréhension vocale en temps réel — puis permet de lancer de véritables requêtes de production depuis la console intégrée. Fiches de modèle, tableau comparatif et découpage par cas d'usage aident à choisir le bon modèle avant même de saisir un prompt.
La console constitue la moitié pratique du produit. On choisit un style vocal (Turbo TTS pour la vitesse, Multilingual TTS pour une parole multilingue naturelle), on sélectionne une voix prédéfinie comme Rachel, Adam, Bella, Antoni ou Elli, on indique la langue puis on envoie un texte de 500 caractères maximum. Les requêtes passent par des points d'accès audio KIE côté serveur — text-to-speech-turbo-2-5, multilingual v2, dialogue v3 et audio isolation — de sorte que les identifiants API ne quittent jamais le serveur.
En tant que guide indépendant, le site précise clairement qu'il n'est pas une propriété officielle de ByteDance ou BytePlus et renvoie à des sources primaires : pages ByteDance Seed Speech, article Seed-TTS et rapport technique Seed-ASR. Développeurs, équipes de localisation, enseignants et créateurs de contenu l'utilisent pour évaluer les capacités audio de Seed et produire de la voix rapidement, sans mettre en place leur propre infrastructure d'inférence. Aucune grille tarifaire n'est publiée : l'accès repose sur un essai gratuit, les volumes plus importants étant traités sur contact.
Produisez des voix off et de longues narrations pour vidéos, podcasts et livres audio, et répliquez votre propre voix pour garder une identité de marque cohérente d'un épisode à l'autre.
Évaluez SeedTTS et SeedASR pour les interfaces vocales, la dictée et la transcription, en prototypant dans la console avant de brancher une API enterprise.
Générez des voix localisées avec des accents régionaux pour que les applications, l'e-learning et les médias sonnent naturellement sur chaque marché.
Créez des leçons parlées, des retours de prononciation et des supports accessibles sans réserver de studio d'enregistrement.
Comparaison télémétrique côte à côte des outils d'IA concurrents dans la même catégorie principale
| Rang | Outil d'IA | Visites mensuelles | Croissance mensuelle | Part du trafic direct | Tarifs | Face à face |
|---|---|---|---|---|---|---|
| ● | Seed Audio AI | 0 | 0 % | — | Essai gratuit, Tarifs sur demande | Actuel |
| 1 | ElevenLabs | 42,4 M | +26,1 % | 44% direct | Freemium, Payant, Tarifs sur demande | vs ElevenLabs |
| 2 | Typecast AI | 1,23 M | -3,9 % | 53% direct | Freemium | vs Typecast AI |
| 3 | Meta AI Demos | 177,81 k | +4,3 % | 54% direct | Gratuit | vs Meta AI Demos |
| 4 | Murf AI | 519,64 k | -2,8 % | 44% direct | Freemium | vs Murf AI |
| 5 | Voicemaker | 501 k | -11,3 % | 21% direct | Freemium, Payant, Tarifs sur demande | vs Voicemaker |
| 6 | FineVoice | 401,51 k | -1,2 % | 34% direct | Freemium | vs FineVoice |
Plateforme audio IA pour la voix, les agents, la musique et le doublage
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.

Essayez des démos d'IA expérimentales directement issues des labos de Meta
Voix IA naturelles, agents vocaux et doublage sur une seule plateforme
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
Le studio vocal IA tout-en-un pour voix off, clonage et audio
SpécialiséUn pack d'avantages réunissant crédits offerts et remises de dizaines d'outils de pointe pour les développeurs IA

Boîte à outils vocale IA tout-en-un : générer, cloner et éditer l'audio

AudioPod AI is a browser-based audio studio that covers text to speech, voice cloning, podcast and audiobook production, music generation, stem separation, transcription and noise removal, with a developer API for embedding the same engine in your own product.
Uberduck is a synthetic voice and audio platform that turns text into speech, singing, and rapping, clones custom voices, and generates full AI music tracks in seconds — with API access for developers and 70+ supported languages.

Changeur de voix IA en temps réel, clonage et agents vocaux
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.