01
SoraWebuiオープンソース
1194/月
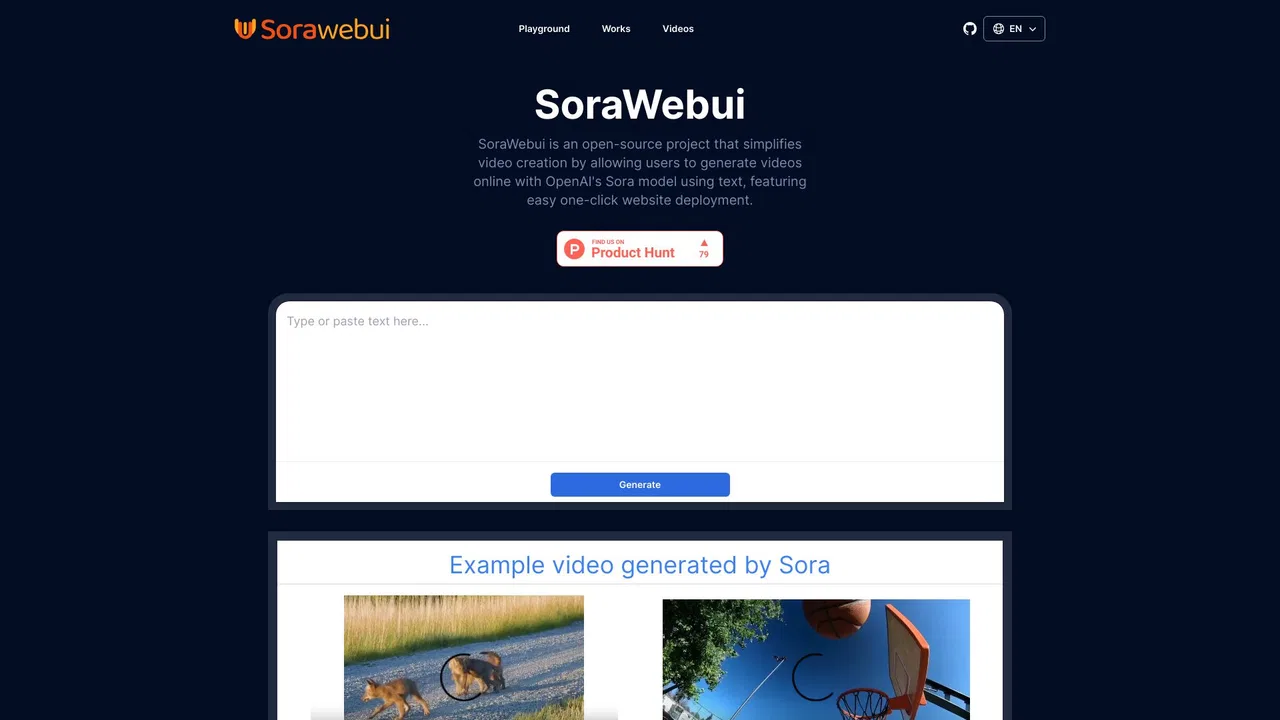
無料・オープンソースOpenAIのSoraモデル向けオープンソース文字起こし動画Web UI
Text to Video編集部スコア:3.2無料直接流入 39%
無料
機能と用途で選んだ、ChatGptSora の代替ツール 12 件。
| 順位 | ツールとキャッチコピー | 公式ドメイン | 月間訪問数 | 前月比成長率 | 料金モデル | 主要市場 | 評価 | 比較 |
|---|---|---|---|---|---|---|---|---|
| ● |
| ChatGptSora |
| chatgptsora.co |
| 0 |
| 0 (0%) |
| 無料 |
| グローバル |
| — |
| プロフィール |
| 1 | SoraWebui | sorawebui.com | 1194 | -1169 (-49.5%) | 無料 | アメリカ合衆国 | 3.2 | 比較 |
| 2 | OpenGen | opengen.ai | 114.12万 | 101.48万 (+802.8%) | 料金は要問い合わせ | アメリカ合衆国 | 3.9 | 比較 |
| 3 | Pollo AI | pollo.ai | 664.16万 | -70.6万 (-9.6%) | フリーミアム | 日本 | 4.1 | 比較 |
| 4 | Luma Dream Machine | lumalabs.ai | 225.5万 | -5.57万 (-2.4%) | フリーミアム | アメリカ合衆国 | 4.3 | 比較 |
| 5 | Runway | runwayml.com | 749.84万 | 108.61万 (+16.9%) | フリーミアム、有料、料金は要問い合わせ | アメリカ合衆国 | 4.6 | 比較 |
| 6 | LumeFlow AI | lumeflow.ai | 19.2万 | -11.91万 (-38.3%) | フリーミアム、無料トライアル、有料 | 日本 | 4.2 | 比較 |
| 7 | Pixwith AI | video-generator.ai | 12.32万 | -1.12万 (-8.3%) | フリーミアム、料金は要問い合わせ | オランダ | 3.8 | 比較 |
| 8 | Vidu | vidu.com | 400.9万 | 63.27万 (+18.7%) | フリーミアム、有料 | アメリカ合衆国 | 4.5 | 比較 |
| 9 | Omni AI Video | omniaivideo.ai | 5.37万 | 2.07万 (+62.6%) | フリーミアム、有料 | インド | 3.9 | 比較 |
| 10 | Creen AI | creen.ai | 188.84万 | -11.69万 (-5.8%) | フリーミアム、無料 | アメリカ合衆国 | 3.9 | 比較 |
| 11 | JXP AI動画ジェネレーター | jxp.com | 19.32万 | -2.03万 (-9.5%) | 無料トライアル、有料 | アメリカ合衆国 | 3.4 | 比較 |
| 12 | Video AI | videoai.ai | 10.53万 | 5968 (+6%) | フリーミアム | アメリカ合衆国 | 4.2 | 比較 |
無料・オープンソースOpenAIのSoraモデル向けオープンソース文字起こし動画Web UI
主要なAI動画・画像モデルを1つのワークスペースに
動画・画像・エージェント制作を一つにまとめたAIスタジオ
テキストto動画・画像to動画とビジュアル制作のためのAIクリエイティブエージェント
動画と画像をまとめて生成できるオールインワンAIプラットフォーム
動画と画像をまとめて生成できるオールインワンAIプラットフォーム
テキストと画像からマルチモデルでAI動画を生成——登録不要
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
テキスト・画像から映画的な動画を作る単一のマルチモーダルAIモデル
テキストから動画、画像から動画、画像生成、リップシンクを主要モデル横断でこなす統合スタジオ
テキストから動画、画像から動画、画像生成、リップシンクを主要モデル横断でこなす統合スタジオ
最高峰の AI 動画・画像・音声モデルを一つのワークスペースに





