
4.8万/月
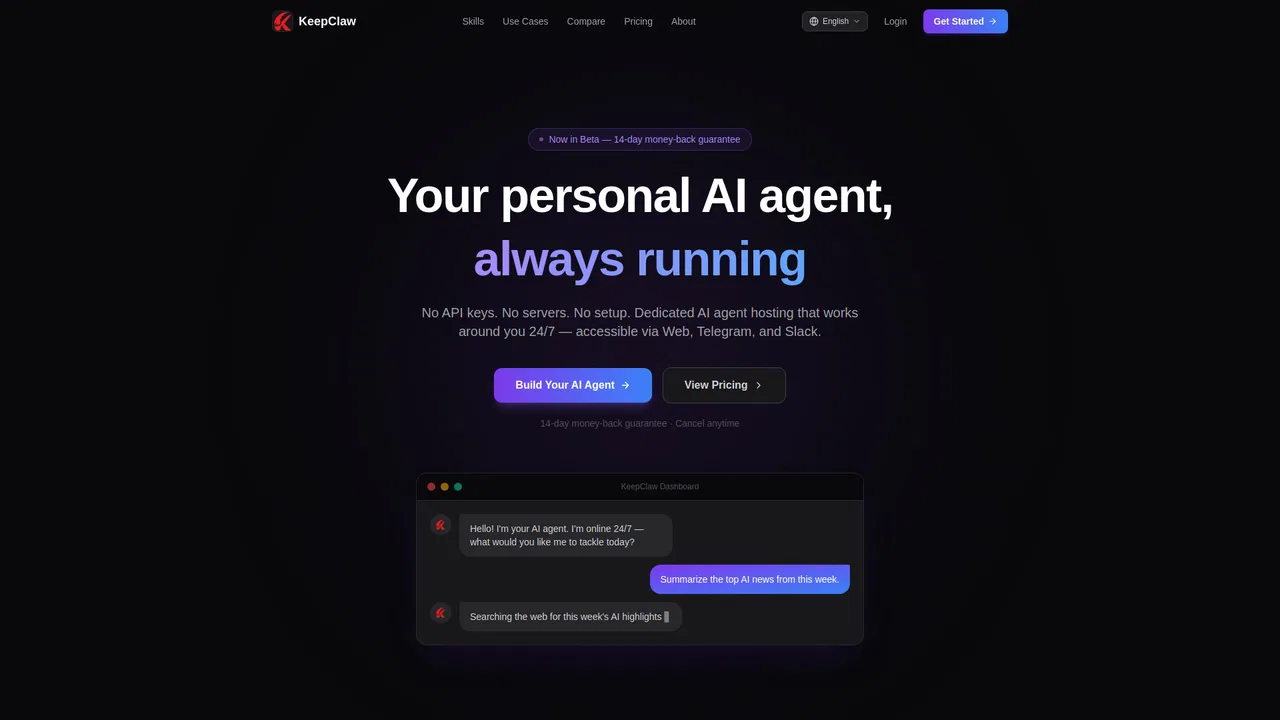
OpenClaw、Hermes、Codex などのAIエージェントをクラウドで運用
フリーミアム、無料
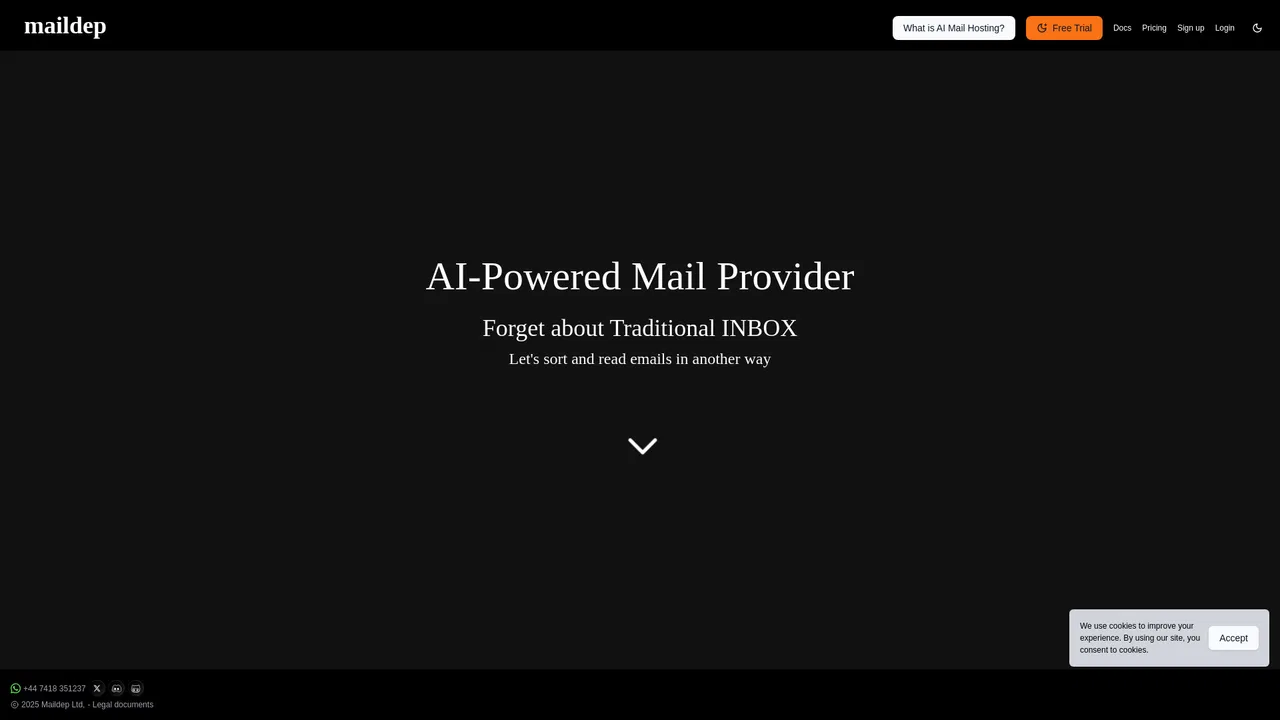
受信トレイを読み取り整理する AI 連携の IMAP ビジネスメールサーバー
編集部による 5 点満点の評価です。ユーザー評価の平均ではありません。 このページの各視点は、製品情報をもとに AI がまとめたものです。実際の利用者のレビューではありません。
OpenAITools.app のテレメトリ(2026-11-11 検証)によると、Maildep(maildep.com)は AIメールアシスタントに分類される AI プラットフォームで、月間 0 の訪問を生み出し、前月比のトラフィック増減は +0(0%)です。主要な地域市場はグローバル(トラフィックシェア —)で、フリーミアム、無料トライアル、有料の料金モデルで運営されています。月間ボリューム別の主な競合代替ツールには Atomic Bot(月間 4.77万訪問)、Zapmail(月間 11.24万訪問)、KeepClaw(月間 4646 訪問)が含まれます。
IMAPメールボックスとLLMの連携が非常にスムーズです。
請求書やタスクの自動抽出が便利すぎる。
サイト検証・料金体系・同カテゴリ比較に基づき AI が多角的な論点を要約した参考視点であり、実在ユーザーの個別投稿ではありません。
IMAP/SMTP、SPF、DKIM、DMARC、TLS/SSL、スパムフィルタリング、メールサーバーの自動検出に対応した標準ビジネスメール。Outlook、Gmail、Thunderbird、Spark で動作します。
受信メールが届いた時点で自動的に要約し、レポート、会議、タスク、To-Do、請求書や請求明細を抽出します。
OpenAI、Azure、Anthropic、DeepSeek、Qwen、Groq、SambaNova、OpenRouter、または自前の Ollama モデルにメールボックスを接続し、自前の API キーを使用できます。
米国中部、英国、EU、日本、シンガポール、インドの 6 つのデータセンターから選択できます。
メールボックスごとに AI を有効化・無効化し、カスタムプロンプトを追加し、無視リストを管理して、AI モデルの性能とトークン使用量のレポートを確認できます。
Maildep は従来のメールサーバーホスティングとエージェント型 AI 処理を組み合わせています。各メールボックスは通常の IMAP/SMTP アカウントで、Outlook、Gmail、Thunderbird、Spark といった使い慣れたクライアントで動作し、SPF、DKIM、DMARC、TLS/SSL、スパムフィルタリング、自動検出を備えています。特筆すべきはメール到着後の処理です。サーバーが大規模言語モデルでメールを処理し、要約を生成して、含まれるレポート、会議、タスク、請求書や請求明細を抽出し、返信の下書きまで自動生成します。Maildep はこの自動化によりスタッフの時間を 1 日あたり約 2 時間節約できると見積もっています。
このプラットフォームは意図的にモデル非依存の設計です。OpenAI、Azure、Anthropic、DeepSeek の自前の API キーを用意するか、Groq、SambaNova、OpenRouter、さらには自作の Ollama インスタンスのモデルを接続できます。Maildep 側でこれらの API の利用は無料です。自分でキーを管理したくない場合は、複数のメールボックスで共有できるトークン課金のプランを購入できます。管理者はメールボックスごとのトグル、カスタムプロンプト、無視リスト、性能とトークン使用量のレポートを利用でき、AI の挙動を把握できます。
ホスティングは米国、英国、EU、日本、シンガポール、インドの 6 つのデータセンターから提供され、データを指定した管轄区域内に保てます。プランは低コストのテスト用メールボックスから大規模なマルチドメインのビジネスアカウントまで用意され、完全に制御したい組織向けにはセミセルフホストの小規模ビジネス階層と、管理コントロールパネルおよび 1 年分のメンテナンスが付いた Kubernetes とコンテナベースのフルセルフホストインストールがあります。
溢れるサポート受信トレイを要約、抽出タスク、返信下書きに変換し、担当者がより速く対応し見落としを減らせるようにします。
受信メールから請求書や請求明細を自動で抽出し、手入力ではなく構造化データとして処理します。
自社ドメインで SPF、DKIM、DMARC を備えたビジネスメールボックスを構築し、コンプライアンス要件に合うデータセンター地域を選びます。
好みの LLM の API キーを接続し、プロンプト、無視リスト、メールボックス単位の AI 機能を調整しながらトークン使用量を追跡します。
同じ主要カテゴリの競合 AI ツールをテレメトリで並列比較
| 順位 | AI ツール | 月間訪問数 | 前月比成長率 | 直接流入の割合 | 料金 | 直接比較 |
|---|---|---|---|---|---|---|
| ● | Maildep | 0 | 0% | — | フリーミアム、無料トライアル、有料 | 表示中 |
| 1 | Atomic Bot | 4.77万 | -7.8% | 直接流入 40% | フリーミアム、無料 | vs Atomic Bot |
| 2 | Zapmail | 11.24万 | -5.9% | 直接流入 77% | 有料 | vs Zapmail |
| 3 | KeepClaw | 4646 | +17.2% | 直接流入 39% | 無料トライアル、有料 | vs KeepClaw |
| 4 | EmpirioLabs AI | 3.79万 | +15.2% | 直接流入 40% | フリーミアム、有料 | vs EmpirioLabs AI |
| 5 | Openclaw AI | 1.28万 | -30.5% | 直接流入 40% | Free (self-hosted), Paid cloud plans from $19.99/month; yearly saves 25% | vs Openclaw AI |
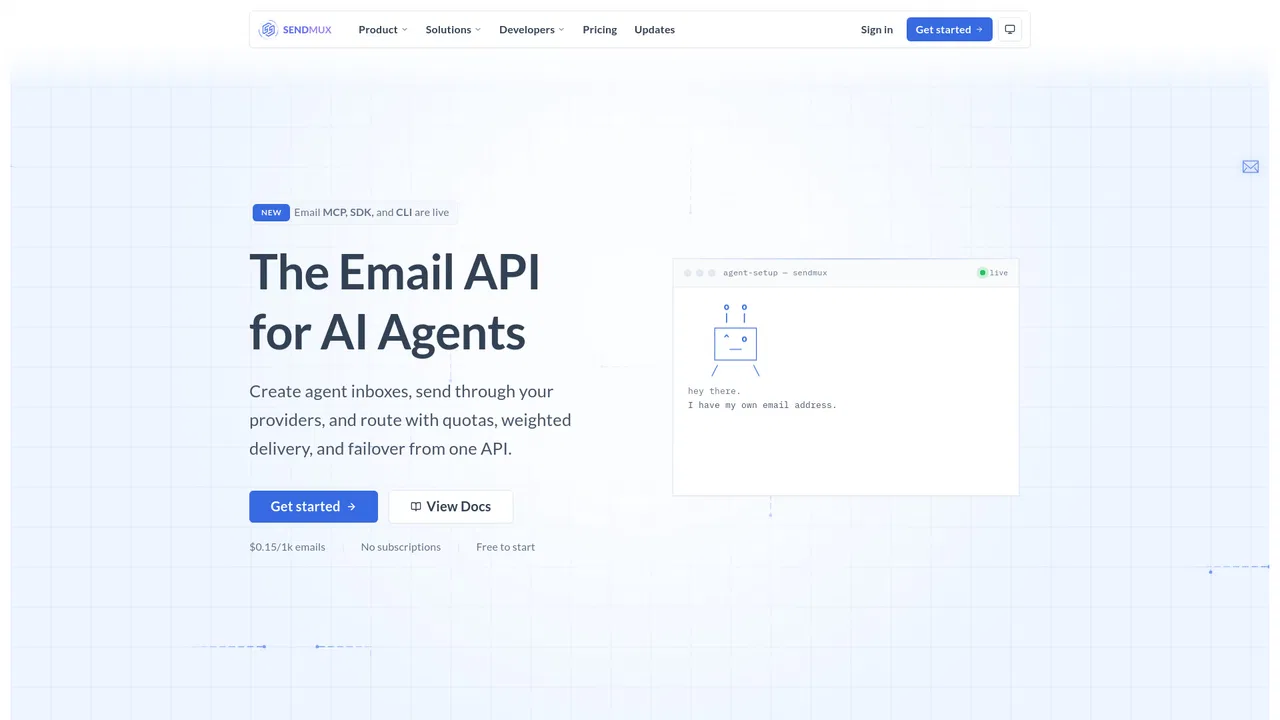
| 6 | Sendmux | 37 | -98.3% | 直接流入 32% | 無料 | vs Sendmux |
OpenClaw、Hermes、Codex などのAIエージェントをクラウドで運用
本当に受信箱に届くコールドメールインフラ
専門的なAIモデルホスティング、最適化エンドポイント、オンデマンドGPU基盤
無料・オープンソースセルフホストもクラウドも選べるオープンソースのパーソナルAIアシスタント
Sendmux is an email API built for AI agents. It gives each agent a real mailbox on a verified domain or a shared address, lets it send outbound mail through your own providers, and streams inbox events live so agents can react instead of polling.
無料・オープンソース実タスクをこなすブラウザエージェントとステルス雲ブラウザ

無料・オープンソースコーディングエージェント向けにローカル LLM を即応化するネイティブ macOS 推論サーバー
MyClaw is a managed cloud hosting service for OpenClaw (formerly Clawdbot) agents. It gives you an always-on private AI agent with a cloud computer, preinstalled automation skills, daily backups and automatic updates, so you get a 24/7 assistant without touching a server.
MyClaw is a managed cloud hosting service for OpenClaw (formerly Clawdbot) agents. It gives you an always-on private AI agent with a cloud computer, preinstalled automation skills, daily backups and automatic updates, so you get a 24/7 assistant without touching a server.
General Compute is an inference cloud built around alternative AI silicon rather than standard GPU fleets. The company buys racks of accelerators, racks them in colocation data centres, and handles the cooling, power, and networking itself. On top of that hardware it runs a disaggregated inference stack that splits each request: prompt processing runs on NVIDIA GPUs for prefill, while token generation runs on faster decode chips such as Cerebras, SambaNova, Positron AI, and d-Matrix. Customers get bare metal access or a tokens-per-second SLA.
General Compute is an inference cloud built around alternative AI silicon rather than standard GPU fleets. The company buys racks of accelerators, racks them in colocation data centres, and handles the cooling, power, and networking itself. On top of that hardware it runs a disaggregated inference stack that splits each request: prompt processing runs on NVIDIA GPUs for prefill, while token generation runs on faster decode chips such as Cerebras, SambaNova, Positron AI, and d-Matrix. Customers get bare metal access or a tokens-per-second SLA.