01

フリーミアム、有料
キャプション、Q&A、OCR、検出に対応するオープンソースの視覚モデル。
編集部による 5 点満点の評価です。ユーザー評価の平均ではありません。 このページの各視点は、製品情報をもとに AI がまとめたものです。実際の利用者のレビューではありません。
OpenAITools.app のテレメトリ(2026-11-11 検証)によると、Pongo (Moondream)(moondream.ai)は Large Language Models (LLMs) に分類される AI プラットフォームで、月間 0 の訪問を生み出し、前月比のトラフィック増減は +0(0%)です。主要な地域市場はグローバル(トラフィックシェア —)で、フリーミアムの料金モデルで運営されています。月間ボリューム別の主な競合代替ツールには Google Gemma オープンモデル(月間 490.09万訪問)、Image Describer(月間 11.99万訪問)、Roboflow(月間 143.12万訪問)が含まれます。
ローカルで動くビジョンモデルとして最高峰の完成度。
OCR精度も実用レベルで素晴らしい。
サイト検証・料金体系・同カテゴリ比較に基づき AI が多角的な論点を要約した参考視点であり、実在ユーザーの個別投稿ではありません。
数行のPythonで任意の画像に自然言語の説明を生成でき、アクセシビリティやアセットのタグ付け・整理に役立ちます。
写真に何が写っているかを自然な言葉で質問し、物体・数・テキスト・文脈について簡潔な回答を得られます。
画像から印刷文字、看板、文書を直接読み取り、別途OCRパイプラインを組むことなく処理できます。
画像内の物体や人を検出・位置特定・カウントし、モデルファミリーはポインティングや視線的な理解にも対応します。
オープンウェイトをローカルGPUで自分で実行するか、ホスト型Moondream Cloud APIを利用できます。既成の精度で足りなければLensでファインチューニングできます。
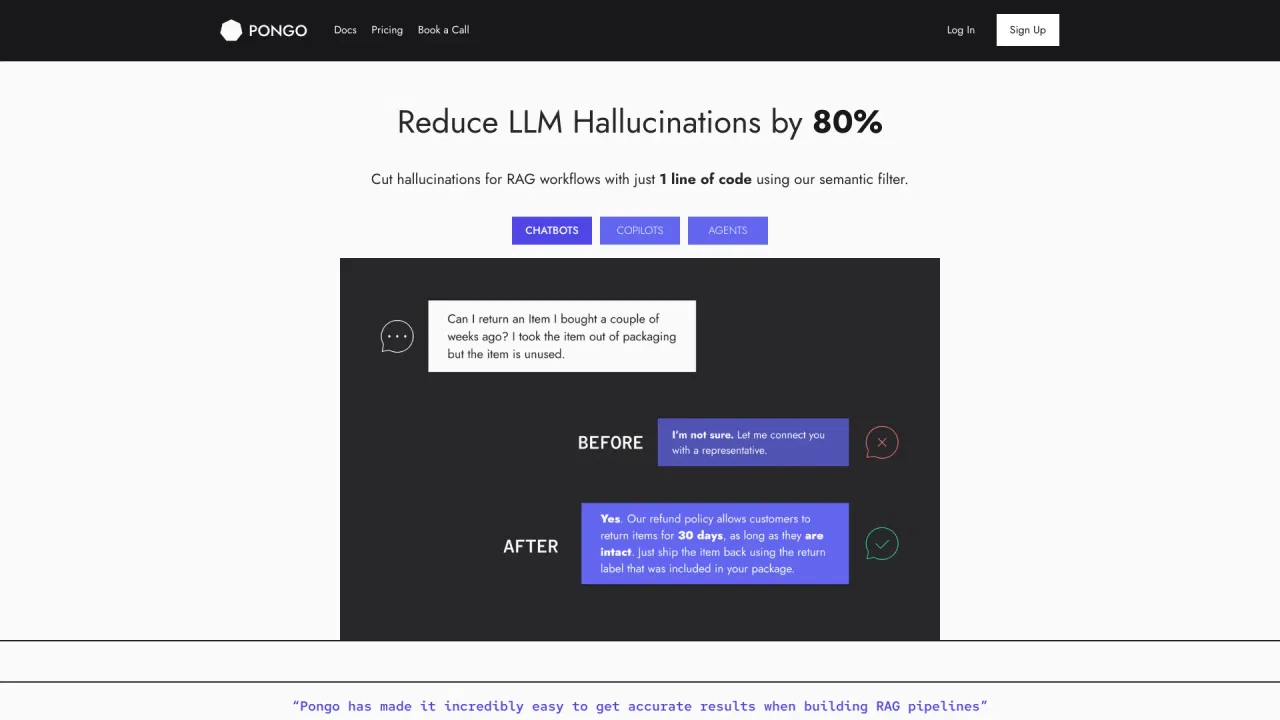
Pongoは、オープンソースの視覚言語モデルMoondreamが最初に登場した際の製品名です。現在joinpongo.comにアクセスするとmoondream.aiへ301リダイレクトされ、そこでは同じモデルがホスト型API、無料プレイグラウンド、Lensというファインチューニング基盤、Photonという推論エンジンとともに活発に開発されています。
視覚言語モデルとして、画像のキャプション生成、シーンへの質問応答、OCRによる文字読み取り、物体の検出とカウント、画面や視線の理解といった中核的なマルチモーダルタスクを担います。ウェイトはオープンで商用利用に適しているため、数行のPythonでホスト型APIを呼び出すことも、モデルをダウンロードしてJetsonなどのローカル/エッジ環境で自分で実行することもできます。
Moondreamは効率性を重視しています。社内ベンチマークではH100とPhotonの組み合わせで60ミリ秒未満の応答、クラウドで1,000枚あたりのコストも非常に低いとされています。基本モデル以上の精度が必要なチーム向けには、LensがシンプルなAPIによるセルフサーブのファインチューニングを提供し、わずか20枚程度のラベル付き画像で精度を高められる強化学習チューニングも含みます。エンタープライズではラベリングと評価の支援を受けつつ、ウェイトとデータを保持できます。
写真ライブラリにキャプションを付け、物体をタグ付けし、文字を読み取るパイプラインを構築し、手作業のメタデータ入力なしで検索可能にします。
OCRと視覚的質問応答を組み込み、ユーザーが写真について質問したり文書をスキャンしたり、カメラが見ているものをハンズフリーで説明してもらえるようにします。
JetsonやローカルGPUでオープンウェイトを実行し、製品検査やラベル読み取り、ライン上の物品カウントを行い、データを拠点内に保持します。
Lensで小さなラベル付きセットによりモデルを微調整し、大規模データセットなしで特定領域の本番精度に到達します。
同じ主要カテゴリの競合 AI ツールをテレメトリで並列比較
| 順位 | AI ツール | 月間訪問数 | 前月比成長率 | 直接流入の割合 | 料金 | 直接比較 |
|---|---|---|---|---|---|---|
| ● | Pongo (Moondream) | 0 | 0% | — | フリーミアム | 表示中 |
| 1 | Google Gemma オープンモデル | 490.09万 | -13.5% | 直接流入 26% | フリーミアム、有料 | vs Google Gemma オープンモデル |
| 2 | Image Describer | 11.99万 | -10.3% | 直接流入 35% | 有料 | vs Image Describer |
| 3 | Roboflow | 143.12万 | +6.6% | 直接流入 47% | フリーミアム、料金は要問い合わせ | vs Roboflow |
| 4 | CapMonster Cloud | 86.23万 | +36.3% | 直接流入 4% | 有料 | vs CapMonster Cloud |
| 5 | Imagga | 1.55万 | +9.9% | 直接流入 40% | フリーミアム、有料、料金は要問い合わせ | vs Imagga |
| 6 | Unsloth AI | 88.75万 | -17.6% | 直接流入 30% | 無料 | vs Unsloth AI |
あらゆる画像をAIで説明——詳細な説明、キャプション、プロンプト、テキスト抽出を一か所で
特化型大規模処理に設計された AI CAPTCHA 解決 API
無料・オープンソースUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
無料・オープンソースUnsloth is an open-source toolkit for running and training large language models locally. It provides faster, more memory-efficient fine-tuning, a local chat and agent environment with browser use, image and video generation, and an OpenAI-compatible API your existing tools can connect to.
無料・オープンソーステキスト・視覚・画像・音声をカバーするテンセントのマルチモーダル基盤モデル群

Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.
Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.

Together AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.
Together AI is the AI Native Cloud — a full-stack platform for running, fine-tuning and training open-source models. It spans serverless inference APIs, dedicated endpoints, GPU clusters, post-training and storage, all backed by in-house systems research.





