

114.1万/月
主要なAI動画・画像モデルを1つのワークスペースに
料金は要問い合わせ
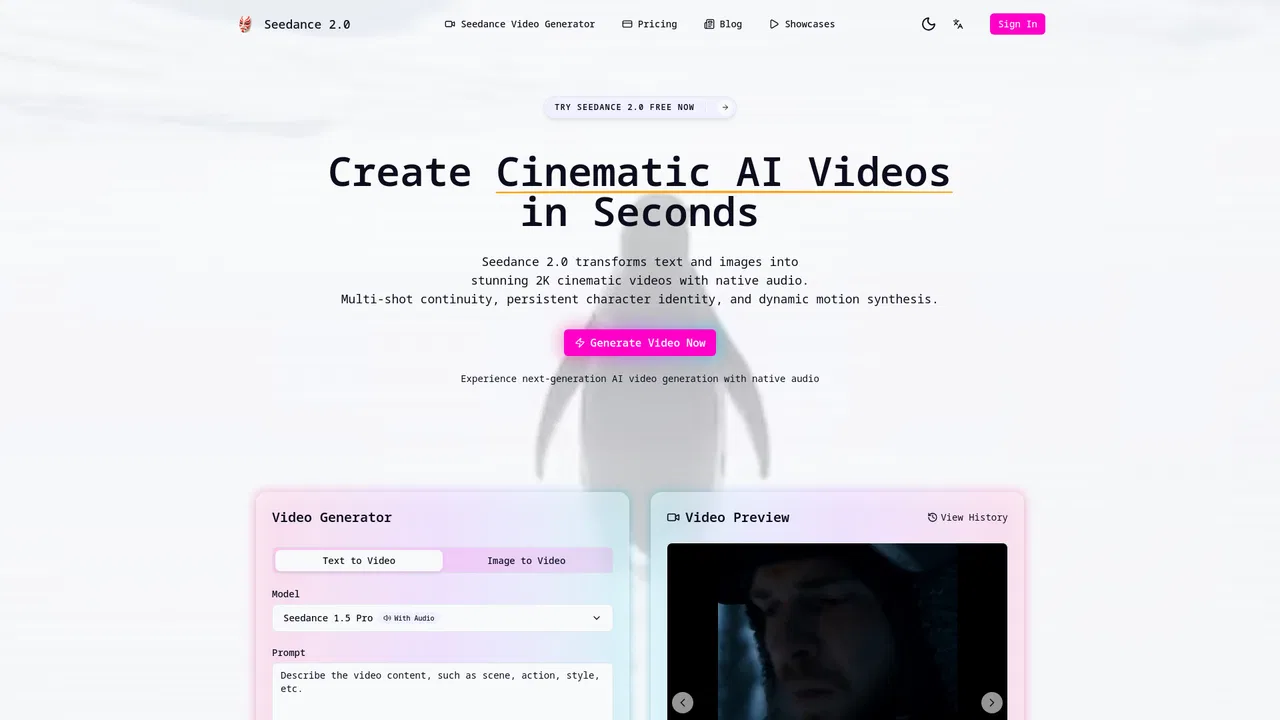
ネイティブ音声と物理認識モーションを備えたテキスト・画像からの動画生成
月間サイト訪問数の推計
Seedance 2.0はByteDance社とは一切関係のない非公式のサードパーティ製ラッパーサイトであり、SEO集客のためにブランド名を利用しています。
このドメインの Similarweb 推計値であり、アクティブユーザー数ではありません。観測データのある月のみ表示し、取得日と対象月を区別しています。
取得日 2026/11/11
編集部による 5 点満点の評価です。ユーザー評価の平均ではありません。 このページの各視点は、製品情報をもとに AI がまとめたものです。実際の利用者のレビューではありません。
OpenAITools.app のテレメトリ(2026-11-11 検証)によると、Seedance 2.0(seedance2.today)は AI Video Generator に分類される AI プラットフォームで、月間 3311 の訪問を生み出し、前月比のトラフィック増減は -1233(-27.1%)です。主要な地域市場はアメリカ合衆国(トラフィックシェア 64.3%)で、フリーミアム、有料の料金モデルで運営されています。月間ボリューム別の主な競合代替ツールには OpenGen(月間 114.12万訪問)、Higgsfield(月間 4712.79万訪問)、Luma Dream Machine(月間 225.5万訪問)が含まれます。
公式と勘違いさせる悪質なSEOトラップサイト。
中身はただのAPIラッパーで割高。
サイト検証・料金体系・同カテゴリ比較に基づき AI が多角的な論点を要約した参考視点であり、実在ユーザーの個別投稿ではありません。
雰囲気、カメラアングル、登場するキャラクターの数と行動を平易な言葉で書き、最大 2,500 文字の複雑な多段プロンプトを処理します。
写真やイラストをアップロードすると、髪がなびく、水面が波立つ、頭が向くなど動きをモデルが判断し、肌の質感やジュエリー、布地のディテールを保ちます。
音声と動画を一緒に生成します。同期した唇の動き、アクションに合う効果音、設定に合う環境音を、別途ポストプロセスなしで実現します。
ByteDance は不可能な動きにペナルティを与える物理認識トレーニングを組み込み、布が自然に垂れ、水しぶきが正しい重さで、キャラクターが歩行時にバランスを保ちます。
Seedance 2.0、Seedance 2.0 Fast、Seedance 1.5 Pro、Kling 2.6、Kling 2.5 Turbo Pro、Nano Banana 2、Nano Banana Pro、Nano Banana、Z-Image Turbo を 1 つのダッシュボードから選べます。
Seedance 2.0 は、モデル API 上に構築された独立系サードパーティの AI 動画・画像生成プラットフォームです。ByteDance や公式 Seedance チームとは提携も承認もされていないと明言しており、ByteDance の Seedance モデルといくつかの他の主要モデルを包むワークフローを提供するだけです。ユーザーは公式リリースではなく独立した製品として扱うべきです。
動画側では、プラットフォームは Seedance 2.0 を中心とし、テキスト・画像・動画・音声参照のための統合マルチモーダルアーキテクチャ上に構築されています。テキストまたは開始画像から生成でき、ネイティブ音声、物理認識モーション、参照駆動の制御を備え、長さは最長約 15 秒です。サイトは出力について正直で、Seedance 2.0 はネイティブで 480p と 720p をレンダリングし、対応していない 2K や 4K 出力を主張しません。
Seedance 以外にも、ダッシュボードでは約 10 のモデル——Seedance 2.0 Fast、Seedance 1.5 Pro、2 つの Kling 動画モデル、3 つの Nano Banana 画像モデル、Z-Image Turbo——が動作し、用途に応じてモデルを選べます。キャラクターの台詞は同期した唇の動きで生成され、効果音はアクションに合わせて鳴り、背景の環境音は設定に合います。料金はフリーミアムのクレジット制で、プラットフォーム上のすべてのモデルで共通です。
台詞、効果音、環境音を同じパスで生成し、SNS 向けショートクリップを素早く作成します。
1 枚の静止画を動きに変え、細部を保ちながら髪、水、頭の動きを加えます。
Seedance 2.0 Fast や他のモデルで、ストーリービートと音声重視の動画アイデアを素早く反復します。
1 つのダッシュボードで動画モデルと画像モデル(Nano Banana、Z-Image)を切り替え、多様な素材を作ります。
同じ主要カテゴリの競合 AI ツールをテレメトリで並列比較
| 順位 | AI ツール | 月間訪問数 | 前月比成長率 | 直接流入の割合 | 料金 | 直接比較 |
|---|---|---|---|---|---|---|
| ● | Seedance 2.0 | 3311 | -27.1% | 直接流入 40% | フリーミアム、有料 | 表示中 |
| 1 | OpenGen | 114.12万 | +802.8% | 直接流入 6% | 料金は要問い合わせ | vs OpenGen |
| 2 | Higgsfield | 4712.79万 | +16.2% | 直接流入 54% | フリーミアム、無料トライアル | vs Higgsfield |
| 3 | Luma Dream Machine | 225.5万 | -2.4% | 直接流入 37% | フリーミアム | vs Luma Dream Machine |
| 4 | Seeddance | 3.42万 | -16.1% | 直接流入 41% | フリーミアム | vs Seeddance |
| 5 | FreeWanVideo | 8.33万 | -47.9% | 直接流入 57% | フリーミアム | vs FreeWanVideo |
| 6 | Creen AI | 188.84万 | -5.8% | 直接流入 47% | フリーミアム、無料 | vs Creen AI |
主要なAI動画・画像モデルを1つのワークスペースに
シネマティックな映像と画像のためのAIネイティブ制作スイート
テキストto動画・画像to動画とビジュアル制作のためのAIクリエイティブエージェント
シネマティックなAI動画・画像・音楽を一つに
WAN・Grok・Seedance・Veo で動く無料 AI 動画生成ツール
テキスト・画像から映画的な動画を作る単一のマルチモーダルAIモデル
動画と画像をまとめて生成できるオールインワンAIプラットフォーム
動画と画像をまとめて生成できるオールインワンAIプラットフォーム

Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.






