01
127.9万/月
無料・オープンソースAlibaba の Wan モデルによる AI 動画・画像生成
AI Video Generator編集部スコア:4.7フリーミアム直接流入 53%

フリーミアム

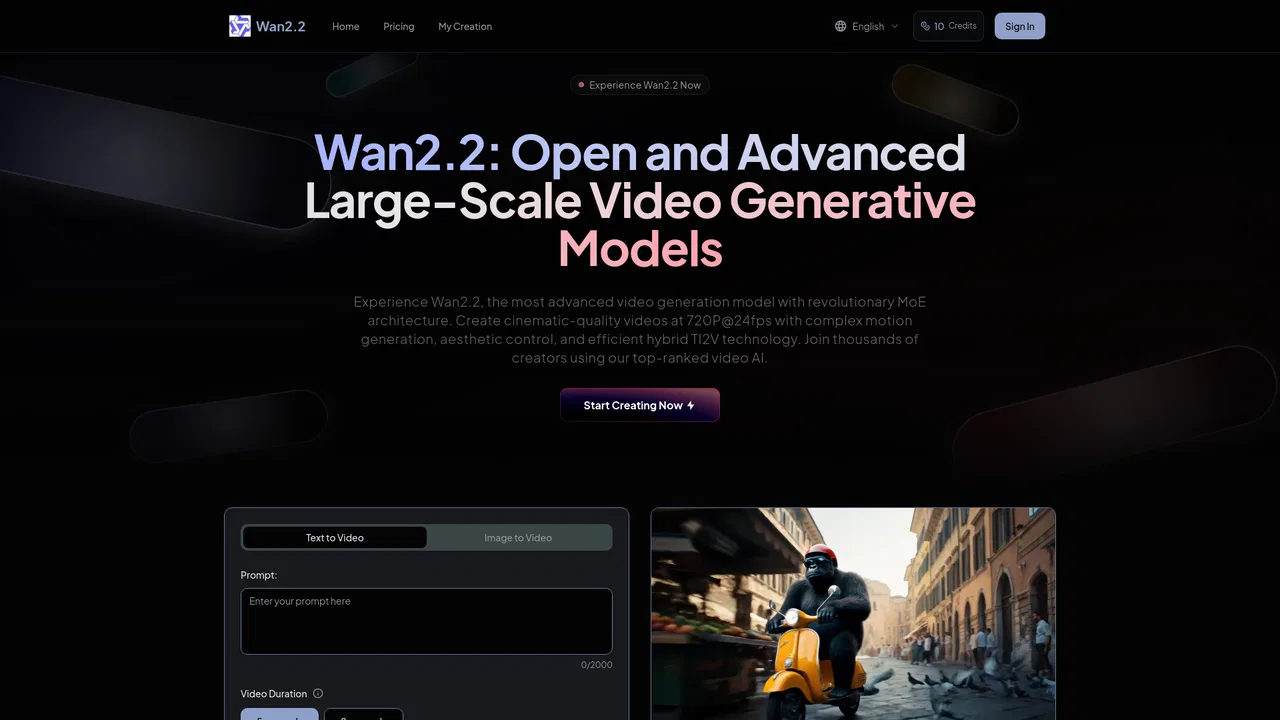
ブラウザで使える Wan 2.2 のテキスト/画像から動画への生成スタジオ
月間サイト訪問数の推計
Wan 2.2 Studioは、アリババのオープンソース動画モデルを非公式に包んだサードパーティ製Webインターフェースです。
このドメインの Similarweb 推計値であり、アクティブユーザー数ではありません。観測データのある月のみ表示し、取得日と対象月を区別しています。
取得日 2026/11/11
編集部による 5 点満点の評価です。ユーザー評価の平均ではありません。 このページの各視点は、製品情報をもとに AI がまとめたものです。実際の利用者のレビューではありません。
OpenAITools.app のテレメトリ(2026-11-11 検証)によると、Wan 2.2 Studio(wan22.studio)は AI Video Generator に分類される AI プラットフォームで、月間 949 の訪問を生み出し、前月比のトラフィック増減は -4325(-82%)です。主要な地域市場はメキシコ(トラフィックシェア 100%)で、Paid, Subscription, One-time purchase の料金モデルで運営されています。月間ボリューム別の主な競合代替ツールには Wan.Video(月間 127.92万訪問)、OpenGen(月間 114.12万訪問)、Pollo AI(月間 664.16万訪問)が含まれます。
オープンソースモデルの有料ラッパーサイトにすぎない。
クレジットの消耗が激しすぎる。
サイト検証・料金体系・同カテゴリ比較に基づき AI が多角的な論点を要約した参考視点であり、実在ユーザーの個別投稿ではありません。
約 2,500 文字までのプロンプトを入力するか静止画をアップロードして動かし、コマンドラインなしで動画を生成します。
約 4~12 秒のクリップを生成し、品質は低コストのプレビューから 1080p まで、比率は 1:1 から 16:9、21:9 まで選べます。
2 つの専門家で構成される MoE 設計のオープンソース Wan 2.2 をクラウドで実行。ローカルに GPU、重みのダウンロード、CUDA 設定は不要です。
長さと品質で決まるレートでクレジットを消費し、生成ボタンを押す前に正確な合計が表示されます。
完成したクリップは My Creation エリアに保存され、再確認・ダウンロード・再活用ができます。
Wan 2.2 は Alibaba のオープンソース大規模動画生成モデル群で、高ノイズ専門家が全体レイアウトを、低ノイズ専門家が細部を洗練する MoE(Mixture-of-Experts)設計と、テキスト・画像から動画を生成する統合 TI2V フレームワークで知られています。ローカルで快適に動かすには、巨大な重みファイル、CUDA 環境、VRAM 制限、長い推論時間への対処が必要です。
Wan 2.2 Studio はその準備をすべて不要にします。独立系のサードパーティサイトで、モデルをホスティング型の生成インターフェースに包んでいます。約 2,500 文字までのプロンプトを入力し、任意で画像を添付し、長さ(4~12 秒)、品質段階、正方形から 16:9、21:9 の縦長までのアスペクト比を選べます。同じプロンプトを複数の品質段階でレンダリングできるため、低コストのプレビューで構図を確認してから最良の出力に投資できます。生成結果は My Creation ライブラリにまとまり、クレジットは生成ごとに消費され、開始前に必要量が表示されます。
これはモデルの公式サイトではなくサードパーティのフロントエンドであるため、実務的な判断もそれに合わせる必要があります。価格、稼働状況、レンダリング結果の保持、実際に使われるモデルバージョンは、上流のモデル作者ではなくこのサイトが定めます。生成物の商用利用範囲や、アップロードした素材の権利は、サイトが公開する規約に依存します。公開されているプランは月額 $19.9 からで年払いに割引があり、マルチショット制作や高速生成向けの上位プラン、他の画像・動画モデル向けの関連ツールへのリンクも掲載されています。
アイデア主導の B ロール、ムードショット、縦長クリップをプロンプトで作り、構図が決まったら高品質で再レンダリングします。
長さと比率を変えた低コストのプレビューを複数生成し、最も良いものだけにフル品質のコストをかけます。
画像から動画モードで商品写真や絵コンテにカメラワークを与え、編集工程へ渡します。
GPU マシンや依存関係の構築なしに、ブラウザでオープンソースの Wan 2.2 を試せます。
同じ主要カテゴリの競合 AI ツールをテレメトリで並列比較
| 順位 | AI ツール | 月間訪問数 | 前月比成長率 | 直接流入の割合 | 料金 | 直接比較 |
|---|---|---|---|---|---|---|
| ● | Wan 2.2 Studio | 949 | -82% | 直接流入 41% | Paid, Subscription, One-time purchase | 表示中 |
| 1 | Wan.Video | 127.92万 | -12.5% | 直接流入 53% | フリーミアム | vs Wan.Video |
| 2 | OpenGen | 114.12万 | +802.8% | 直接流入 6% | 料金は要問い合わせ | vs OpenGen |
| 3 | Pollo AI | 664.16万 | -9.6% | 直接流入 46% | フリーミアム | vs Pollo AI |
| 4 | FreeWanVideo | 8.33万 | -47.9% | 直接流入 57% | フリーミアム | vs FreeWanVideo |
| 5 | Luma Dream Machine | 225.5万 | -2.4% | 直接流入 37% | フリーミアム | vs Luma Dream Machine |
| 6 | Creen AI | 188.84万 | -5.8% | 直接流入 47% | フリーミアム、無料 | vs Creen AI |
無料・オープンソースAlibaba の Wan モデルによる AI 動画・画像生成
無料・オープンソース主要なAI動画・画像モデルを1つのワークスペースに
無料・オープンソース動画・画像・エージェント制作を一つにまとめたAIスタジオ
無料・オープンソースWAN・Grok・Seedance・Veo で動く無料 AI 動画生成ツール
無料・オープンソースWAN・Grok・Seedance・Veo で動く無料 AI 動画生成ツール
無料・オープンソーステキストto動画・画像to動画とビジュアル制作のためのAIクリエイティブエージェント
無料・オープンソーステキストから動画、画像から動画、画像生成、リップシンクを主要モデル横断でこなす統合スタジオ
無料・オープンソーステキストから動画、画像から動画、画像生成、リップシンクを主要モデル横断でこなす統合スタジオ
無料・オープンソーステキスト・画像から映画的な動画を作る単一のマルチモーダルAIモデル
無料・オープンソーステキスト・画像から映画的な動画を作る単一のマルチモーダルAIモデル
無料・オープンソース動画と画像をまとめて生成できるオールインワンAIプラットフォーム
無料・オープンソース動画と画像をまとめて生成できるオールインワンAIプラットフォーム

無料・オープンソースSea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
無料・オープンソースSea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
無料・オープンソースVidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
無料・オープンソースVidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.


