01

월간 웹사이트 방문 수 추정치
이 도메인의 Similarweb 추정치이며 활성 사용자 수가 아닙니다. 관측 데이터가 있는 월만 표시하며 수집일과 집계 월을 구분합니다.
수집일 2026. 11. 11.

에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, Datalab(datalab.to)은(는) AI 문서 추출에 색인된 AI 플랫폼으로 월 7.34만회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +2.92만(+66%)입니다. 주요 지리적 시장은 미국(트래픽 점유율 48.8%)이며, 무료+유료, 가격 문의 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 Reducto (월 9.21만회 방문), Monkt (월 5.18만회 방문), AnyParser (월 4.76천회 방문) 등이 있습니다.
복잡한 PDF 파싱 능력이 압도적입니다.
개발자용 API 문서가 깔끔해요.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
PDF, 스캔본, 스프레드시트, 슬라이드를 Markdown, HTML, JSON으로 변환하며 fast·balanced·accurate 모드와 단어 단위 바운딩 박스, 차트 데이터, 그림 설명을 지원합니다.
필요한 필드를 정의하면 JSON을 받고, 각 값에는 원문 단어나 표 셀을 가리키는 인용과 신뢰도 점수가 붙습니다.
합쳐진 파일에서 문서 경계를 감지하고, 자사 페이지에서 파싱 모드를 나란히 비교해 품질·가격·속도로 선택할 수 있습니다.
동일한 파이프라인을 관리형 클라우드, 자사 VPC, 인터넷이 필요 없는 에어갭 환경에서 실행할 수 있습니다.
Datalab이 운영하는 GPU 워커 풀에서 초대규모 작업을 처리하고 페이지당 과금합니다. 별도 인프라 구축이 필요 없습니다.
Datalab은 Marker, Surya, Chandra, Indra 등 합산 수만 개의 GitHub 스타를 받은 오픈소스 문서 AI 프로젝트에서 출발해, 그 연구 성과를 프로덕션용 관리형 API로 묶은 제품입니다. 기능은 '프로세서' 단위로 구성됩니다. Convert는 PDF를 Markdown/HTML/JSON으로 변환하며 단어 단위 바운딩 박스와 차트 데이터를 선택적으로 붙입니다. Extract는 사용자가 정의한 필드를 JSON으로 뽑아내고 모든 값에 원문 인용과 신뢰도 점수를 달아줍니다. Segment는 하나로 합쳐진 파일에서 자연스러운 문서 경계를 찾아내고, Eval은 자사 문서로 파싱 모드를 비교합니다.
모델을 직접 보유하고 있기 때문에 배포 방식이 매우 유연합니다. 무료 티어가 있는 관리형 SOC 2 클라우드, 자사 AWS·GCP·Azure 계정 안에 구축하는 VPC 배포, 인터넷이 필요 없는 완전 에어갭 온프레미스까지 지원합니다. 또한 1만 6천 건이 넘는 합격/불합격 테스트로 구성된 공개 벤치마크 OmniParseBench를 운영하며, 테이블과 다단 레이아웃에서 accurate 모드가 경쟁 파서 API를 앞선다고 설명합니다.
주요 고객은 학습 코퍼스를 만드는 최전선 AI 연구소와 금융, 의료, 보험, 법률 등 규제 산업입니다. 이들 분야에서는 정확도만큼 추적 가능성이 중요합니다. 배치는 초대규모 작업을 겨냥하며, 관리형 배치로 하루 10억 페이지 이상을 처리한다고 밝히고 있습니다.
웹 크롤 데이터, 과학 논문, 1,000페이지 이상 도서를 인용 가능한 깨끗한 학습 텍스트로 변환합니다.
빽빽한 명세서와 공시 문서에서 수치를 추출하고 모든 값을 출처 페이지까지 추적합니다.
청구 양식과 임상시험 문서에서 구조화 필드를 뽑아내고, 사람 검토용으로 신뢰도 점수를 유지합니다.
문서를 외부로 내보낼 수 없을 때 VPC나 오프라인 네트워크에서 파싱을 실행합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | Datalab | 7.34만 | +66% | 직접 유입 52% | 무료+유료, 가격 문의 | 현재 도구 |
| 1 | Reducto | 9.21만 | +0.9% | 직접 유입 46% | 무료+유료 | vs Reducto |
| 2 | Monkt | 5.18만 | +47.4% | 직접 유입 40% | 유료 | vs Monkt |
| 3 | AnyParser | 4.76천 | -14.9% | 직접 유입 40% | 무료 체험, 가격 문의 | vs AnyParser |
| 4 | aOCR | 1.77천 | +1.7% | 직접 유입 39% | 무료 체험, 가격 문의 | vs aOCR |
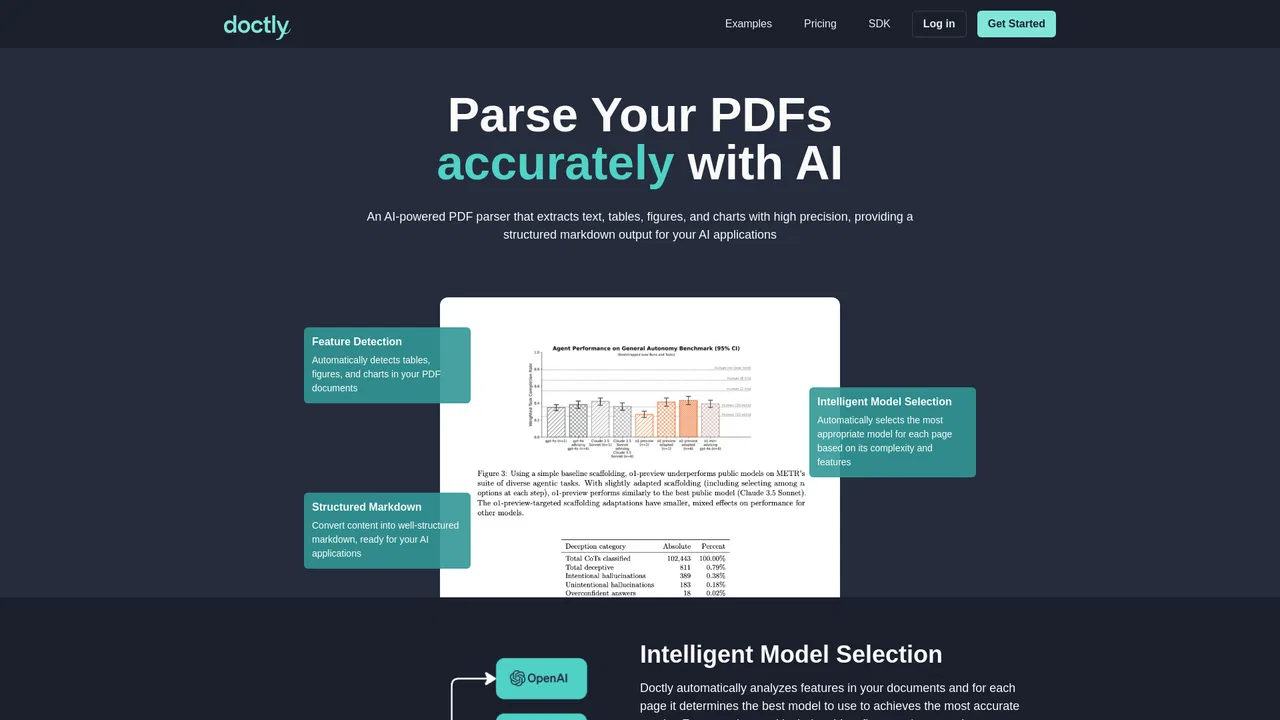
| 5 | Doctly AI | 595 | -79.8% | 직접 유입 39% | 무료+유료 | vs Doctly AI |
| 6 | LandingAI | 3.89만 | -12.3% | 직접 유입 37% | 무료+유료 | vs LandingAI |
AnyParser by CambioML turns PDFs, presentations, images and web pages into clean, structured, LLM-ready data while keeping sensitive values protected. It is designed for teams that need reliable extraction, not just a demo.

특화 강점이메일·PDF·문서를 구조화된 JSON으로 변환하는 LLM 기반 파서

Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.
Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.