로딩 중…

https://evalmy.ai
라이브 사이트 열기 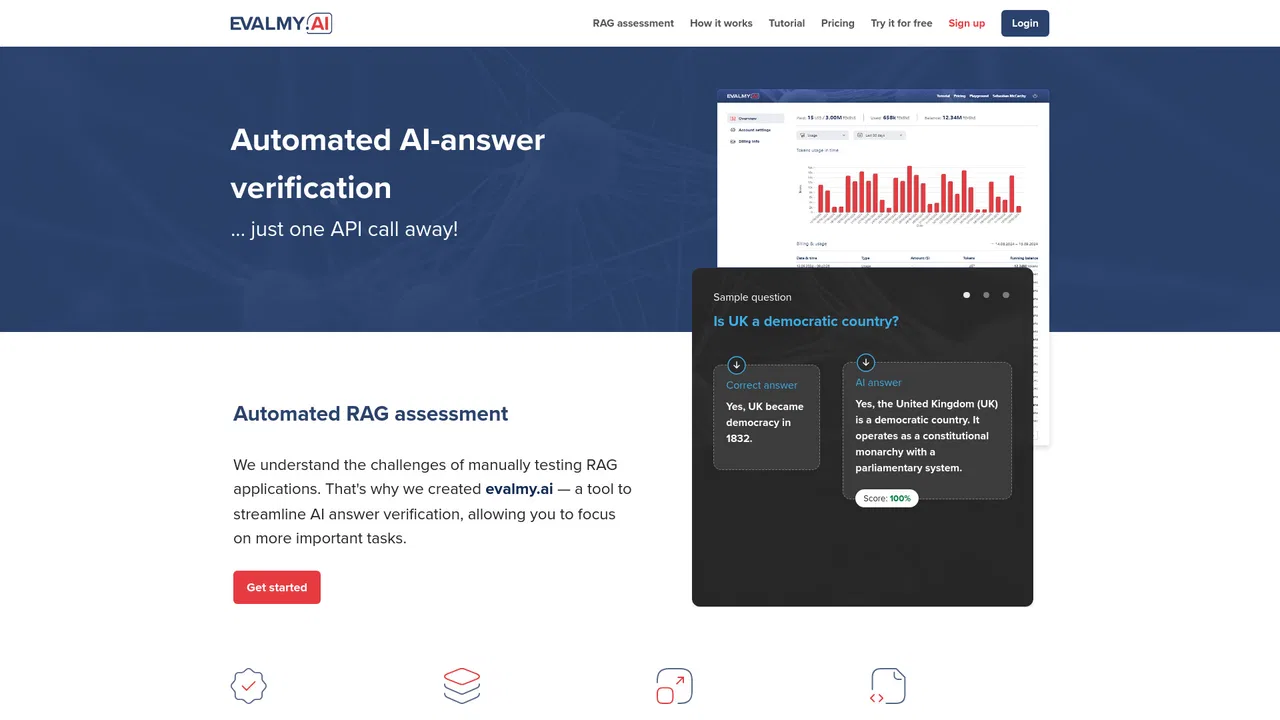
4.3 / 5에디터 평점평가 기준
- 실용성
- 4.4
에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, EvalMy.AI(evalmy.ai)은(는) AI 테스팅에 색인된 AI 플랫폼으로 월 0회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +0(0%)입니다. 주요 지리적 시장은 글로벌(트래픽 점유율 —)이며, 무료+유료 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 Exa (월 106.26만회 방문), Confident AI (월 8.34만회 방문), Scale (월 61.69만회 방문) 등이 있습니다.
RAG 답변 평가 자동화에 딱입니다.
API 연동이 깔끔해서 좋네요.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
완전성, 정확성, 모순 점검을 하나의 균형 잡힌 지표로 통합해 표면적 유사도를 넘어선 품질을 평가합니다.
어떤 언어나 워크플로에서도 평가 엔드포인트를 호출해 답변 검증을 개발 및 CI/CD 프로세스에 포함할 수 있습니다.
evalmyai 클라이언트를 가져와 기대/실제 답변 쌍을 전달하면 Python 코드에서 구조화된 평가 결과를 받습니다.
기본 제공 검증에 더해 조정 가능한 의미 점수 설정으로 위험 프로필에 맞게 엄격도를 바꿀 수 있습니다.
모델 수, 질문 세트 규모, 테스트 빈도에 따라 용량이 자동으로 증감하며 인프라 관리가 필요 없습니다.
EvalMy.AI는 LLM과 검색 증강 생성(RAG) 기능을 제공하는 팀을 위해 Profinit의 데이터 사이언스 팀이 만든 클라우드 기반 테스트 도구입니다. 사람이 직접 채점하는 대신 기대 답변과 실제 답변 쌍을 전송하면 점수화된 결과를 받을 수 있습니다. 점수는 C3-Score가 산출하며, 이 정성적 지표는 좋은 답변을 세 가지 관점으로 분해합니다. 완전성(중요한 사실이 빠지지 않음), 정확성(불필요하거나 지어낸 정보가 없음, 즉 환각 없음), 모순(답변 내부에 논리적 불일치가 없음)입니다.
이 제품은 독립형 대시보드보다 기존 시스템에 내장되는 방식에 적합합니다. REST API를 통해 어떤 언어나 파이프라인에서도 평가 엔드포인트를 호출할 수 있고, 공식 Python 클라이언트를 사용하면 코드 안에서 답변 쌍을 직접 평가할 수 있습니다. 점검이 일반 API 호출로 실행되므로 배포할 때마다 자동으로 트리거할 수 있어 CI/CD와 LangChain 같은 주요 ML 도구에 자연스럽게 통합됩니다. 설정 옵션을 통해 위험 프로필에 맞게 의미 점수 파라미터를 조정할 수 있습니다.
서비스는 SaaS로 제공되며 모델 수, 질문 세트 규모, 테스트 빈도에 따라 유연하게 확장됩니다. 요금은 토큰 기반으로, 얼리 어답터에게는 대규모 무료 토큰이 제공되고 추가 사용량은 소액 충전 패키지로 구매합니다.
모델이나 프롬프트를 변경할 때마다 고정 질문 세트를 자동 채점해 사용자에게 도달하기 전에 품질 저하를 잡아냅니다.
검색된 컨텍스트가 배포할 때마다 환각이나 내부 모순 없는 완전한 답변을 만드는지 확인합니다.
파이프라인에 채점 단계를 추가해 답변 품질이 임계값 아래로 떨어지면 빌드를 실패시킵니다.
후보 구성에 동일한 평가 세트를 실행하고 C3-Score 차이로 어떤 설정을 출시할지 결정합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | EvalMy.AI | 0 | 0% | — | 무료+유료 | 현재 도구 |
| 1 | Exa | 106.26만 | +16.8% | 직접 유입 57% | 무료+유료, 가격 문의 | vs Exa |
| 2 | Confident AI | 8.34만 | -3.3% | 직접 유입 35% | 무료+유료, 유료, 가격 문의 | vs Confident AI |
| 3 | Scale | 61.69만 | +12.5% | 직접 유입 31% | 가격 문의 | vs Scale |
| 4 | Maxim AI | 12.14만 | +10% | 직접 유입 32% | Contact for Pricing, Free Open Source | vs Maxim AI |
| 5 | AI or Not | 37.59만 | +12.3% | 직접 유입 18% | 무료+유료, 가격 문의 | vs AI or Not |
| 6 | Future AGI | 12.17만 | -7.8% | 직접 유입 59% | Freemium, Usage-based | vs Future AGI |
조직 전체의 LLM 평가, 관측성, 레드팀 테스트 기준을 통일
Scale is an enterprise AI company that supplies the data, evaluation and deployment layers behind production AI. Its Data Engine sources and labels training data for frontier models, its evaluation work benchmarks model capability, and its platform teams help enterprises and governments move AI systems from pilot into real operations.
Scale is an enterprise AI company that supplies the data, evaluation and deployment layers behind production AI. Its Data Engine sources and labels training data for frontier models, its evaluation work benchmarks model capability, and its platform teams help enterprises and governments move AI systems from pilot into real operations.

무료 / 오픈소스Maxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.
무료 / 오픈소스Maxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.

무료 / 오픈소스스스로 개선되는 AI 에이전트를 구축·시뮬레이션·평가·모니터링
무료 / 오픈소스스스로 개선되는 AI 에이전트를 구축·시뮬레이션·평가·모니터링

무료 / 오픈소스AI 플랫폼 팀을 위한 에이전트 관측성, 평가, 거버넌스
한 번의 API 호출로 어떤 웹사이트에서든 깨끗한 구조화 데이터 추출
음성·채팅 에이전트를 위한 보안 계층: 테스트, 레드팀, 모니터링


