
217.1만/월
30개 이상의 주요 AI 모델과 하나의 깔끔한 워크스페이스에서 대화
무료+유료

에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, Non finito(nonfinito.xyz)은(는) AI 모델에 색인된 AI 플랫폼으로 월 0회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +0(0%)입니다. 주요 지리적 시장은 글로벌(트래픽 점유율 —)이며, 무료+유료 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 Chatbot App (월 217.09만회 방문), Future AGI (월 12.17만회 방문), Appen (월 66.58만회 방문) 등이 있습니다.
여러 모델 동시에 비교하기 진짜 편해요.
무료 한도 조금만 더 늘려줬으면.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
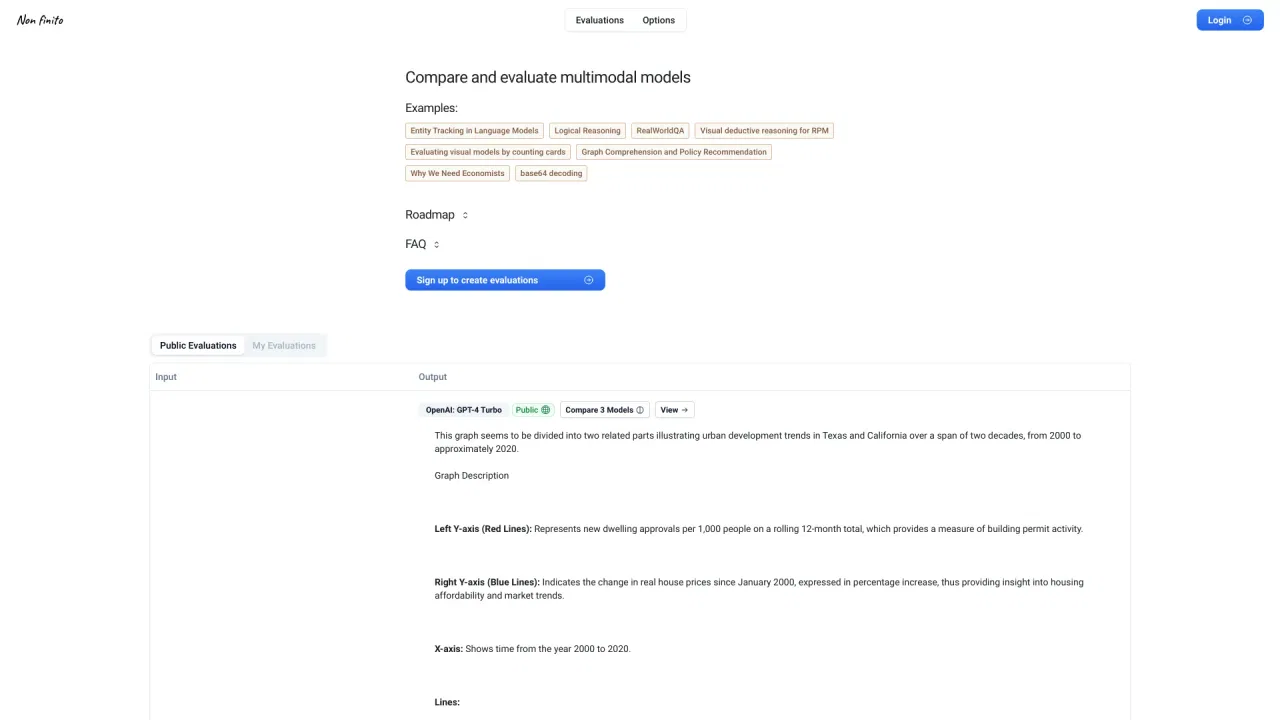
하나의 프롬프트를 여러 모델에 실행해 출력을 병렬 열로 읽고, 규모가 큰 비교에는 다중 모델 보기를 사용합니다.
각 답변에 통과 또는 실패를 표시해 대화 기록을 장기 추적 가능한 모델 행동 자료로 만듭니다.
평가를 워크스페이스에 보관하거나 공개해 다른 사람이 프롬프트와 결과를 검토·재사용하게 할 수 있습니다.
예시 평가는 텍스트뿐 아니라 언어 추론, 시각 유추, 계수, 그래프 이해, 구조적 디코딩을 다룹니다.
공개 평가에는 OpenAI o1, DeepSeek R1, Qwen QwQ 32B Preview, xAI Grok 2 등이 동일 입력으로 등장합니다.
Non finito는 모델 품질을 당연시하지 않고 측정 대상으로 다룹니다. 기본 흐름은 단순합니다. 프롬프트를 쓰고, 두 개 이상의 모델을 고르고, 답변을 나란히 읽습니다. 공개된 평가에는 큰 수의 최소 홀수 소인수를 찾는 추론 퍼즐, 시각적 연역 추론과 실제 세계 QA, RPM 형식의 시각적 유추, 카드 세기 과제, 그래프 이해와 정책 제안, 엔터티 추적, base64 디코딩 등이 포함되며 OpenAI o1, DeepSeek R1, Qwen QwQ 32B Preview, xAI Grok 2 등이 동일 입력으로 비교됩니다.
단순 비교를 넘어 플랫폼은 답변마다 판정을 기록합니다. 평가에 통과 또는 실패를 표시할 수 있어, 대화 기록 묶음이 다시 볼 수 있는 스코어보드에 가까워집니다. 남의 과제로 만든 리더보드를 믿는 대신, 새 모델이 내 프롬프트에서 실제로 개선됐는지 추적할 수 있습니다.
평가는 자신의 워크스페이스에 비공개로 두거나 다른 사람이 보고 비교할 수 있도록 공개할 수 있으며, 사이트는 방문자에게 가입해 직접 평가를 만들도록 안내합니다. 가벼운 연구 도구이므로 자동 채점 파이프라인을 갖춘 기업용 평가 제품군이 아니라 집중된 인터페이스를 기대해야 합니다.
신규 모델 공개 후 내 프롬프트 세트를 다시 실행해 일반 벤치마크 대신 이전 버전과 판정을 비교합니다.
제품에 중요한 프롬프트와 결과를 한곳에 두어 공급자가 모델을 업데이트할 때 성능 회귀를 바로 확인합니다.
같은 지시를 여러 상용·오픈 모델에서 실행해 내 추론·비전 과제에 어떤 모델이 맞는지 확인합니다.
전체 추론 과정을 나란히 보여주는 공개 평가는 모델 행동과 실패 유형을 가르치기에 유용합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | Non finito | 0 | 0% | — | 무료+유료 | 현재 도구 |
| 1 | Chatbot App | 217.09만 | -9.7% | 직접 유입 23% | 무료+유료 | vs Chatbot App |
| 2 | Future AGI | 12.17만 | -7.8% | 직접 유입 59% | Freemium, Usage-based | vs Future AGI |
| 3 | Appen | 66.58만 | +0.2% | 직접 유입 36% | 가격 문의 | vs Appen |
| 4 | Label Studio | 13.72만 | -16.1% | 직접 유입 34% | 가격 문의, 무료 | vs Label Studio |
| 5 | ModelScope | 308.54만 | +5.1% | 직접 유입 68% | 무료 | vs ModelScope |
| 6 | CanIRun.ai | 28.49만 | -20.1% | 직접 유입 48% | 무료 | vs CanIRun.ai |
30개 이상의 주요 AI 모델과 하나의 깔끔한 워크스페이스에서 대화

무료 / 오픈소스스스로 개선되는 AI 에이전트를 구축·시뮬레이션·평가·모니터링
무료 / 오픈소스스스로 개선되는 AI 에이전트를 구축·시뮬레이션·평가·모니터링

무료 / 오픈소스Label Studio is an open-source data labeling and AI evaluation platform from HumanSignal. It handles images, video, audio, text, documents, time series and agent traces in one flexible workspace, and connects to your ML pipeline through an API, Python SDK and webhooks.
무료 / 오픈소스Label Studio is an open-source data labeling and AI evaluation platform from HumanSignal. It handles images, video, audio, text, documents, time series and agent traces in one flexible workspace, and connects to your ML pipeline through an API, Python SDK and webhooks.
무료 / 오픈소스ModelScope (魔搭社区) is an open-source AI community and model service platform that hosts thousands of pretrained models, datasets, and ready-to-run demos, backed by Alibaba Cloud infrastructure.
무료 / 오픈소스ModelScope (魔搭社区) is an open-source AI community and model service platform that hosts thousands of pretrained models, datasets, and ready-to-run demos, backed by Alibaba Cloud infrastructure.
특화 강점내 GPU나 Mac이 실제로 돌릴 수 있는 로컬 AI 모델 확인
Suprmind is a multi-model decision intelligence platform that runs five frontier AIs in a single conversation, lets them challenge each other's answers, and exports the result as a shareable decision document.

소프트웨어와 인간 전문가가 함께 일하는 엔터프라이즈 AI 인프라
Wikis.ai is a multi-model AI workspace where one question goes to several leading models at once and the answers appear side by side. It pairs a model-comparison chat with a deep-research mode that scans the web and assembles a sourced report, plus an AI Wiki of editorially structured explainers. You keep one credit balance covering chat, research and reports.
Wikis.ai is a multi-model AI workspace where one question goes to several leading models at once and the answers appear side by side. It pairs a model-comparison chat with a deep-research mode that scans the web and assembles a sourced report, plus an AI Wiki of editorially structured explainers. You keep one credit balance covering chat, research and reports.