
무료+유료, 유료, 가격 문의
로딩 중…
ByteDance Seed 음성·음악 모델을 다루는 독립 가이드 겸 생성 콘솔
에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, Seed Audio AI(seedaudioai.ai)은(는) AI API에 색인된 AI 플랫폼으로 월 0회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +0(0%)입니다. 주요 지리적 시장은 글로벌(트래픽 점유율 —)이며, 무료 체험, 가격 문의 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 ElevenLabs (월 4239.68만회 방문), Typecast AI (월 123.22만회 방문), Meta AI Demos (월 17.78만회 방문) 등이 있습니다.
음성 복제 퀄리티가 진짜 미쳤음. 써본 중에 손에 꼽음.
키 설정이 좀 번거로움.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
자연스러운 운율과 감정 제어를 갖춘 대규모 음성 합성이며, 짧은 참조 음성으로 제로샷 음성 복제를 지원합니다.
대규모 언어 모델 기반 자동 음성 인식으로 억양, 언어, 배경 소음, 다양한 음향 환경에서도 정확도를 유지합니다.
스타일, 악기 구성, 편곡 방향을 세밀하게 지정할 수 있는 제어형 음악 제작과 편집.
Turbo TTS, Multilingual v2, Dialogue v3, Audio Isolation 등 KIE 오디오 엔드포인트를 브라우저에서 호출해 실제 음성을 생성하며 API 키는 서버에 보관됩니다.
Rachel, Adam, Bella 등 이름이 지정된 화자와 영어, 중국어, 일본어, 스페인어, 프랑스어, 한국어 등 언어를 제공해 글로벌 콘텐츠에 적합합니다.
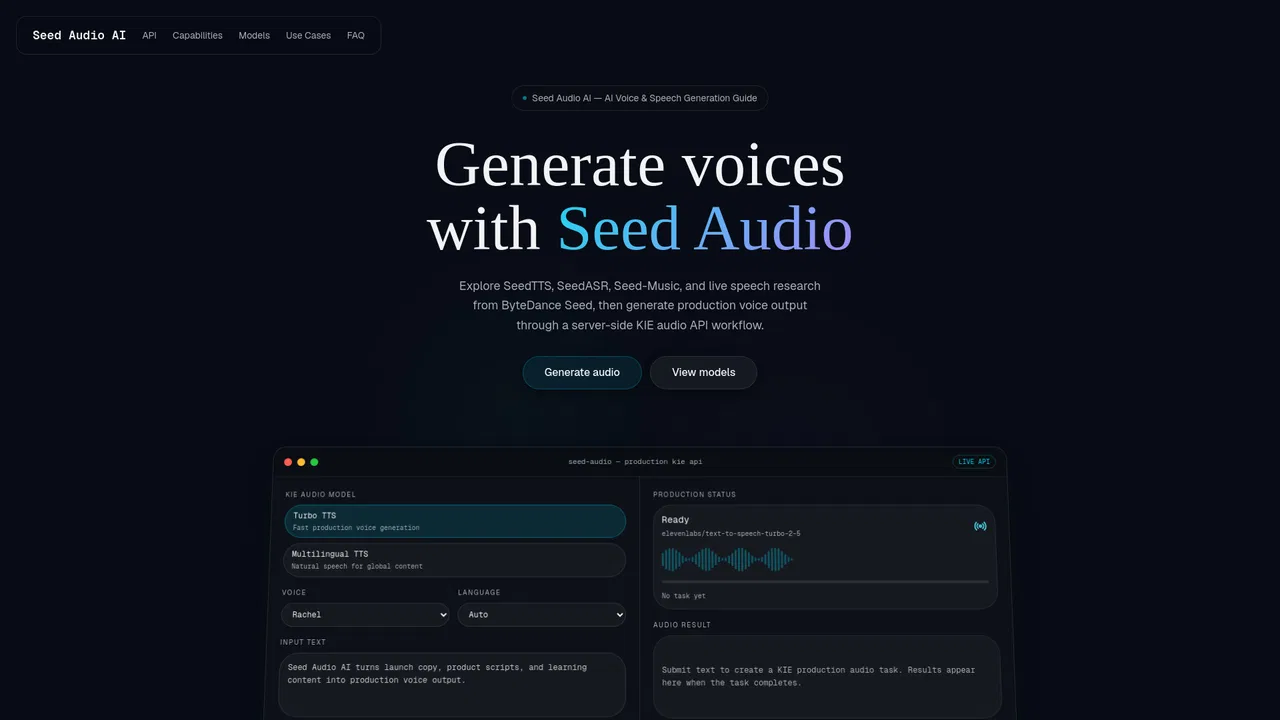
Seed Audio AI는 연구 자료와 실무 도구의 성격을 함께 지닙니다. ByteDance Seed의 각 오디오 모델이 무엇을 하는지 설명합니다. SeedTTS는 음성 합성과 음성 복제, SeedASR은 자동 음성 인식, Seed-Music은 제어 가능한 작곡, Live Interpretation은 실시간 음성 이해를 담당합니다. 그런 다음 내장 콘솔에서 실제 프로덕션 요청을 실행할 수 있습니다. 모델 카드와 비교 표, 활용 사례 정리가 있어 첫 프롬프트를 입력하기 전에 적합한 모델을 고를 수 있습니다.
콘솔은 제품의 실무적인 절반입니다. 음성 스타일(Turbo TTS는 속도, Multilingual TTS는 자연스러운 다국어 음성)을 선택하고 Rachel, Adam, Bella, Antoni, Elli 같은 프리셋 화자를 지정한 뒤 언어를 고르고 최대 500자 텍스트를 제출합니다. 요청은 text-to-speech-turbo-2-5, multilingual v2, dialogue v3, audio isolation 등 서버 측 KIE 오디오 API 엔드포인트로 라우팅되므로 API 자격 증명이 클라이언트에 남지 않습니다.
독립 가이드임을 분명히 밝히며 ByteDance나 BytePlus의 공식 제품이 아니라고 설명하고, ByteDance Seed Speech 페이지, Seed-TTS 논문, Seed-ASR 기술 보고서 같은 1차 자료로 연결합니다. 개발자, 현지화 팀, 교육 관계자, 콘텐츠 제작자는 자체 추론 인프라를 구축하지 않고도 Seed 오디오 성능을 평가하고 음성을 빠르게 만들 수 있습니다. 가격은 공개 요율표가 없으며 무료 체험을 중심으로 하고 대량 사용은 문의 기반으로 조정합니다.
영상, 팟캐스트, 오디오북용 내레이션을 만들고 자신의 목소리를 복제해 에피소드 전반에서 일관된 브랜드 보이스를 유지할 수 있습니다.
음성 인터페이스, 받아쓰기, 전사 기능을 위한 SeedTTS·SeedASR 평가. 콘솔로 프로토타입한 뒤 엔터프라이즈 API에 연결할 수 있습니다.
지역 억양을 담은 현지화 음성을 생성해 앱, 이러닝, 미디어 콘텐츠가 각 시장에 자연스럽게 어울리도록 합니다.
녹음 스튜디오 없이도 음성 강의, 발화 피드백, 접근성 친화적 교육 자료를 제작할 수 있습니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | Seed Audio AI | 0 | 0% | — | 무료 체험, 가격 문의 | 현재 도구 |
| 1 | ElevenLabs | 4239.68만 | +26.1% | 직접 유입 44% | 무료+유료, 유료, 가격 문의 | vs ElevenLabs |
| 2 | Typecast AI | 123.22만 | -3.9% | 직접 유입 53% | 무료+유료 | vs Typecast AI |
| 3 | Meta AI Demos | 17.78만 | +4.3% | 직접 유입 54% | 무료 | vs Meta AI Demos |
| 4 | Murf AI | 51.96만 | -2.8% | 직접 유입 44% | 무료+유료 | vs Murf AI |
| 5 | Voicemaker | 50.1만 | -11.3% | 직접 유입 21% | 무료+유료, 유료, 가격 문의 | vs Voicemaker |
| 6 | FineVoice | 40.15만 | -1.2% | 직접 유입 34% | 무료+유료 | vs FineVoice |
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
특화 강점수십 개 최고 개발 도구의 무료 크레딧과 할인을 모은 AI 개발자 혜택 번들
특화 강점수십 개 최고 개발 도구의 무료 크레딧과 할인을 모은 AI 개발자 혜택 번들

AudioPod AI is a browser-based audio studio that covers text to speech, voice cloning, podcast and audiobook production, music generation, stem separation, transcription and noise removal, with a developer API for embedding the same engine in your own product.
AudioPod AI is a browser-based audio studio that covers text to speech, voice cloning, podcast and audiobook production, music generation, stem separation, transcription and noise removal, with a developer API for embedding the same engine in your own product.
Uberduck is a synthetic voice and audio platform that turns text into speech, singing, and rapping, clones custom voices, and generates full AI music tracks in seconds — with API access for developers and 70+ supported languages.
실시간 AI 보이스 체인저, 복제, 음성 에이전트
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.


