

114.1만/월
주요 AI 영상·이미지 모델을 한 워크스페이스에서
가격 문의
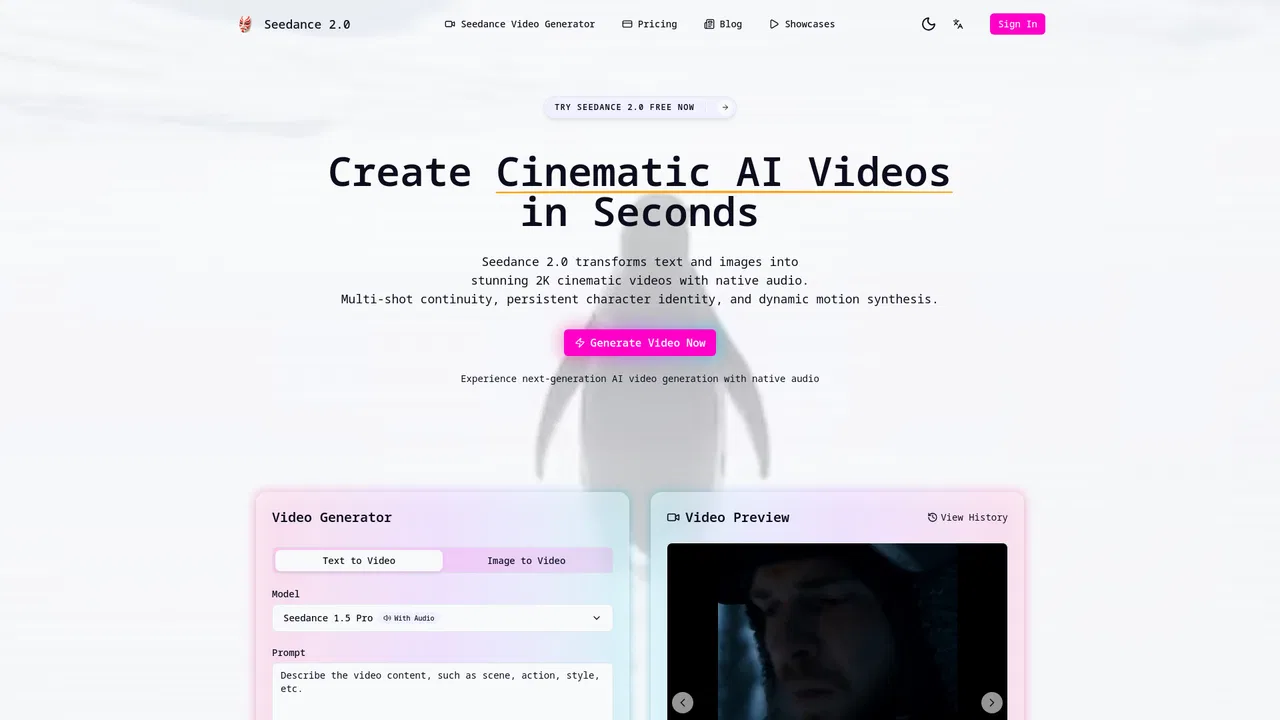
네이티브 오디오와 물리 인식 모션을 갖춘 텍스트·이미지 기반 영상 생성
월간 웹사이트 방문 수 추정치
Seedance 2.0은 ByteDance와 무관한 비공식 서드파티 래퍼 사이트로, 브랜드명을 도용해 검색 트래픽을 가로챕니다.
이 도메인의 Similarweb 추정치이며 활성 사용자 수가 아닙니다. 관측 데이터가 있는 월만 표시하며 수집일과 집계 월을 구분합니다.
수집일 2026. 11. 11.
에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, Seedance 2.0(seedance2.today)은(는) AI Video Generator에 색인된 AI 플랫폼으로 월 3.31천회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 -1.23천(-27.1%)입니다. 주요 지리적 시장은 미국(트래픽 점유율 64.3%)이며, 무료+유료, 유료 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 OpenGen (월 114.12만회 방문), Higgsfield (월 4712.79만회 방문), Luma Dream Machine (월 225.5만회 방문) 등이 있습니다.
공식 사이트인 척 하는 사기성 래퍼 사이트.
크레딧만 빨리 닳고 별로임.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
분위기, 카메라 앵글, 등장 캐릭터 수와 행동을 평이한 언어로 서술하면 최대 2,500자의 복잡한 다단 프롬프트를 처리합니다.
사진이나 일러스트를 업로드하면 머리카락이 날리고, 물결이 일고, 머리가 돌아가는 등 장면의 움직임을 모델이 판단하며 피부 질감, 주얼리, 원단 디테일을 유지합니다.
오디오와 영상을 함께 생성합니다. 동기화된 입 모양, 동작에 맞는 효과음, 설정에 어울리는 환경음을 별도 후처리 없이 구현합니다.
ByteDance는 불가능한 움직임에 페널티를 주는 물리 인식 훈련을 도입하여 옷이 자연스럽게 드리우고, 물이 적절한 무게로 튀며, 캐릭터가 걸을 때 균형을 유지합니다.
Seedance 2.0, Seedance 2.0 Fast, Seedance 1.5 Pro, Kling 2.6, Kling 2.5 Turbo Pro, Nano Banana 2, Nano Banana Pro, Nano Banana, Z-Image Turbo를 한 대시보드에서 선택합니다.
Seedance 2.0은 모델 API 위에 구축된 독립형 서드파티 AI 영상·이미지 생성 플랫폼입니다. ByteDance나 공식 Seedance 팀과 제휴하거나 승인받지 않았음을 명시하며, ByteDance의 Seedance 모델과 몇몇 다른 주요 모델을 감싸는 워크플로를 제공할 뿐입니다. 사용자는 공식 릴리스가 아닌 독립 제품으로 봐야 합니다.
영상 측면에서 플랫폼은 Seedance 2.0을 중심으로 하며, 텍스트·이미지·영상·오디오 참조를 위한 통합 멀티모달 아키텍처 위에 구축되었습니다. 텍스트나 시작 이미지에서 생성할 수 있고, 네이티브 오디오, 물리 인식 모션, 참조 기반 제어를 갖추며 길이는 최대 약 15초입니다. 사이트는 출력에 대해 솔직합니다. Seedance 2.0은 네이티브로 480p와 720p를 렌더링하며 지원되지 않는 2K나 4K 출력을 주장하지 않습니다.
Seedance 외에도 대시보드는 약 10개의 모델 - Seedance 2.0 Fast, Seedance 1.5 Pro, 두 개의 Kling 영상 모델, 세 개의 Nano Banana 이미지 모델, Z-Image Turbo - 을 구동하여 용도에 맞게 모델을 선택할 수 있습니다. 캐릭터 대사는 동기화된 입 모양으로 생성되고, 효과음은 동작에 맞춰 나며, 배경 앰비언스는 설정에 어울립니다. 가격은 프리미엄 크레딧 기반이며 플랫폼의 모든 모델에서 공통으로 사용됩니다.
대사, 효과음, 앰비언스를 같은 패스에서 생성하여 소셜 클립과 숏폼 영상을 빠르게 만듭니다.
한 장의 정지 이미지를 머리카락, 물, 고개 돌림 등의 움직임으로 바꾸면서 세부 디테일을 유지합니다.
Seedance 2.0 Fast와 다른 모델로 스토리 비트와 오디오 우선 영상 아이디어를 빠르게 반복합니다.
한 대시보드에서 영상 모델과 이미지 모델(Nano Banana, Z-Image)을 전환하여 다양한 자산을 제작합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | Seedance 2.0 | 3.31천 | -27.1% | 직접 유입 40% | 무료+유료, 유료 | 현재 도구 |
| 1 | OpenGen | 114.12만 | +802.8% | 직접 유입 6% | 가격 문의 | vs OpenGen |
| 2 | Higgsfield | 4712.79만 | +16.2% | 직접 유입 54% | 무료+유료, 무료 체험 | vs Higgsfield |
| 3 | Luma Dream Machine | 225.5만 | -2.4% | 직접 유입 37% | 무료+유료 | vs Luma Dream Machine |
| 4 | Seeddance | 3.42만 | -16.1% | 직접 유입 41% | 무료+유료 | vs Seeddance |
| 5 | FreeWanVideo | 8.33만 | -47.9% | 직접 유입 57% | 무료+유료 | vs FreeWanVideo |
| 6 | Creen AI | 188.84만 | -5.8% | 직접 유입 47% | 무료+유료, 무료 | vs Creen AI |
주요 AI 영상·이미지 모델을 한 워크스페이스에서
시네마틱 영상과 이미지를 위한 AI 네이티브 제작 스위트
텍스트-투-비디오, 이미지-투-비디오 및 비주얼 제작을 위한 AI 크리에이티브 에이전트
시네마틱 AI 영상·이미지·음악을 한곳에서
WAN, Grok, Seedance, Veo 기반 무료 AI 영상 생성기
WAN, Grok, Seedance, Veo 기반 무료 AI 영상 생성기
로그인 없는 무료 AI 영상·이미지 생성기를 한 탭에서
텍스트와 이미지로 영화 같은 영상을 만드는 단일 멀티모달 AI 모델
텍스트와 이미지로 영화 같은 영상을 만드는 단일 멀티모달 AI 모델

올인원 AI 영상·이미지 생성 플랫폼

Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.



