Exa is a search API and web research tool designed for AI applications. It gives agents clean, structured, real-time web data with semantic search, crawling, enrichment and deep research from a single endpoint.

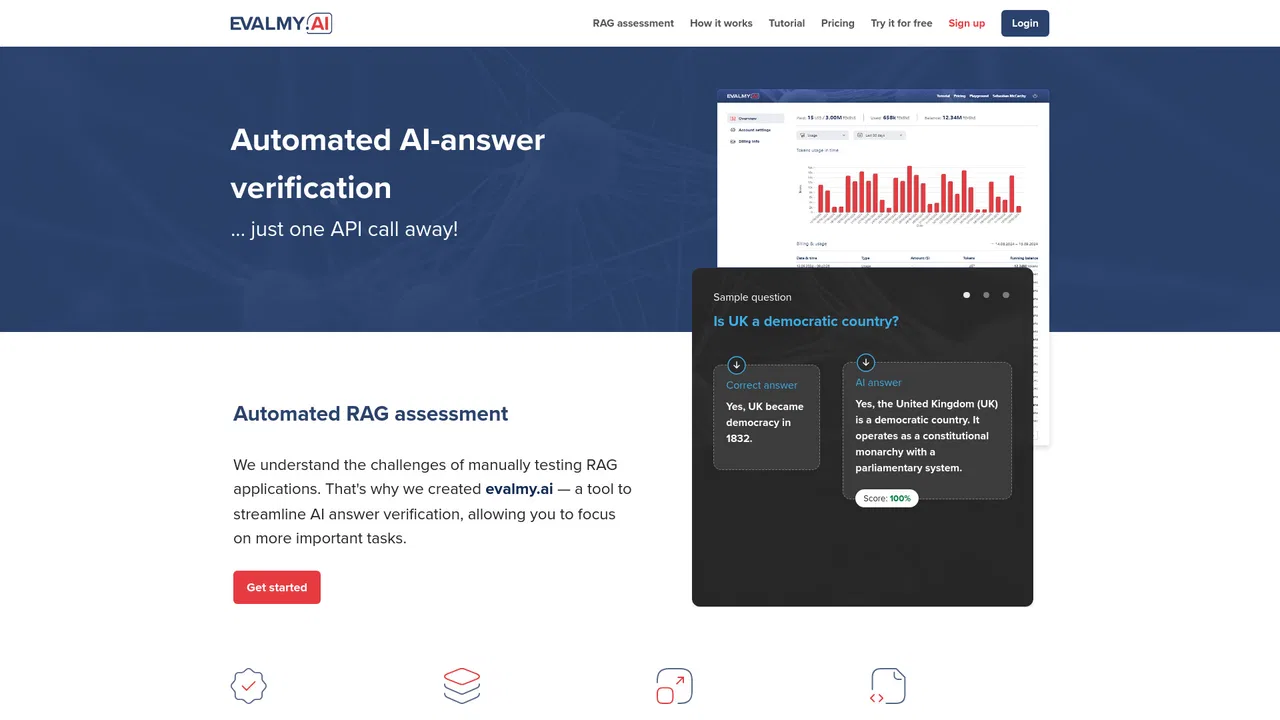
Verificação automática de respostas de IA com apenas uma chamada de API

É a avaliação da nossa equipe editorial, de 0 a 5, e não uma média de notas de usuários. Os pontos de vista desta página são escritos por IA com base no que sabemos sobre o produto. Não são avaliações de clientes.
Segundo a telemetria do OpenAITools.app verificada em 2026-11-11, EvalMy.AI (evalmy.ai) é uma plataforma de IA indexada em Testes com IA que gera 0 visitas mensais com variação de tráfego mês a mês de +0 (0%). Seu principal mercado geográfico é Global (— de participação no tráfego) e opera com modelo de preços Freemium. As principais alternativas concorrentes por volume mensal incluem Exa (1,06 mi visitas/mês), Confident AI (83,4 mil visitas/mês), Scale (616,92 mil visitas/mês).
Muito bom para validar testes de RAG.
SDK de Python bem documentada.
Perspectivas sintetizadas por IA com base na inspeção do site, preços e referências da categoria — não são depoimentos reais de clientes.
Uma métrica equilibrada que combina completude, correção e contradição, avaliando a resposta além da similaridade superficial.
Chame o endpoint de avaliação de qualquer linguagem ou fluxo de trabalho e inclua a verificação de respostas nos processos de desenvolvimento e CI/CD.
Importe o cliente evalmyai, envie pares de respostas esperada/real e receba um resultado estruturado diretamente no seu código Python.
Validação pronta para uso mais ajustes de pontuação semântica permitem adaptar o rigor ao perfil de risco.
A capacidade cresce ou diminui conforme o número de modelos, o tamanho do conjunto de perguntas e a frequência de testes, sem gerenciar infraestrutura.
EvalMy.AI é uma ferramenta de testes em nuvem criada pela equipe de ciência de dados da Profinit para times que entregam recursos baseados em LLM e em geração aumentada por recuperação (RAG). Em vez de avaliar manualmente, você envia um par de respostas esperada e real e recebe uma pontuação. A pontuação é produzida pelo C3-Score, uma métrica qualitativa que decompõe uma boa resposta em três aspectos: completude (nada importante falta), correção (sem informação extra ou inventada, ou seja, sem alucinações) e contradição (sem inconsistência lógica dentro da resposta).
O produto foi pensado para ser embutido, e não usado como painel isolado. Uma API REST permite chamar o endpoint de avaliação a partir de qualquer linguagem ou pipeline, e um cliente Python oficial permite avaliar pares de respostas diretamente no código. Como as verificações são chamadas de API comuns, podem ser disparadas automaticamente a cada implantação, encaixando-se naturalmente em CI/CD e em ferramentas de ML populares como o LangChain. Opções de configuração permitem ajustar parâmetros de pontuação semântica conforme diferentes perfis de risco.
O serviço é oferecido como SaaS que escala conforme o número de modelos, o tamanho do conjunto de perguntas e a frequência de testes. O preço é por tokens: os primeiros adotantes recebem uma grande cota gratuita de tokens e o uso adicional é vendido em pequenos pacotes de recarga.
Pontue automaticamente um conjunto fixo de perguntas a cada mudança de modelo ou prompt para capturar regressões antes de chegarem ao usuário.
Verifique se o contexto recuperado gera respostas completas, sem alucinações nem contradições internas em cada implantação.
Adicione uma etapa de pontuação ao pipeline para que a build falhe quando a qualidade cair abaixo de um limite definido.
Execute o mesmo conjunto de avaliação em configurações candidatas e use as diferenças de C3-Score para decidir qual versão lançar.
Comparação de telemetria lado a lado de ferramentas de IA concorrentes na mesma categoria principal
| Classificação | Ferramenta de IA | Visitas mensais | Crescimento mensal | Participação do tráfego direto | Preços | Comparação direta |
|---|---|---|---|---|---|---|
| ● | EvalMy.AI | 0 | 0% | — | Freemium | Atual |
| 1 | Exa | 1,06 mi | +16,8% | 57% direto | Freemium, Preço sob consulta | vs Exa |
| 2 | Confident AI | 83,4 mil | -3,3% | 35% direto | Freemium, Pago, Preço sob consulta | vs Confident AI |
| 3 | Scale | 616,92 mil | +12,5% | 31% direto | Preço sob consulta | vs Scale |
| 4 | Maxim AI | 121,35 mil | +10% | 32% direto | Contact for Pricing, Free Open Source | vs Maxim AI |
| 5 | AI or Not | 375,86 mil | +12,3% | 18% direto | Freemium, Preço sob consulta | vs AI or Not |
| 6 | Future AGI | 121,74 mil | -7,8% | 59% direto | Freemium, Usage-based | vs Future AGI |

Exa is a search API and web research tool designed for AI applications. It gives agents clean, structured, real-time web data with semantic search, crawling, enrichment and deep research from a single endpoint.

Padronize a avaliação, observabilidade e red teaming de LLM em toda a organização
Scale is an enterprise AI company that supplies the data, evaluation and deployment layers behind production AI. Its Data Engine sources and labels training data for frontier models, its evaluation work benchmarks model capability, and its platform teams help enterprises and governments move AI systems from pilot into real operations.

Grátis / Código abertoMaxim AI is a platform for evaluating, testing, and monitoring AI applications, and the home of Bifrost, an open-source LLM gateway. It helps teams ship reliable AI features with tracing, evaluation, agent simulation, and production observability.

API multimodal de detecção de IA que sinaliza imagens, texto, áudio, vídeo e deepfakes sintéticos

Grátis / Código abertoConstrua, simule, avalie e monitore agentes de IA que se aperfeiçoam sozinhos

Uma base de busca construída com embeddings, rerankers e APIs de leitura

Grátis / Código abertoObservabilidade, avaliação e governança de agentes para times de plataforma de IA

Infraestrutura de agentes verificada para sistemas empresariais críticos
Uma chamada à API para extrair dados limpos e estruturados de qualquer site

Uma única chave de API para mais de 70 modelos de IA, 1.000+ APIs de dados e ferramentas web

A camada de segurança para agentes de voz e chat: testar, red team e monitorizar