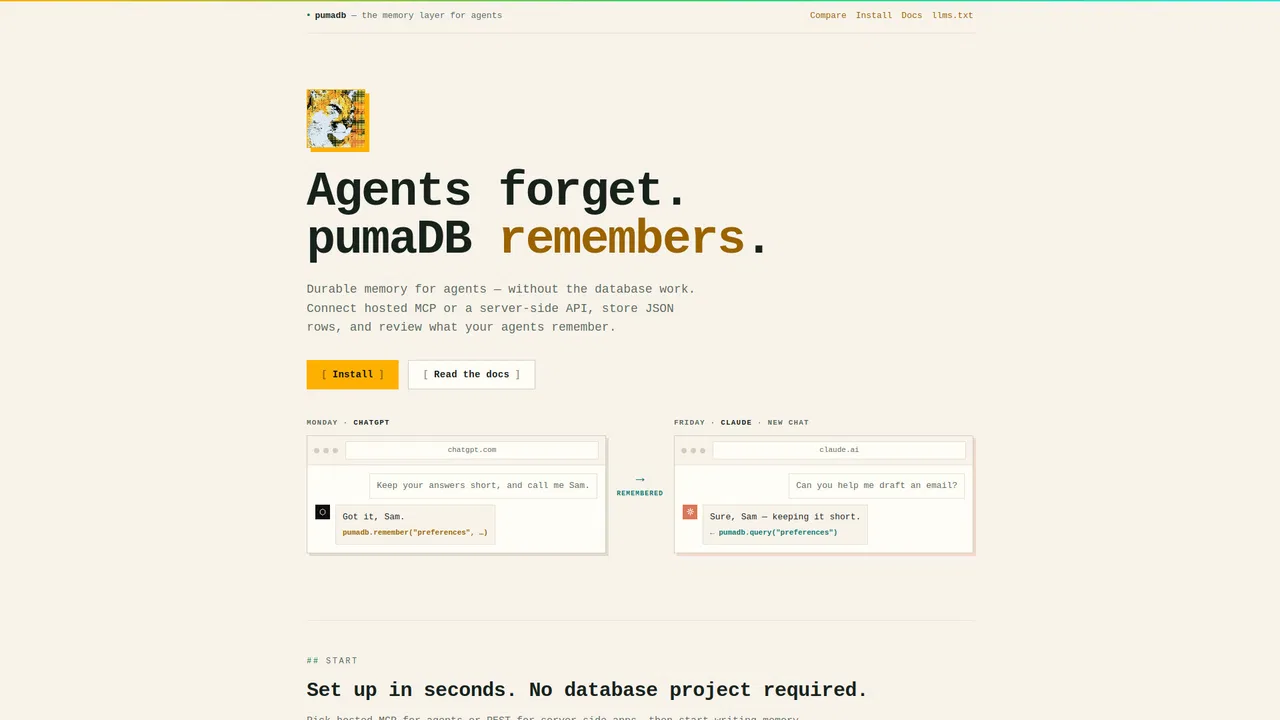
O pumaDB resolve um incômodo bem específico: todo assistente de IA começa cada conversa com amnésia. Você explica sua stack, suas convenções e o bug que está perseguindo, fecha a aba e, no dia seguinte, explica tudo de novo. O pumaDB substitui esse ritual por um armazenamento de memória hospedado que fica fora de qualquer modelo ou fornecedor específico. Um fato gravado numa sessão do ChatGPT pode ser recuperado numa conversa totalmente nova do Claude, sem nada colado no meio.
Por dentro, é deliberadamente simples. A memória fica em tabelas nomeadas de pequenos registros estruturados — as categorias destacadas pela equipe são convenções de projeto, preferências do usuário, recortes de pesquisa, estado de tarefas, notas de passagem de bastão e referências técnicas já revisadas. O acesso se dá por dois caminhos: uma API REST com chaves bearer para backends, workers, CLIs e funções serverless sob seu controle, e um endpoint MCP hospedado em api/mcp ao qual Codex, ChatGPT, Claude, OpenClaw e outros clientes HTTP em streaming se conectam via login OAuth. As duas superfícies operam nas mesmas tabelas e linhas.
O grande atrativo é a ausência de configuração. Não há projeto de banco de dados para provisionar, migração de esquema para acompanhar nem chave de API para colar no cliente — o login por e-mail cuida do OAuth nas conexões MCP. O serviço é mantido por uma equipe pequena com base em Melbourne e atende tanto quem quer que seus agentes se lembrem quanto equipes que buscam uma memória organizacional compartilhada.