
免费增值,付费,定价请咨询
加载中…
ByteDance Seed 语音与音乐模型的独立指南与生成控制台
这是编辑给出的评估,满分 5 分,不是用户打分的平均值。 本页的各方观点由 AI 根据产品信息归纳,不是真实用户的评价。
根据 OpenAITools.app 于 2026-11-11 核对的流量数据,Seed Audio AI(seedaudioai.ai)是一个收录在 AI API 下的 AI 平台,月访问量为 0,月度环比流量变化为 +0(0%)。其主要地理市场为全球(— 流量份额),采用免费试用,定价请咨询定价模式。按月流量计算的主要竞争替代方案包括 ElevenLabs(4239.68万次访问/月),Typecast AI(123.22万次访问/月),Meta AI Demos(17.78万次访问/月)。
声音克隆效果简直离谱,跟真人一模一样。
不用自己搭环境就能直接在网页测试。
API 额度扣得有点快。
文档写得跟天书一样。
以下短评基于实时网页探查、定价机制与同类产品基准由 AI 综合模拟生成,旨在呈现不同使用场景下的常见槽点与亮点,非实名真实用户评价。
大规模语音合成,具备自然韵律、情绪控制,并可基于简短参考音频实现零样本声音复刻。
基于大语言模型的自动语音识别,在口音、语言、背景噪声和复杂声学环境下保持较高准确率。
可控的音乐创作与编辑,支持细致的风格、乐器与编曲方向控制。
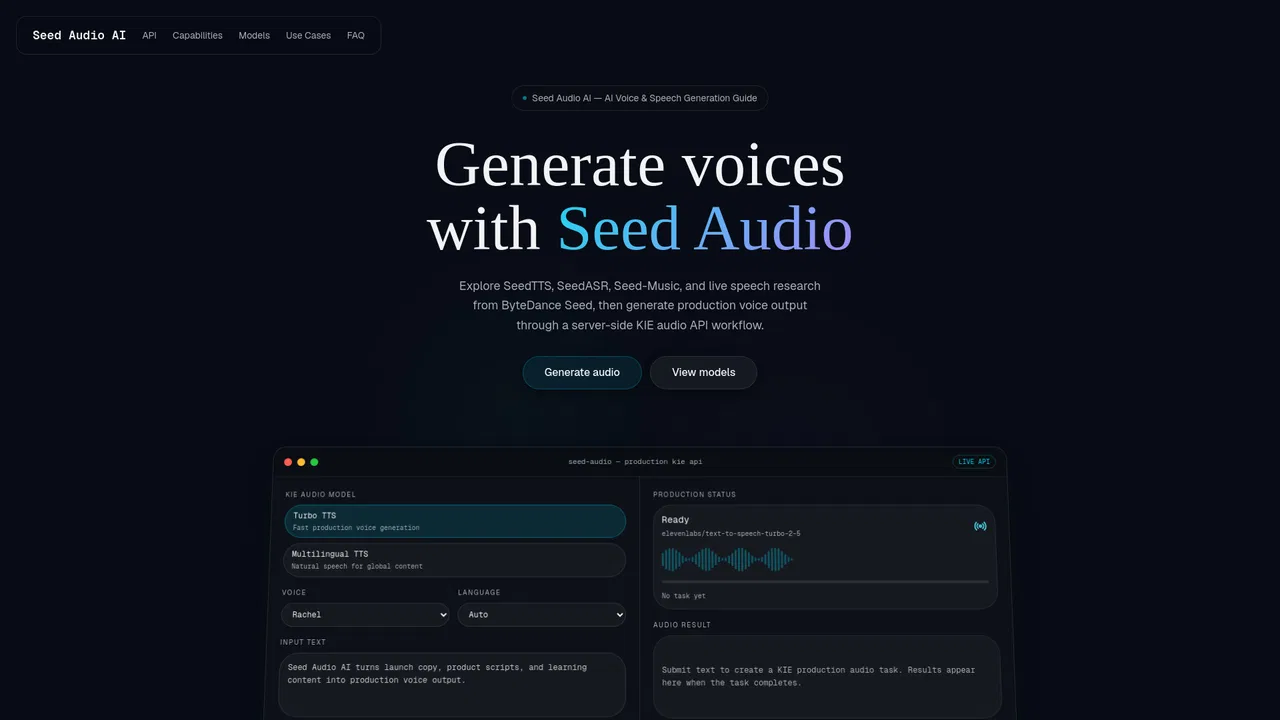
在浏览器中调用 KIE 音频端点(Turbo TTS、Multilingual v2、Dialogue v3、Audio Isolation)生成真实音频,API 密钥保留在服务端。
提供 Rachel、Adam、Bella 等命名音色,并支持英语、普通话、日语、西班牙语、法语、韩语等语言,适配全球化内容。
Seed Audio AI 兼具研究资料与实践工具两种角色。站点逐一说明 ByteDance Seed 各音频模型的能力——SeedTTS 负责语音合成与声音复刻、SeedASR 负责自动语音识别、Seed-Music 负责可控音乐创作、Live Interpretation 负责实时语音理解——并通过内置控制台让你真正跑起生产请求。模型卡片、对比表和场景拆解能帮你在输入第一条提示词之前就选对模型。
控制台是产品的实操部分。你可以选择语音风格(Turbo TTS 追求速度,Multilingual TTS 追求自然的全球化语音),从 Rachel、Adam、Bella、Antoni、Elli 等预设音色中挑选,指定语言,然后提交最多 500 个字符的文本。请求通过服务端 KIE 音频 API 端点转发,包括 text-to-speech-turbo-2-5、multilingual v2、dialogue v3 和 audio isolation,因此 API 凭证始终留在服务端。
作为独立指南,站点明确说明自己并非 ByteDance 或 BytePlus 的官方产品,并链接到 ByteDance Seed Speech 页面、Seed-TTS 论文、Seed-ASR 技术报告等一手来源。开发者、本地化团队、教育工作者和内容创作者可以用它评估 Seed 音频能力,并在不自建推理基础设施的前提下快速产出语音。价格方面没有公开费率表:整体以免费试用为主,更大用量通过联系沟通确定。
为视频、播客和有声书制作用于旁白,也可复刻自己的声音,让每期内容保持统一的品牌声线。
评估 SeedTTS 与 SeedASR 用于语音交互、听写和转写功能,可先用控制台做原型,再接入企业级 API。
生成带地区口音的本地化语音,让应用、在线课程和媒体内容在每个市场都显得地道。
无需录音棚即可制作语音课程、口语反馈和无障碍课程素材。
同一分类下同类 AI 工具的流量并排对比
| 排名 | AI 工具 | 月访问量 | 月度环比增长 | 直接流量占比 | 定价 | 头对头 |
|---|---|---|---|---|---|---|
| ● | Seed Audio AI | 0 | 0% | — | 免费试用,定价请咨询 | 当前产品 |
| 1 | ElevenLabs | 4239.68万 | +26.1% | 44% 直接流量 | 免费增值,付费,定价请咨询 | 对比 ElevenLabs |
| 2 | Typecast AI | 123.22万 | -3.9% | 53% 直接流量 | 免费增值 | 对比 Typecast AI |
| 3 | Meta AI Demos | 17.78万 | +4.3% | 54% 直接流量 | 免费 | 对比 Meta AI Demos |
| 4 | Murf AI | 51.96万 | -2.8% | 44% 直接流量 | 免费增值 | 对比 Murf AI |
| 5 | Voicemaker | 50.1万 | -11.3% | 21% 直接流量 | 免费增值,付费,定价请咨询 | 对比 Voicemaker |
| 6 | FineVoice | 40.15万 | -1.2% | 34% 直接流量 | 免费增值 | 对比 FineVoice |
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.
Typecast is an expressive AI voice generator and text-to-speech platform. Create natural, emotional voiceovers from text, clone your own voice, and generate audio for videos, podcasts, audiobooks, and apps, with a developer API and mobile app.
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
Voicemaker is a browser-based AI audio studio for text to speech, speech to speech, voice cloning, stem splitting and audio cleanup, offering 2,000+ AI voices across 130+ languages.
专项更强汇集数十家顶级开发工具的免费额度与折扣,为 AI 开发者提供一站式福利包
专项更强汇集数十家顶级开发工具的免费额度与折扣,为 AI 开发者提供一站式福利包
面向语音、播客与有声书的浏览器音频工作站
Uberduck is a synthetic voice and audio platform that turns text into speech, singing, and rapping, clones custom voices, and generates full AI music tracks in seconds — with API access for developers and 70+ supported languages.
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.
MiniMax Audio is the speech, voice and music generation suite inside MiniMax's platform. It turns scripts into studio-grade voiceovers, clones voices from short samples, isolates vocals and creates full songs, with an API for developers.


