
免费增值
加载中…
网站月访问量估算
Seedance 2.0 是一个采用 Seedance 模型家族的第三方视频生成与套壳托管平台。
数据为该域名的 Similarweb 流量估算,不是活跃用户数。仅展示有数据的统计月份;采集时间与流量统计月份分别标注。
采集于 2026年11月11日
这是编辑给出的评估,满分 5 分,不是用户打分的平均值。 本页的各方观点由 AI 根据产品信息归纳,不是真实用户的评价。
根据 OpenAITools.app 于 2026-11-11 核对的流量数据,Seedance 2.0(seedance2ai.video)是一个收录在 AI Video Generator 下的 AI 平台,月访问量为 2526,月度环比流量变化为 -348(-12.1%)。其主要地理市场为越南(53.6% 流量份额),采用免费增值,免费试用,付费定价模式。按月流量计算的主要竞争替代方案包括 Luma Dream Machine(225.5万次访问/月),Higgsfield(4712.79万次访问/月),Vidu(400.9万次访问/月)。
又是一个蹭大模型热度的套壳分销站,没啥技术含量的皮包网页。
生成速度一般,点数扣得飞快。
纯割韭菜的包装站。
勉强能用。
以下短评基于实时网页探查、定价机制与同类产品基准由 AI 综合模拟生成,旨在呈现不同使用场景下的常见槽点与亮点,非实名真实用户评价。
把自然语言提示词转成短片,或上传首帧并描述运动、镜头与氛围,实现更可控的静图动画。
生成与画面协调的人声与空间音效,口型对齐支持多种语言与方言。
构建叙事序列,让角色、场景与视觉风格在镜头切换间保持一致,而不是不断漂移。
可直接提示跟踪、横移与推拉镜头,让输出遵循导演式构图,而非单一固定取景。
导出富构图与氛围感的高清视频,面向广告、短剧、社媒短片与分镜流程。
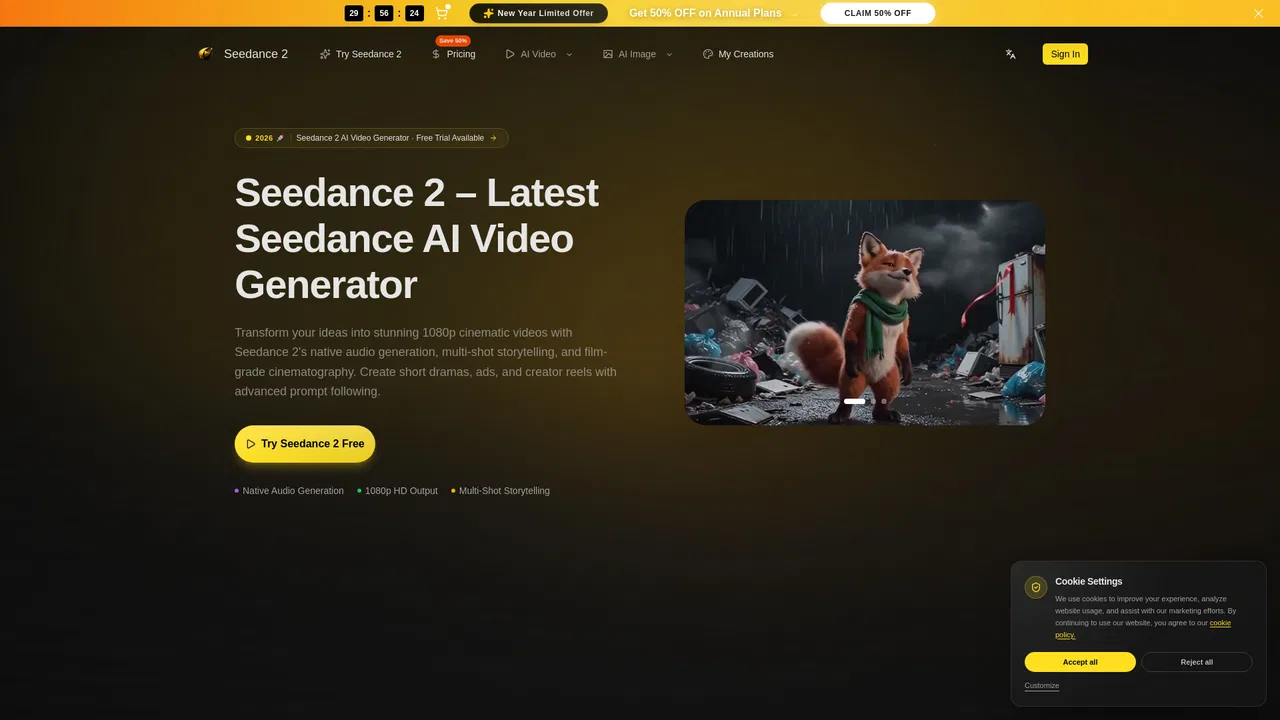
Seedance 2.0 是浏览器端的 AI 视频工作台,围绕两条标准流程展开:文本生视频,用自然语言描述场景;图生视频,上传首帧后再描述运动、镜头与氛围。平台宣称目标是电影级影像,并大量强调镜头语言支持——跟踪、横移、推拉等,让提示词可以像导演笔记一样书写,而不只是抽象描述。
其最具辨识度的能力是原生音频生成。它不会只给你一段必须另行配乐的无声片段,而是生成与画面协调的人声与空间音效,并对多种语言和方言保持口型对齐。正是这种组合,让带对白的短剧、带旁白的广告以及音乐类内容无需单独的音频后期即可成立。
另一项优势是多镜头连贯性。模型支持叙事序列,努力让主体、场景与视觉风格在镜头切换与时间跳跃中保持一致,直指许多生成视频工具常见的「人物漂移」问题。它也强调指令遵循,因此包含多角色、具体动作与镜头调度的复杂提示词能更贴近需求。输出为 1080p 高清,单次生成大致在数十秒到约一分钟之间,通过额度套餐售卖并可用免费试用起步。请注意,这是使用 Seedance 名称的第三方平台,并非底层模型开发方的官方渠道。
为 TikTok、Reels 与 Shorts 制作带吸睛转场的竖屏短片,并用同一创意生成多个变体测试不同开头与结尾。
生成具备商业级构图的主视觉镜头、产品揭示与生活场景,大幅压低实拍成本。
自动衔接叙事流程,让角色的情绪、表情与动作在多个场景中保持一致,适合迷你剧与剧集内容。
利用原生音频与唇形同步制作 MV 与音画联动视觉,让声音与画面始终对位。
同一分类下同类 AI 工具的流量并排对比
| 排名 | AI 工具 | 月访问量 | 月度环比增长 | 直接流量占比 | 定价 | 头对头 |
|---|---|---|---|---|---|---|
| ● | Seedance 2.0 | 2526 | -12.1% | 42% 直接流量 | 免费增值,免费试用,付费 | 当前产品 |
| 1 | Luma Dream Machine | 225.5万 | -2.4% | 37% 直接流量 | 免费增值 | 对比 Luma Dream Machine |
| 2 | Higgsfield | 4712.79万 | +16.2% | 54% 直接流量 | 免费增值,免费试用 | 对比 Higgsfield |
| 3 | Vidu | 400.9万 | +18.7% | 47% 直接流量 | 免费增值,付费 | 对比 Vidu |
| 4 | Omni AI Video | 5.37万 | +62.6% | 16% 直接流量 | 免费增值,付费 | 对比 Omni AI Video |
| 5 | Seeddance | 3.42万 | -16.1% | 41% 直接流量 | 免费增值 | 对比 Seeddance |
| 6 | Pixwith AI | 12.32万 | -8.3% | 48% 直接流量 | 免费增值,定价请咨询 | 对比 Pixwith AI |
面向电影级视频与图像的 AI 原生创作套件
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
Vidu is a multimodal generative video platform from ShengShu Technology. It turns text prompts, still images, and reference footage into short cinematic clips, with tools for subject-consistent characters, anime styles, and sound-effect generation.
一个多模态 AI 模型,实现电影感的文生视频与图生视频
一站式电影级 AI 视频、图像与音乐工作室
用文字与图片进行多模型 AI 视频生成——无需注册
一个工作台,汇聚主流 AI 视频与图像模型
一站式 AI 视频与图像生成平台
一站式 AI 视频、图像与智能体内容创作工作室
一个工作室,聚合顶级模型完成文生视频、图生视频、图像与对口型

Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.
Sea Imagine AI is a browser-based creative studio that unifies text-to-video, image-to-video, text-to-image, and image-to-image generation behind one interface. It gives creators access to a range of leading third-party generative models plus dedicated effects and editing tools, with a free credit allowance to get started.






