75.7万/月+9.6%
发现并自动修复漏洞的一体化应用安全平台
免费增值
这是编辑给出的评估,满分 5 分,不是用户打分的平均值。 本页的各方观点由 AI 根据产品信息归纳,不是真实用户的评价。
根据 OpenAITools.app 于 2026-11-11 核对的流量数据,TruVerifAI(truverif.ai)是一个收录在 AI 代码审查下的 AI 平台,月访问量为 0,月度环比流量变化为 +0(0%)。其主要地理市场为全球(— 流量份额),采用免费增值定价模式。按月流量计算的主要竞争替代方案包括 Aikido Security(75.75万次访问/月),Command Code(235.82万次访问/月),Bito(6.38万次访问/月)。
四大前沿模型互相吵架审代码,直接揪出隐藏并发Bug。
MCP工具链整合得相当丝滑。
跑大文件时速度稍微有点慢。
高风险代码的终极安全网。
以下短评基于实时网页探查、定价机制与同类产品基准由 AI 综合模拟生成,旨在呈现不同使用场景下的常见槽点与亮点,非实名真实用户评价。
每个请求都由来自 OpenAI、Anthropic、Google 和 xAI 的四个独立训练前沿模型评审,降低对单一模型盲点的依赖。
当模型出现分歧时,TruVerifAI 会让它们辩论并整合冲突,最终给出一个结论,而不是留给你四种互相矛盾的看法。
结果按严重度分级,让你快速判断哪些问题阻塞发布,哪些只是小问题。
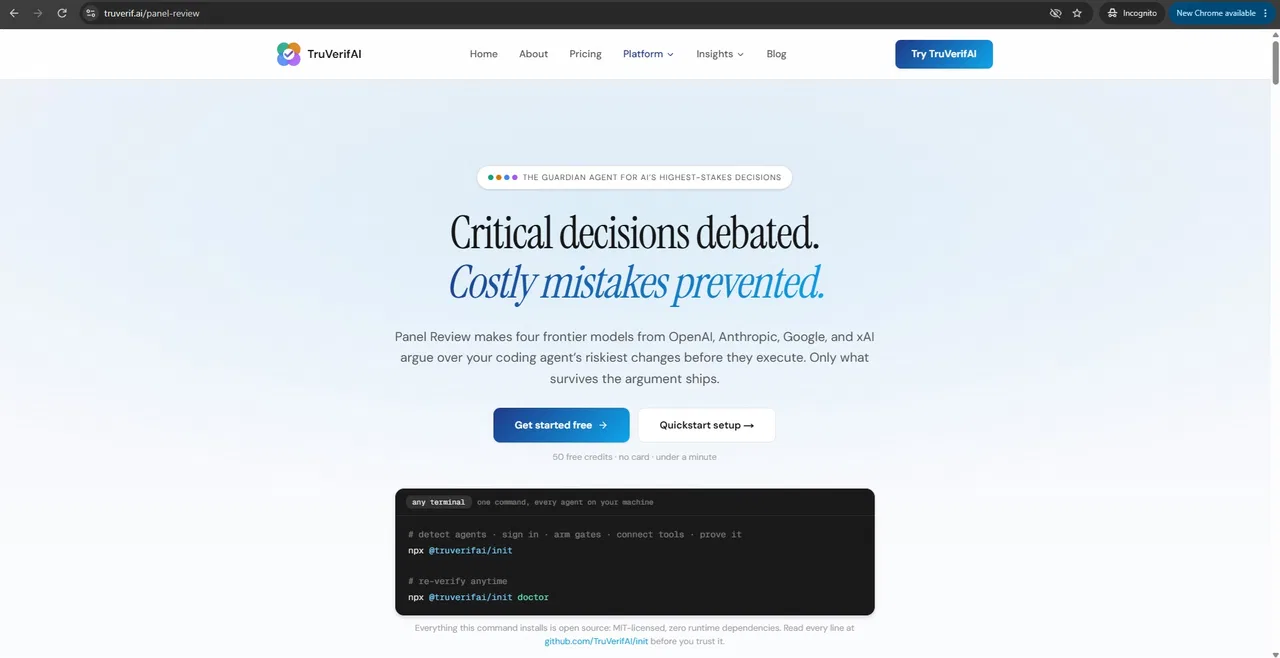
其 Panel Review 模式会拦截 AI 编码代理即将执行的变更,并在上线前交给评审团审查。
可通过应用、API 或编码代理内置的 MCP 工具使用,让验证融入你现有的工作流。
TruVerifAI 基于一个简单却有力的理念:任何单一模型都可能自信地出错,因此验证不应依赖某一个模型。平台不再信任单一评审者,而是同时启动四个前沿模型——分别来自 OpenAI、Anthropic、Google 和 xAI——让每个模型独立评估同一问题或同一代码变更。
随后模型之间会进行比对。当它们出现分歧时,TruVerifAI 会让它们主动辩论并协调冲突意见,最终形成统一结论。输出不是模糊的摘要,而是带严重度标记的发现,让你一眼看出某个问题是无关紧要还是阻塞发布。这对于它的“Panel Review”守护代理模式尤为有价值——该模式会在 AI 编码代理提交高风险变更之前介入。
由于 TruVerifAI 既作为独立应用,也以带 MCP 工具的 API 形式提供,它可以接入既有的开发者工作流——代码编辑器、代理和类 CI 流水线,而无需你更换工具链。其结果是跨厂商的第二意见,能够发现单一模型会轻易放过的错误。
在合并 AI 代理产出的变更前,先交给评审团审查,捕捉单一模型容易忽略的细微错误。
通过 MCP 工具为编码代理提供第二意见,让高风险编辑在落地前接受交叉检查。
借助多个前沿厂商的共识结论,减少对某一模型厂商输出的依赖。
提出棘手的架构或调试问题,获得协调后的答案,而非单一模型的最佳猜测。
同一分类下同类 AI 工具的流量并排对比
| 排名 | AI 工具 | 月访问量 | 月度环比增长 | 直接流量占比 | 定价 | 头对头 |
|---|---|---|---|---|---|---|
| ● | TruVerifAI | 0 | 0% | — | 免费增值 | 当前产品 |
| 1 | Aikido Security | 75.75万 | +9.6% | 40% 直接流量 | 免费增值 | 对比 Aikido Security |
| 2 | Command Code | 235.82万 | -12.1% | 74% 直接流量 | 免费增值,定价请咨询 | 对比 Command Code |
| 3 | Bito | 6.38万 | +9.8% | 22% 直接流量 | 免费增值,付费,定价请咨询 | 对比 Bito |
| 4 | CodeReviewBot.AI | 2515 | +97.1% | 40% 直接流量 | 免费增值,免费试用,付费,定价请咨询 | 对比 CodeReviewBot.AI |
| 5 | Macroscope | 10.62万 | +39.6% | 44% 直接流量 | 免费试用,付费,定价请咨询 | 对比 Macroscope |
| 6 | Hacktron | 12.55万 | -40.9% | 28% 直接流量 | 免费增值,付费,定价请咨询 | 对比 Hacktron |
发现并自动修复漏洞的一体化应用安全平台
会学习你编码品味的 AI 编程智能体

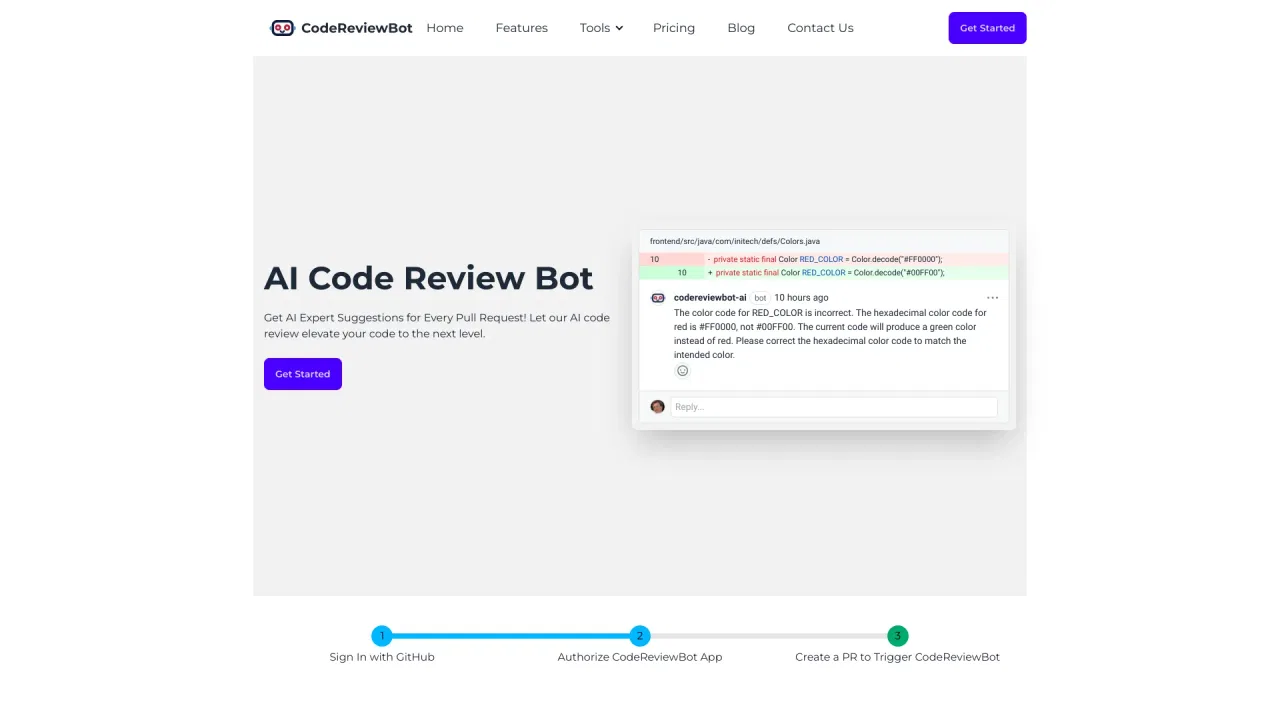
为每个 GitHub Pull Request 提供自动化 AI 代码审查
让每个代码仓库保持正轨的 AI 代码审查与状态更新
覆盖整个软件开发周期的智能体编排平台