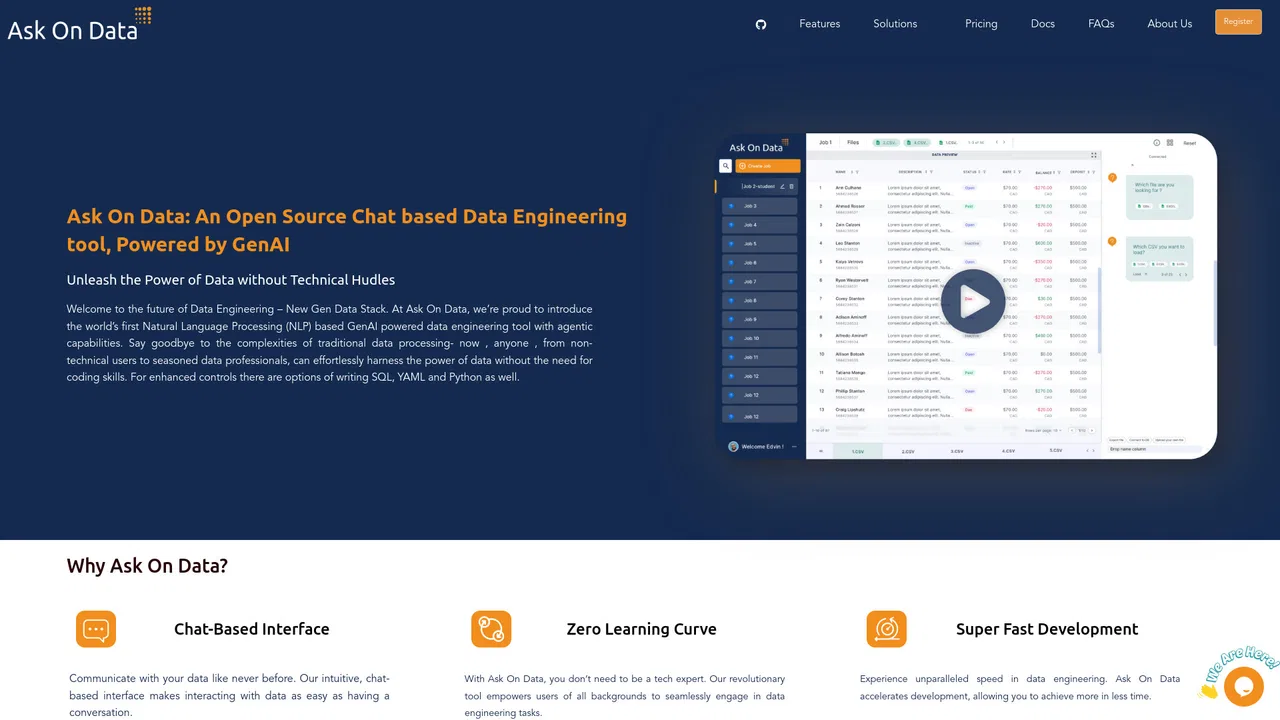
Ask On Data zielt auf den Teil der Datenarbeit, der historisch am meisten Zeremonie erforderte: von einer fachlichen Anforderung zu einer funktionierenden Pipeline zu kommen. Statt Transformationen von Hand zu verdrahten, formulieren Sie Ihren Bedarf in natürlicher Sprache, und ein Agent wandelt diese Absicht in eine strukturierte Pipeline um und zeigt nach jeder Anweisung eine Live-Vorschau der Daten. Neben dem Chat akzeptiert das Tool SQL, Python und direkte YAML-Bearbeitung, sodass Teams nicht eingeengt sind, wenn eine Transformation Präzision verlangt.
Die Plattform basiert auf Python und React; die erzeugten Pipelines sind Apache-Spark-Jobs, die orchestriert und geplant werden können. Zu den tragenden Komponenten gehören Langchain, Ollama und Airbyte. Jobs lassen sich manuell auslösen oder in fester Frequenz planen, mit Semantik für Voll-Load, inkrementellen Load oder Truncate-and-Load; der vollständige Aktionsverlauf liefert Auditierbarkeit und macht jeden Schritt rückgängig.
Ask On Data gibt es als quelloffenes Projekt und als Managed-Cloud-Service. Die Managed-Variante nimmt Infrastruktur- und Wartungsarbeit ab und erlaubt dennoch den Betrieb in einer Cloud Ihrer Wahl. Der Anbieter positioniert das Tool als deutliche Kosteneinsparung gegenüber traditionellen Data-Engineering-Stacks, vor allem weil Pipelines in einem Bruchteil der üblichen Zeit entstehen. Dokumentierte Einsatzfelder reichen von Datenintegration über Joins und Unions bis zu Bereinigung, Aufbereitung, eigenen Berechnungen und weitergehenden Transformationen.