01
757.491/Monat
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
KI-Code-ReviewRedaktionswert: 4.4Freemium+9,6 %

757.491/Monat+9,6 %
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
Freemium
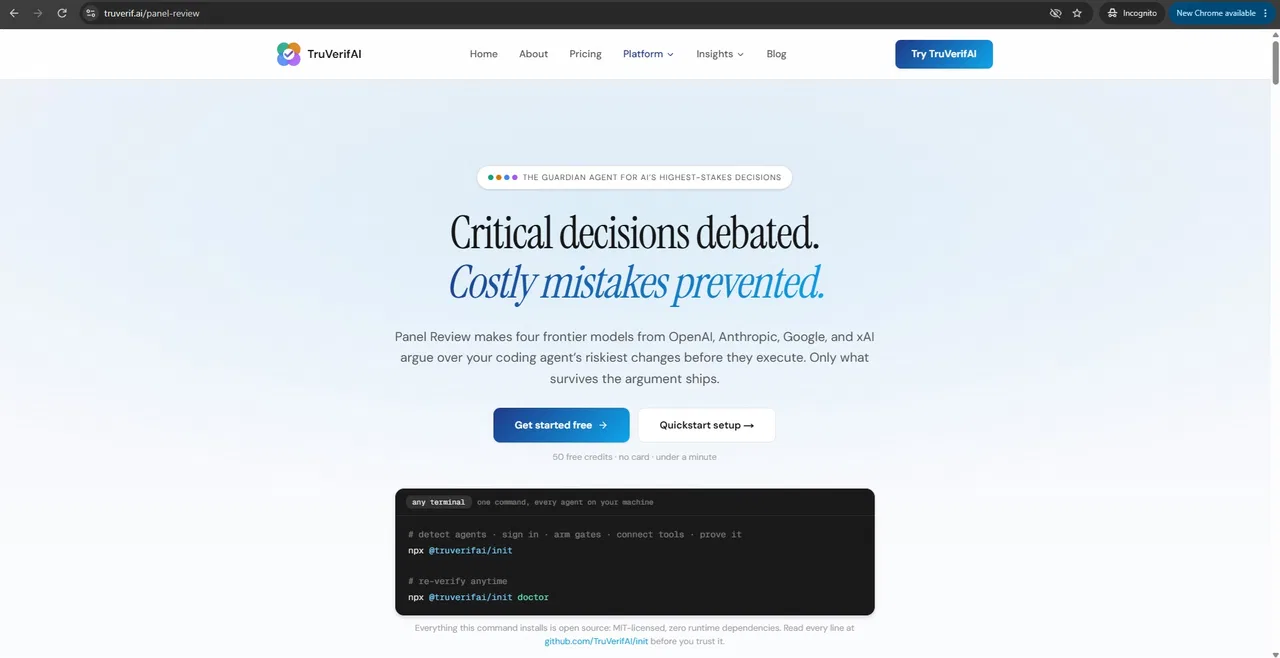
Vier Frontier-Modelle debattieren, damit riskante Code-Änderungen verifiziert ausgeliefert werden
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist TruVerifAI (truverif.ai) eine KI-Plattform, die unter KI-Code-Review indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Freemium“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Aikido Security (757.491 Besuche/Monat), Command Code (2,36 Mio. Besuche/Monat), Bito (63.829 Besuche/Monat).
Die Vier-Modell-Debatte fängt Bugs ab, die andere übersehen.
Etwas teuer, aber für kritischen Code jeden Cent wert.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Jede Anfrage wird von vier unabhängig trainierten Frontier-Modellen von OpenAI, Anthropic, Google und xAI geprüft, was die Abhängigkeit von den blinden Flecken eines einzelnen Modells verringert.
Wenn die Modelle uneins sind, lässt TruVerifAI sie den Konflikt ausdiskutieren und in einer Antwort zusammenführen, statt dir vier widersprüchliche Meinungen zu überlassen.
Ergebnisse werden nach Schweregrad klassifiziert, damit du schnell erkennst, welche Probleme einen Release blockieren und welche geringfügig sind.
Der Modus Panel Review fängt eine Änderung ab, die ein Coding-Agent gerade vornehmen will, und leitet sie vor der Auslieferung durch das Panel.
Nutze es in der App, über die API oder in deinem Coding-Agent mit integrierten MCP-Tools, damit die Verifikation in deinen bestehenden Workflow passt.
TruVerifAI beruht auf einer einfachen, aber starken Prämisse: Jedes einzelne Modell kann selbstsicher falschliegen, daher sollte Verifikation nicht von einem einzigen Modell abhängen. Statt einem einzelnen Prüfer zu vertrauen, startet die Plattform vier Frontier-Modelle – von OpenAI, Anthropic, Google und xAI – und gibt jedem dieselbe Frage oder vorgeschlagene Code-Änderung zur eigenständigen Bewertung.
Danach vergleichen die Modelle ihre Notizen. Wo sie sich widersprechen, lässt TruVerifAI sie den Punkt aktiv ausdiskutieren und widerstreitende Meinungen zu einem einzigen Urteil zusammenführen. Das Ergebnis ist keine vage Zusammenfassung, sondern mit Schweregrad-Tags versehene Befunde, sodass du sofort erkennst, ob ein Problem trivial ist oder einen Release blockiert. Besonders wertvoll ist dies im Modus „Panel Review“, einem Guardian-Agent, der eingreift, kurz bevor ein Coding-Agent eine riskante Änderung committet.
Da es sowohl als eigenständige App als auch als API mit MCP-Tools angeboten wird, fügt sich TruVerifAI in bestehende Entwickler-Workflows ein – Code-Editoren, Agents und CI-ähnliche Pipelines – statt eine neue Toolchain zu erzwingen. Das Ergebnis ist eine herstellerübergreifende zweite Meinung, die Fehler aufspürt, die ein einzelnes Modell bedenkenlos durchgewunken hätte.
Bevor du eine von einem KI-Agent erzeugte Änderung mergest, leite sie durch das Panel, um subtile Fehler zu finden, die ein einzelnes Modell übersehen würde.
Gib deinem Coding-Agent über MCP-Tools eine zweite Meinung, damit kritische Änderungen vor der Anwendung gegengeprüft werden.
Verringere die Abhängigkeit von der Ausgabe eines einzelnen Anbieters, indem du Konsens-Urteile mehrerer Frontier-Anbieter einholst.
Stelle eine knifflige Architektur- oder Debugging-Frage und erhalte eine abgestimmte Antwort statt der Vermutung eines einzelnen Modells.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | TruVerifAI | 0 | 0 % | — | Freemium | Aktuell |
| 1 | Aikido Security | 757.491 | +9,6 % | 40% direkt | Freemium | vs Aikido Security |
| 2 | Command Code | 2,36 Mio. | -12,1 % | 74% direkt | Freemium, Preise auf Anfrage | vs Command Code |
| 3 | Bito | 63.829 | +9,8 % | 22% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs Bito |
| 4 | CodeReviewBot.AI | 2515 | +97,1 % | 40% direkt | Freemium, Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs CodeReviewBot.AI |
| 5 | Macroscope | 106.170 | +39,6 % | 44% direkt | Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs Macroscope |
| 6 | Hacktron | 125.526 | -40,9 % | 28% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs Hacktron |
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt

Der Coding-Agent, der deinen Coding-Stil lernt
Der Coding-Agent, der deinen Coding-Stil lernt

Codebewusste KI-Codereviews und ein Modellrouter für Coding-Agenten
Codebewusste KI-Codereviews und ein Modellrouter für Coding-Agenten

Automatisierte KI-Code-Reviews für jeden GitHub-Pull-Request
Automatisierte KI-Code-Reviews für jeden GitHub-Pull-Request

KI-Code-Review und Status-Updates, die jedes Repository auf Kurs halten
KI-Code-Review und Status-Updates, die jedes Repository auf Kurs halten

AI-native Offensive Security: kontinuierliches Red Teaming, Whitebox-Pentests und PR-Review

Kostenlos / Open SourceMehrere Coding-Agenten parallel in einem gemeinsamen Workspace ausführen
Kostenlos / Open SourceMehrere Coding-Agenten parallel in einem gemeinsamen Workspace ausführen
32 Sicherheitsscanner in einem KI-gefilterten DevSecOps-Durchlauf
32 Sicherheitsscanner in einem KI-gefilterten DevSecOps-Durchlauf
Verwaltete Cloud-Agents für Coding, Review und Hintergrundarbeit
Verwaltete Cloud-Agents für Coding, Review und Hintergrundarbeit

Kostenlos / Open SourceOpen-Source-KI-Code-Review – selbst gehostet oder in der Cloud mit eigenen Modellschlüsseln
Kostenlos / Open SourceOpen-Source-KI-Code-Review – selbst gehostet oder in der Cloud mit eigenen Modellschlüsseln

Agenten-Orchestrierung für den gesamten Softwareentwicklungszyklus
Agenten-Orchestrierung für den gesamten Softwareentwicklungszyklus
Kostenlos / Open SourceEin lebendiger Index Ihrer Codebasis, den KI-Agenten und Pull Requests tatsächlich lesen können
Kostenlos / Open SourceEin lebendiger Index Ihrer Codebasis, den KI-Agenten und Pull Requests tatsächlich lesen können