무료
로딩 중…
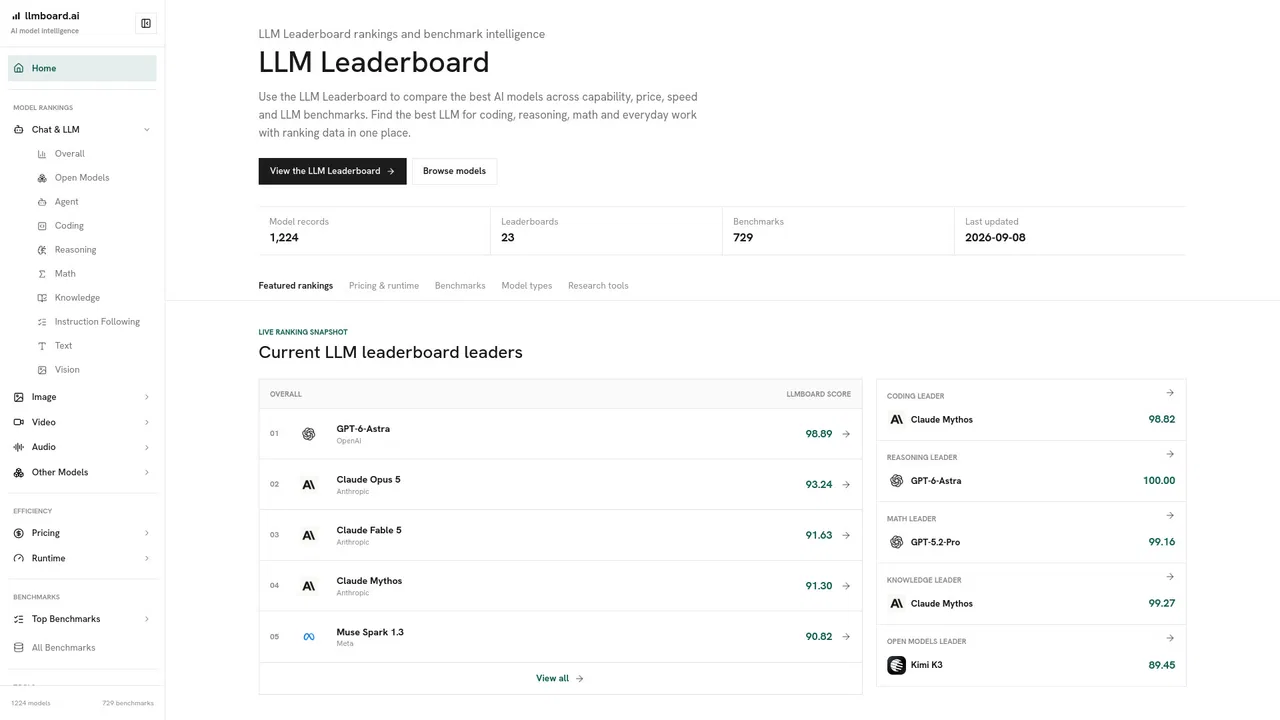
능력, 가격, 속도, 벤치마크를 비교하는 독립 LLM 리더보드
에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, LLMBoard.ai(llmboard.ai)은(는) Large Language Models (LLMs)에 색인된 AI 플랫폼으로 월 378회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +378(0%)입니다. 주요 지리적 시장은 미국(트래픽 점유율 100%)이며, 무료 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 Countless.dev (월 787회 방문), Models.dev (월 20.05만회 방문), LLM Price Check (월 8.26천회 방문) 등이 있습니다.
LLM 가격과 벤치마크 비교할 때 무조건 여기 씁니다.
정보가 깔끔하게 정리되어 있어요.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
종합 채팅, 코딩, 추론, 수학, 지식, 지시 준수, 에이전트는 물론 비전, 이미지, 비디오, 오디오, 임베딩까지 개별 순위를 제공해 실제 업무에 맞춰 비교할 수 있습니다.
GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval, MMMU-Pro 등 개별 평가를 원래 순위와 커버리지 정보와 함께 제공합니다.
채팅 토큰, 이미지, 비디오, 오디오 가격 화면과 비용 대비 능력 관계를 제시해 추가 지출이 실제로 더 나은 출력을 사는지 판단하게 합니다.
출력 속도와 지연 순위, 제공자 신뢰성 신호를 제공해 벤치마크 점수뿐 아니라 운영 측면까지 다룹니다.
벤더, 유형, 모달리티, 가격으로 필터링하는 카탈로그와 채점·커버리지·모델 매핑 규칙을 공개해 순위를 검증할 수 있습니다.
LLMBoard.ai는 몇 주마다 바뀌는 질문에 답합니다. 결국 어떤 모델을 써야 하는가입니다. 지속적으로 갱신되는 모델 레코드와 벤치마크 결과를 유지하고, 이를 작업 단위 리더보드로 제시합니다. 종합 채팅·LLM, 에이전트, 코딩, 추론, 수학, 지식, 지시 준수와 함께 비전, 이미지 생성·편집, 비디오, 음성 합성, 음성 인식, 임베딩 트랙이 별도로 있습니다. 각 순위는 GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval, MMMU-Pro 같은 구체적 벤치마크로 뒷받침됩니다.
단일 점수 순위와 다른 점은 신호를 의도적으로 분리한다는 것입니다. 능력 점수는 가격, 실행 지연, 제공자 신뢰성과 따로 제시되므로 벤치마크 1위 모델이 자동으로 가장 가성비가 좋거나 가장 안정적이라고 간주되지 않습니다. 채팅 토큰, 이미지, 비디오, 오디오 각각의 가격 페이지와 속도·신뢰성 화면도 있습니다. 점수 산정과 데이터 섹션은 모델 매핑과 채점 규칙을 공개하고, 각 벤치마크 페이지는 원래 순위와 커버리지를 보여주므로 순위의 근거를 확인할 수 있습니다.
대상은 특정 워크로드에 맞춰 모델을 평가하는 엔지니어링 팀, 프로덕트 매니저, 연구자, 그리고 오픈 모델과 최전선 폐쇄형 모델의 비교를 추적하는 독자입니다. 정보·비교 리소스이며 모델 자체를 호스팅하지 않으므로, 결과는 자체 테스트의 출발점으로 다루는 것이 적절합니다.
디렉터리에서 필터링하고 코딩·추론 선두 모델을 토큰 가격, 처리량과 대조해 품질과 예산을 모두 충족하는 모델을 고릅니다.
벤치마크 페이지, 커버리지 설명, 가격 화면을 활용해 벤더 마케팅 문구에 의존하지 않고 이해관계자에게 선택 이유를 제시합니다.
일관된 벤치마크 데이터와 공개된 채점 방법으로 오픈 웨이트 선두 모델과 최전선 폐쇄형 모델의 위치 변화를 꾸준히 관찰합니다.
실시간 순위, 제공자 신뢰성, 모달리티별 가격을 가져와 호스팅 API와 오픈 모델 중 선택을 지원합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | LLMBoard.ai | 378 | 0% | 직접 유입 33% | 무료 | 현재 도구 |
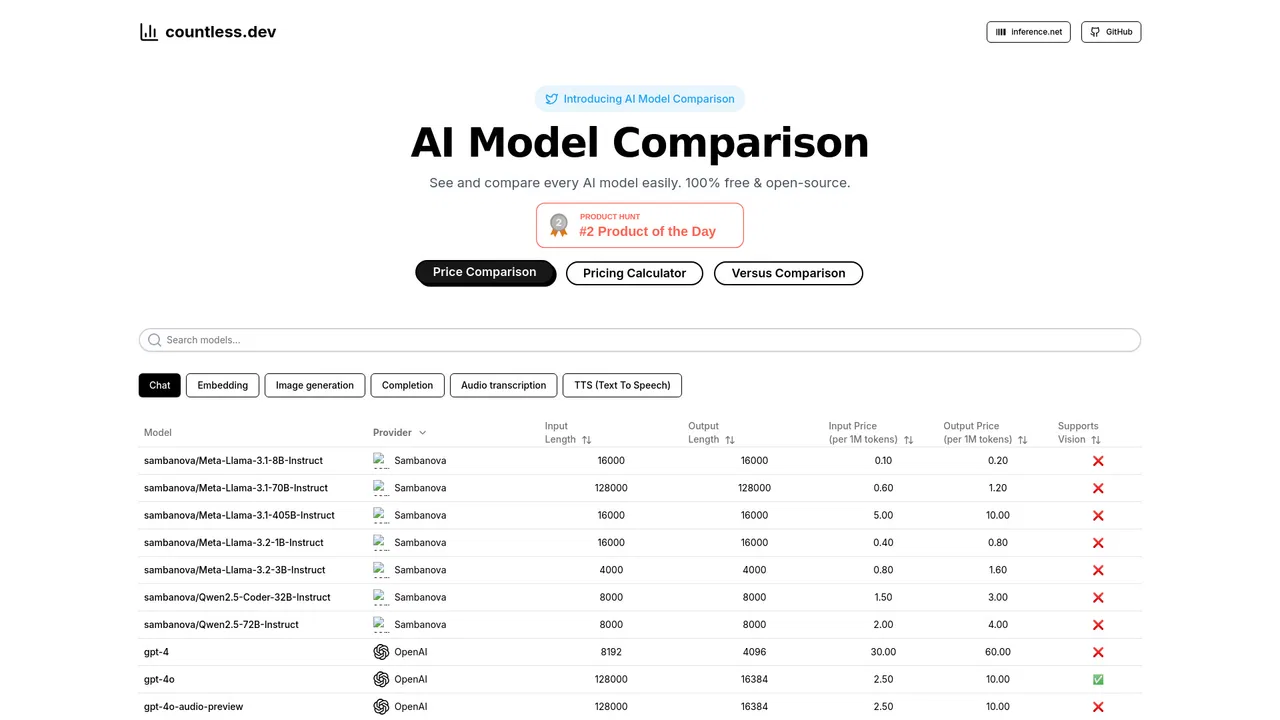
| 1 | Countless.dev | 787 | -45.8% | 직접 유입 40% | 무료 | vs Countless.dev |
| 2 | Models.dev | 20.05만 | -3.9% | 직접 유입 68% | 무료 | vs Models.dev |
| 3 | LLM Price Check | 8.26천 | -34.7% | 직접 유입 39% | 무료 | vs LLM Price Check |
| 4 | Surge AI | 24.51만 | +6.6% | 직접 유입 53% | 가격 문의 | vs Surge AI |
| 5 | thisorthis.ai | 2.25천 | -43.7% | 직접 유입 39% | 무료 | vs thisorthis.ai |
| 6 | ModelFusion | 119 | -88.2% | 직접 유입 43% | 무료+유료 | vs ModelFusion |
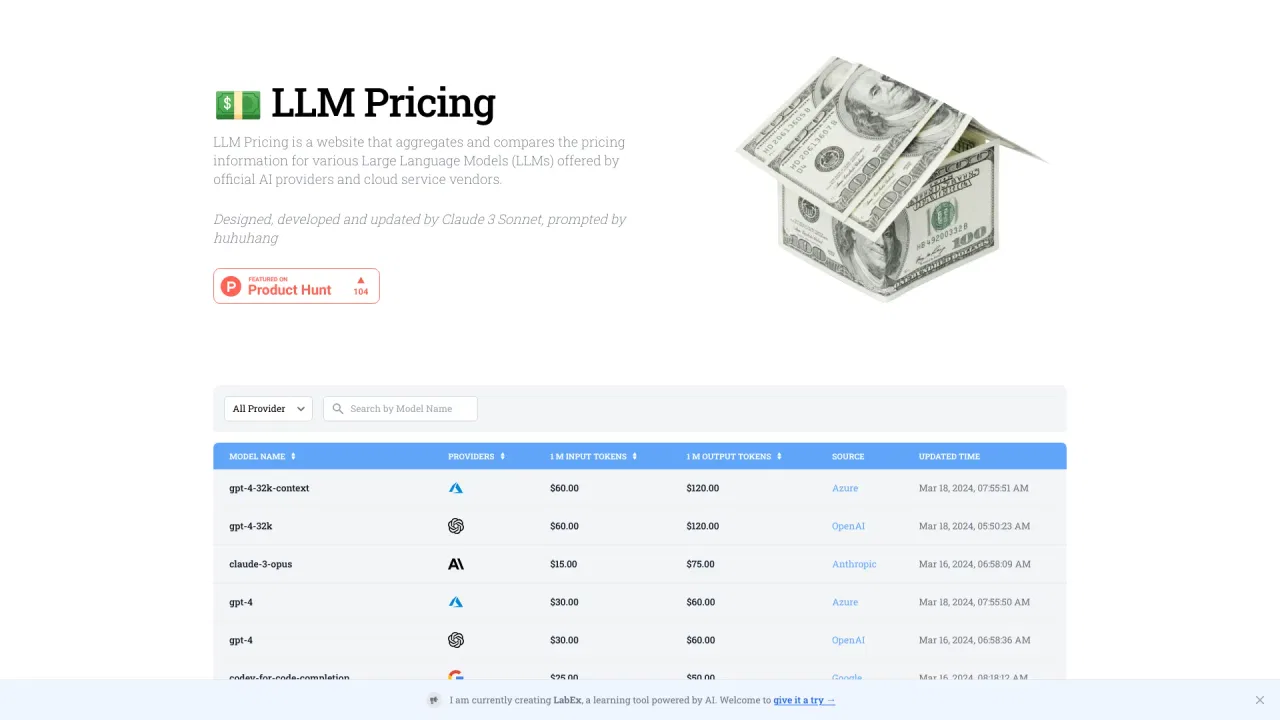
특화 강점주요 LLM API 토큰 가격을 한눈에 비교
매달 최고의 AI에 투표하고 실시간 순위를 확인하세요
무료 LLM 툴킷: 비용 계산기, 프롬프트, 모델 비교
모든 AI 모델이 같은 100개 질문에 어떻게 답했는지 담은 무료 아카이브

The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
특화 강점400개 이상 AI 모델의 토큰 비용 비교
AI 모델이 겨루고 사람의 투표가 최고의 디자인 결과물을 결정하는 크라우드소싱 아레나
AI 스택을 고르고 실제 업무로 검증하세요