Grátis / Código abertoCompare preços, recursos e capacidades de modelos de IA em um só lugar

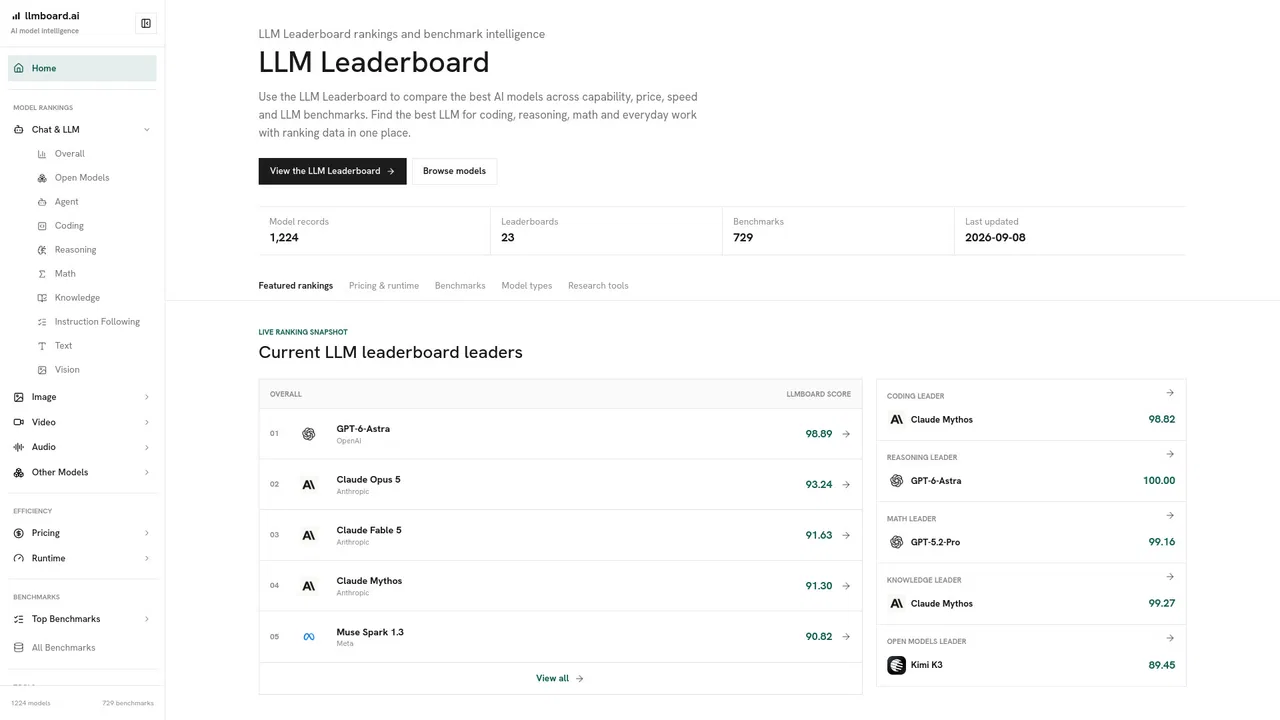
Leaderboard independente de LLM: capacidade, preço, velocidade e benchmarks

É a avaliação da nossa equipe editorial, de 0 a 5, e não uma média de notas de usuários. Os pontos de vista desta página são escritos por IA com base no que sabemos sobre o produto. Não são avaliações de clientes.
Segundo a telemetria do OpenAITools.app verificada em 2026-11-11, LLMBoard.ai (llmboard.ai) é uma plataforma de IA indexada em Large Language Models (LLMs) que gera 378 visitas mensais com variação de tráfego mês a mês de +378 (0%). Seu principal mercado geográfico é Estados Unidos (100% de participação no tráfego) e opera com modelo de preços Grátis. As principais alternativas concorrentes por volume mensal incluem Countless.dev (787 visitas/mês), Models.dev (200,45 mil visitas/mês), LLM Price Check (8,26 mil visitas/mês).
Melhor site para comparar benchmarks e preços de IAs.
Muito útil para o día a día.
Perspectivas sintetizadas por IA com base na inspeção do site, preços e referências da categoria — não são depoimentos reais de clientes.
Rankings separados para chat geral, código, raciocínio, matemática, conhecimento, seguimento de instruções, tarefas de agente, visão, imagem, vídeo, áudio e embeddings, para comparar conforme o trabalho real.
Avaliações individuais como GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval e MMMU-Pro, cada uma com ordem bruta e detalhes de cobertura.
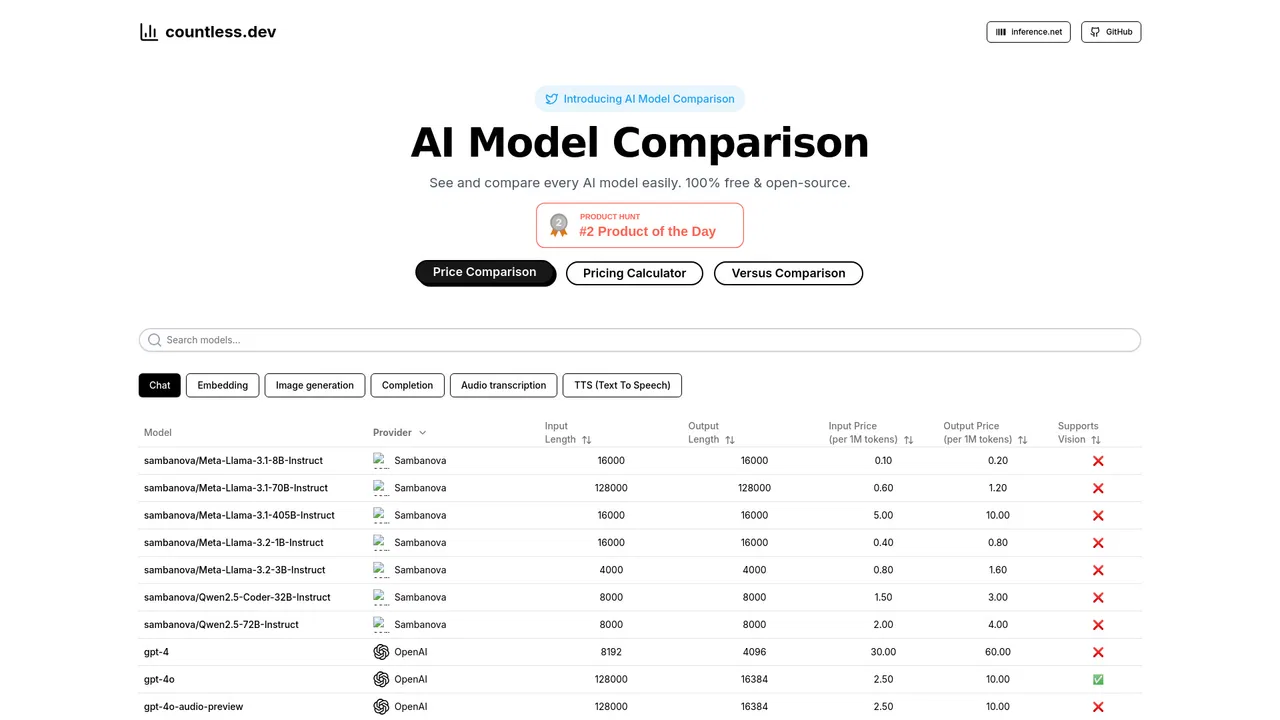
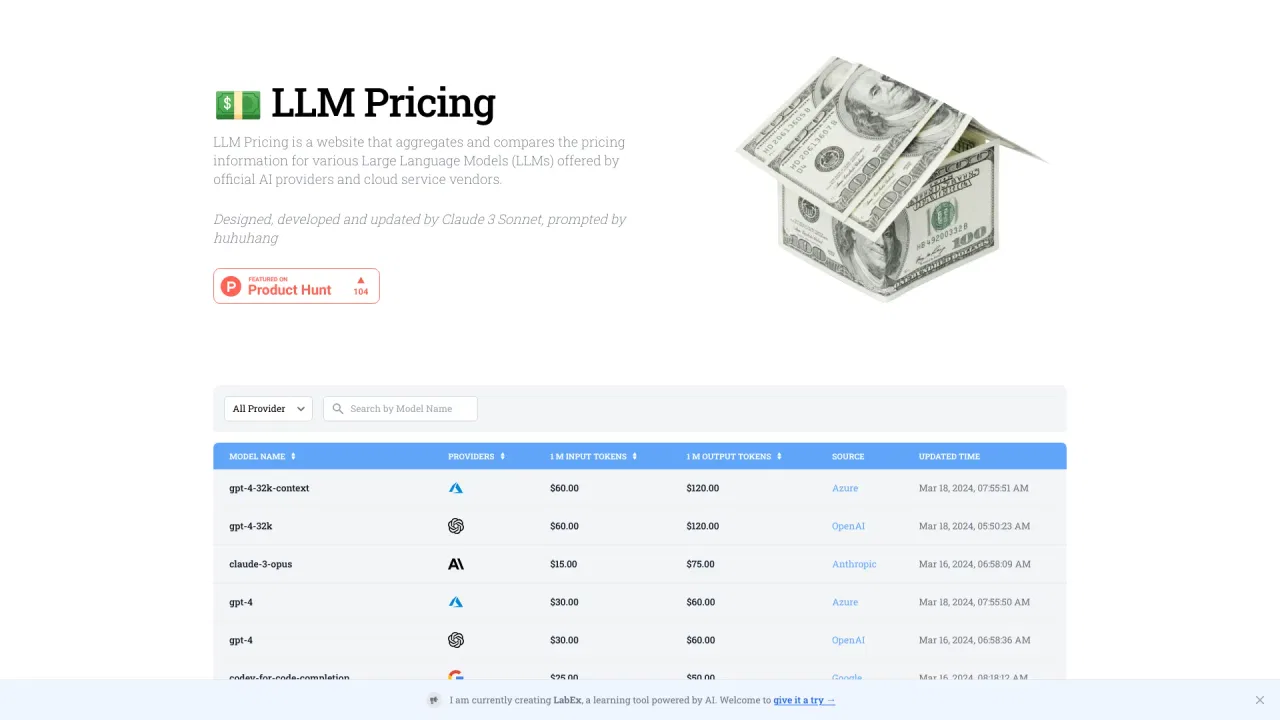
Visões de preço para tokens de chat, imagem, vídeo e áudio, além do eixo custo-capacidade para identificar onde o gasto extra realmente melhora a saída.
Rankings de velocidade de saída e latência junto a sinais de confiabilidade do provedor, cobrindo o lado operacional da escolha do modelo.
Catálogo filtrável por fornecedor, tipo, modalidade e preço, com regras publicadas de pontuação, cobertura e mapeamento de modelos para auditar os rankings.
O LLMBoard.ai responde a uma pergunta que muda a cada poucas semanas: qual modelo devemos realmente usar? Ele mantém um catálogo de modelos e resultados de benchmarks em atualização contínua e os apresenta como leaderboards organizados por tarefa: chat e LLM geral, agentes, código, raciocínio, matemática, conhecimento, seguimento de instruções, além de trilhas de visão, geração e edição de imagem, vídeo, texto para fala, fala para texto e embeddings. Cada classificação se apoia em benchmarks nomeados como GPQA, MMLU-Pro, AIME, SWE-Bench Verified, LiveCodeBench, MATH, HumanEval e MMMU-Pro.
O que o distingue de um ranking de número único é separar os sinais de propósito. As pontuações de capacidade ficam apartadas de preço, latência de execução e confiabilidade do provedor, então um modelo líder em um benchmark não é automaticamente apresentado como o mais econômico ou o mais estável em produção. Há páginas de preços dedicadas a tokens de chat, imagem, vídeo e áudio, além de visões de velocidade e confiabilidade. A seção de pontuação e dados documenta o mapeamento e as regras de pontuação, e cada página de benchmark mostra a ordem bruta e a cobertura para que você avalie a evidência.
É voltado a equipes de engenharia, product managers e pesquisadores que avaliam modelos para uma carga de trabalho específica, além de quem acompanha a comparação entre modelos abertos e proprietários de fronteira. É um recurso de informação e comparação: não hospeda os modelos, e os resultados devem ser tratados como ponto de partida para seus próprios testes.
Filtre o diretório e compare líderes em código ou raciocínio com preço por token e vazão para escolher um modelo que atenda qualidade e orçamento.
Use páginas de benchmark, notas de cobertura e visões de preço para justificar a escolha aos stakeholders em vez de depender do marketing do fornecedor.
Observe líderes de pesos abertos frente a modelos proprietários de fronteira com dados de benchmark consistentes e o método de pontuação publicado.
Puxe rankings ao vivo, confiabilidade de provedores e preços por modalidade para embasar recomendações entre APIs hospedadas e modelos abertos.
Comparação de telemetria lado a lado de ferramentas de IA concorrentes na mesma categoria principal
| Classificação | Ferramenta de IA | Visitas mensais | Crescimento mensal | Participação do tráfego direto | Preços | Comparação direta |
|---|---|---|---|---|---|---|
| ● | LLMBoard.ai | 378 | 0% | 33% direto | Grátis | Atual |
| 1 | Countless.dev | 787 | -45,8% | 40% direto | Grátis | vs Countless.dev |
| 2 | Models.dev | 200,45 mil | -3,9% | 68% direto | Grátis | vs Models.dev |
| 3 | LLM Price Check | 8,26 mil | -34,7% | 39% direto | Grátis | vs LLM Price Check |
| 4 | Surge AI | 245,14 mil | +6,6% | 53% direto | Preço sob consulta | vs Surge AI |
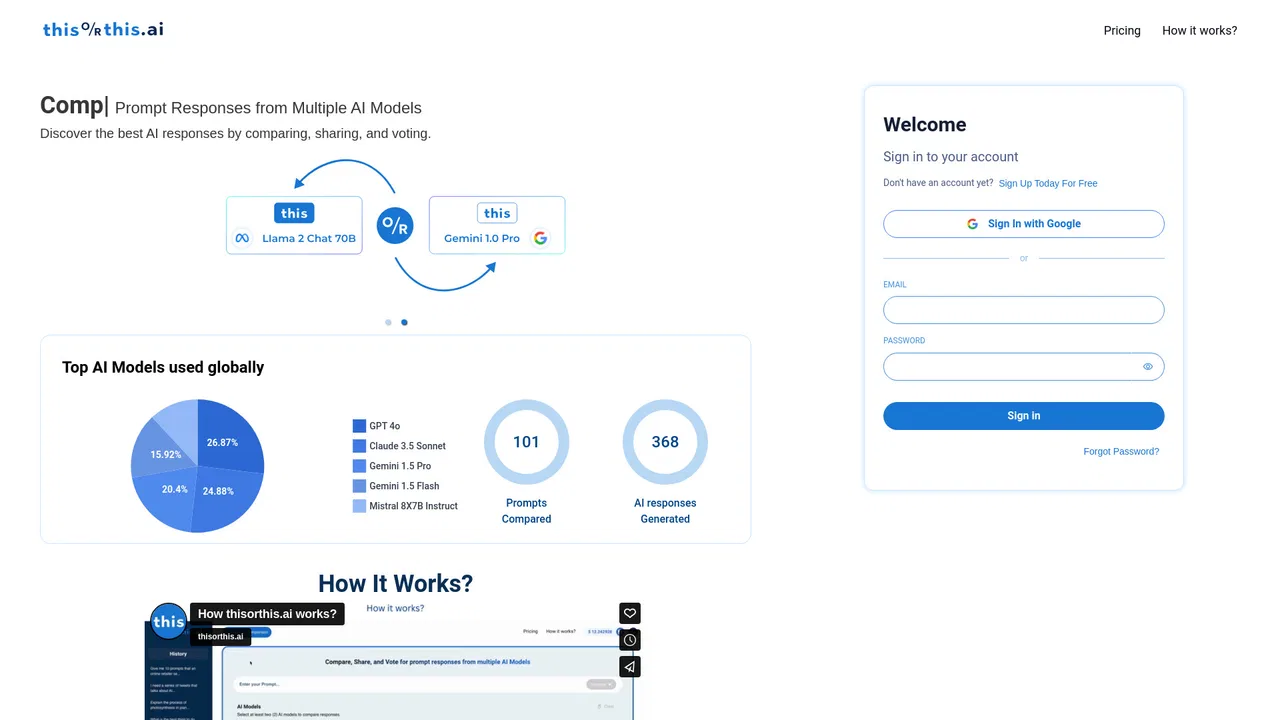
| 5 | thisorthis.ai | 2,25 mil | -43,7% | 39% direto | Grátis | vs thisorthis.ai |
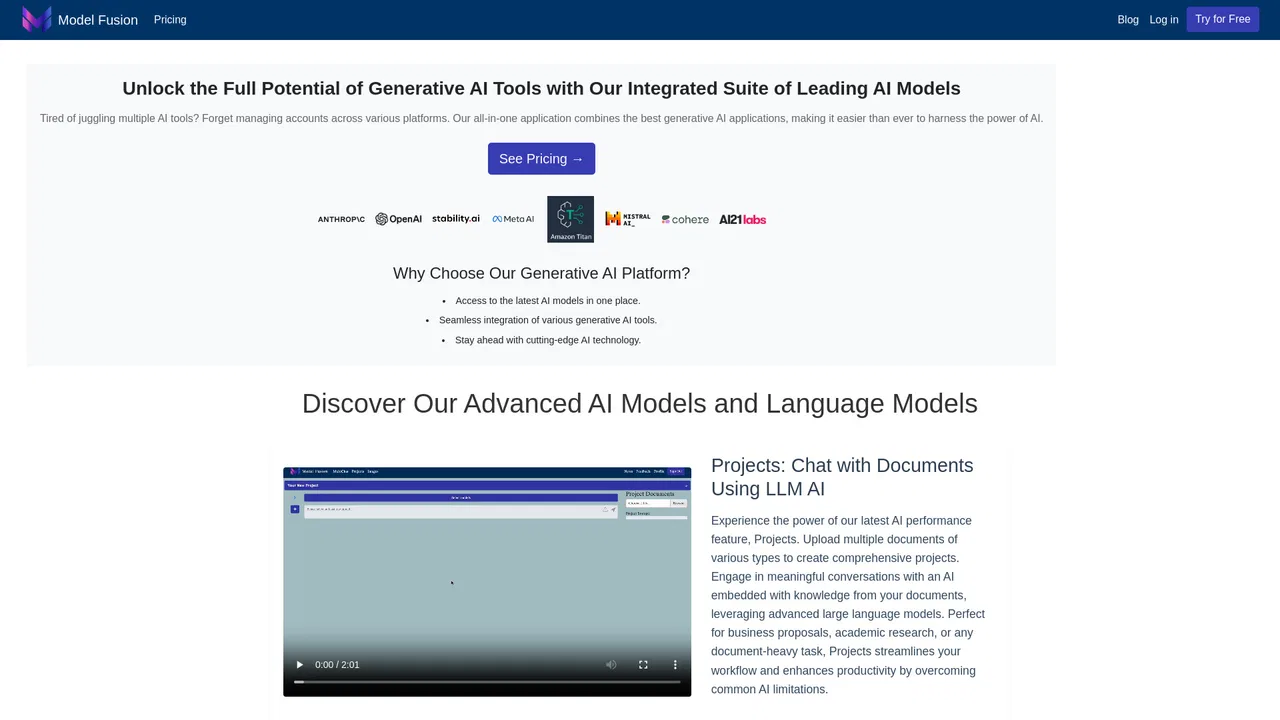
| 6 | ModelFusion | 119 | -88,2% | 43% direto | Freemium | vs ModelFusion |
Grátis / Código abertoCompare preços, recursos e capacidades de modelos de IA em um só lugar

Grátis / Código abertoBanco de dados open source de modelos de IA, preços e capacidades

EspecializadoCompare os preços por token das principais APIs de LLM

Dados humanos especializados e avaliação para treinar IA de fronteira

Vote na melhor IA a cada mês e acompanhe o ranking ao vivo

Kit LLM gratuito: calculadoras de custo, prompts e comparação de modelos

Um arquivo gratuito de como cada modelo de IA respondeu às mesmas 100 perguntas

The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
EspecializadoCompare o custo por token de mais de 400 modelos de IA

Arena colaborativa onde modelos de IA competem e as pessoas elegem o melhor design

Escolha seu stack de IA e comprove no trabalho real

As principais notícias de IA e como aplicá-las, em cinco minutos por dia