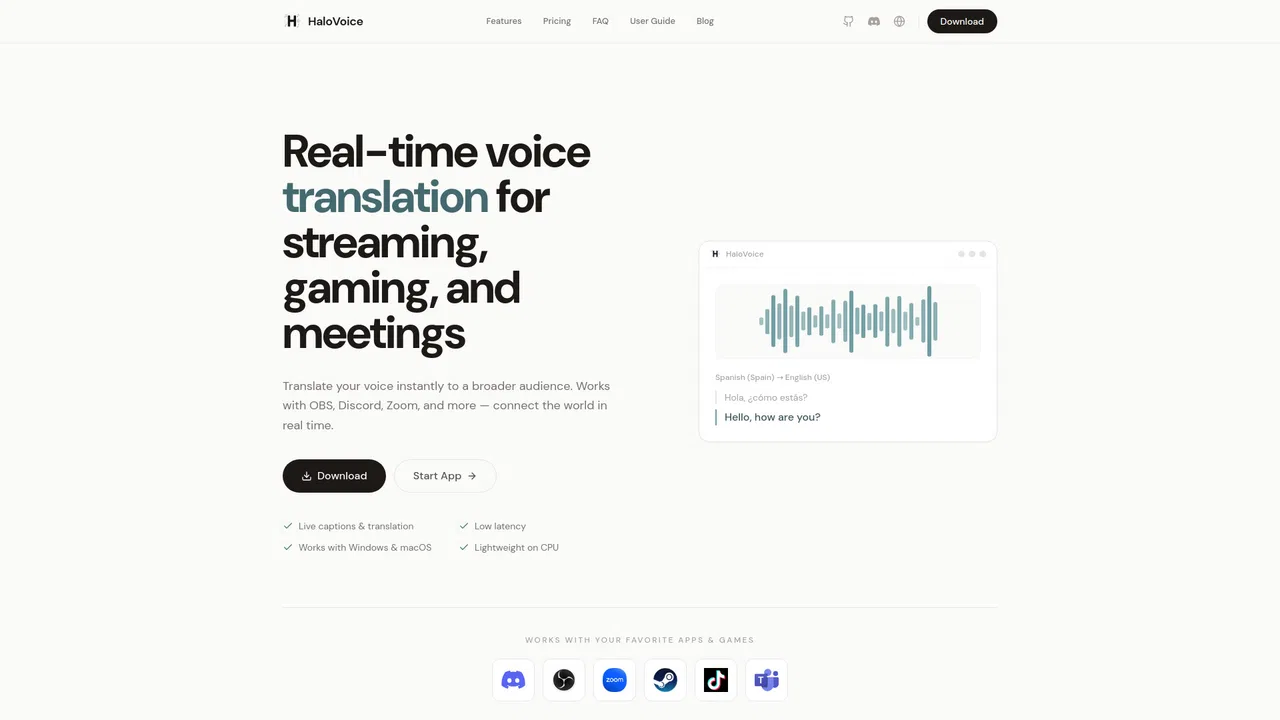
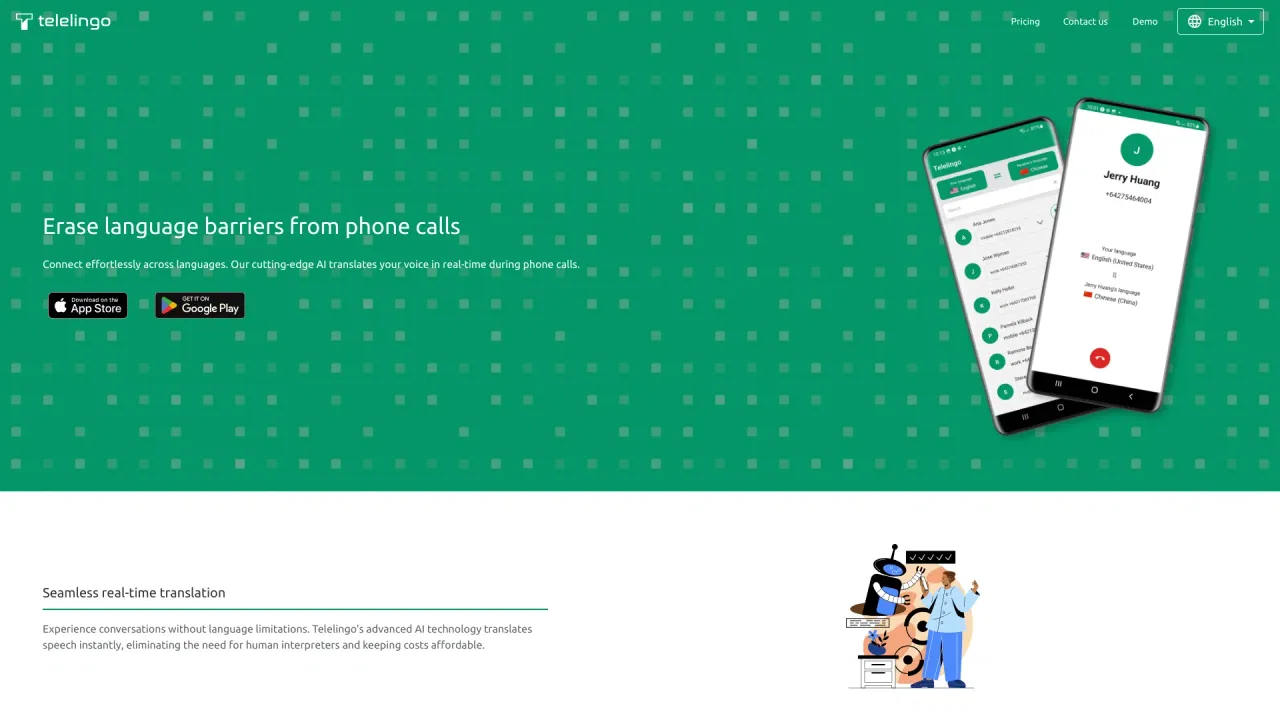
A Palabra.ai foca na tradução falada ao vivo, não em texto escrito. O fluxo é contínuo: o áudio entra, um modelo de reconhecimento gera texto, um modelo de tradução converte para o idioma de destino e um modelo de síntese vocaliza o resultado, tudo em segmentos curtos para não haver pausas longas a cada frase — normalmente a saída chega em menos de um segundo. Um falante pode emitir em vários idiomas ao mesmo tempo, e a Palabra desenvolve seus próprios modelos de reconhecimento, tradução e geração de voz em vez de revender mecanismos de terceiros.
A plataforma cobre três formatos principais. Os agentes de tradução entram numa chamada de Zoom, Google Meet ou Microsoft Teams como participante, então ninguém precisa instalar plugins. O modo de transmissão se conecta a OBS, Castr, YouTube Live e outros pipelines RTMP/SRT para gerar áudio e legendas traduzidos. Em eventos presenciais, os participantes escaneiam um QR code, escolhem o idioma e ouvem no próprio celular, o que dispensa fones, cabines e intérpretes reservados com meses de antecedência. Glossários personalizados preservam nomes e termos de produto, e a clonagem de voz com controle de sotaque reproduz a voz do próprio falante em cada idioma.
Por baixo há APIs de produção: voz para voz a US$ 0,04 por minuto, fala para texto a US$ 0,002 por minuto de áudio e texto para fala cobrado por caractere, com 35 ms até o primeiro áudio. Uma única chave serve para as três funções, as sessões usam WebSocket e a voz para voz também aceita WebRTC, com implantação regional, nuvem privada ou on-premises. A Palabra afirma que áudio e texto são processados em tempo real, nunca armazenados nem usados para treino, e a infraestrutura tem certificação ISO/IEC 27001, com GDPR, SOC 2 Type II e opção HIPAA no plano Enterprise.