免费
加载中…
这是编辑给出的评估,满分 5 分,不是用户打分的平均值。 本页的各方观点由 AI 根据产品信息归纳,不是真实用户的评价。
根据 OpenAITools.app 于 2026-11-11 核对的流量数据,LLMBoard.ai(llmboard.ai)是一个收录在 Large Language Models (LLMs) 下的 AI 平台,月访问量为 378,月度环比流量变化为 +378(0%)。其主要地理市场为美国(100% 流量份额),采用免费定价模式。按月流量计算的主要竞争替代方案包括 Countless.dev(787 次访问/月),Models.dev(20.05万次访问/月),LLM Price Check(8255 次访问/月)。
查大模型跑分和token价格的神器,每次选型必看。
更新很及时,开源模型收录得很全。
免登录无广告,良心排行榜。
看延迟和各家API定价太方便了。
以下短评基于实时网页探查、定价机制与同类产品基准由 AI 综合模拟生成,旨在呈现不同使用场景下的常见槽点与亮点,非实名真实用户评价。
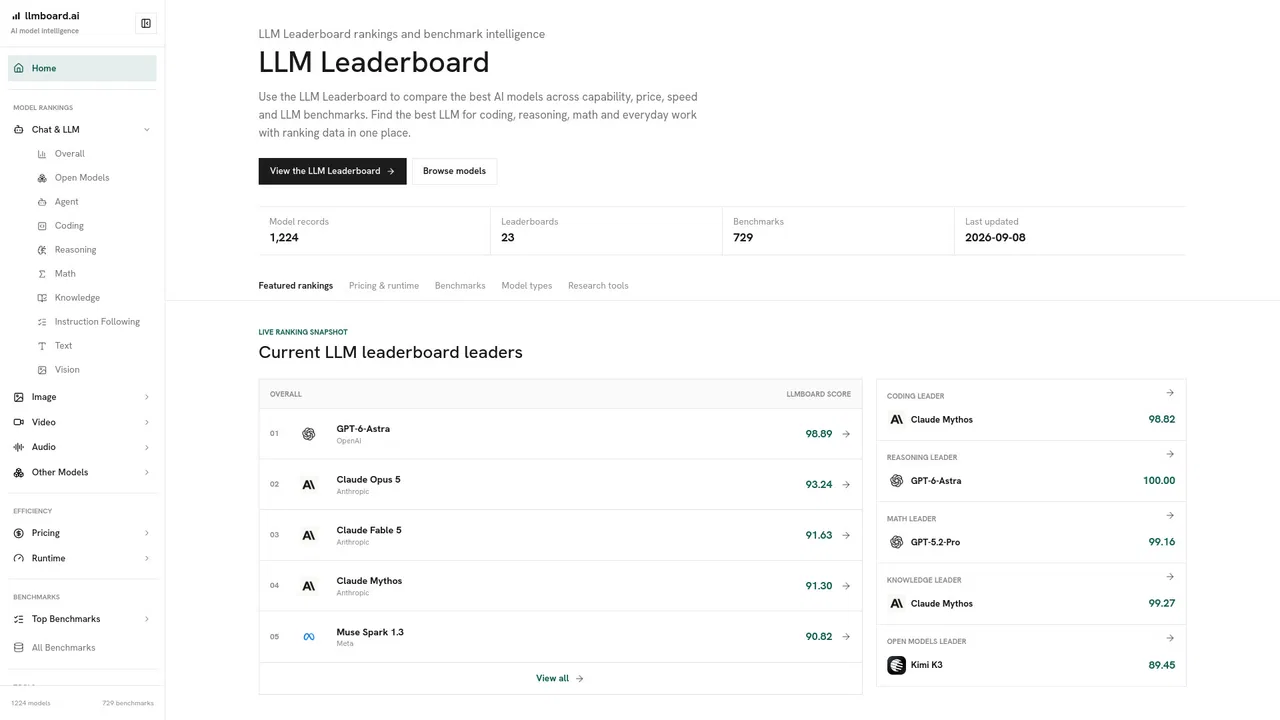
综合对话、编程、推理、数学、知识、指令跟随、智能体任务以及视觉、图像、视频、音频、嵌入各有独立榜单,方便按实际工作场景比较。
包含 GPQA、MMLU-Pro、AIME、SWE-Bench Verified、LiveCodeBench、MATH、HumanEval、MMMU-Pro 等单项评测,并展示原始排序与覆盖范围。
对话 Token、图像、视频与音频各有价格视图,并结合成本与能力的关系,帮助判断额外花费是否真的换来更好的输出。
提供输出速度与延迟排行以及提供商可靠性信号,覆盖模型选型中偏运营层面的考量,而不只是基准分数。
可按厂商、类型、模态与价格筛选的目录,并公开评分、覆盖范围与模型映射规则,使排名可被核查。
LLMBoard.ai 回答的是一个每隔几周就会变化的问题:我们到底该用哪个模型?它维护着持续更新的模型记录与基准测试结果,并以任务为单位组织排行榜——综合对话、智能体任务、编程、推理、数学、知识、指令跟随,以及视觉、图像生成与编辑、视频、文本转语音、语音转文本与嵌入等独立榜单。每个排名背后都有具名基准支撑,如 GPQA、MMLU-Pro、AIME、SWE-Bench Verified、LiveCodeBench、MATH、HumanEval 与 MMMU-Pro。
它与单一分数排名的区别在于刻意拆分信号。能力评分与价格、运行时延迟、提供商可靠性分开呈现,因此某个模型即使位居基准榜首,也不会被默认当作最划算或最稳定可用的选择。站点为对话 Token、图像、视频与音频分别设有价格页面,并配有速度与可靠性视图。评分与数据板块公开了模型映射与计分规则,每个基准页面展示原始排序与覆盖范围,方便你判断某个名次背后的证据强度。
目标用户是为特定工作负载评估模型的工程团队、产品经理与研究人员,也包括关注开源模型与前沿闭源模型对比的读者。它是一个信息与比较资源,本身不托管模型,其结果应被视为自主测试的起点。
在目录中筛选,把编程或推理榜首模型与 Token 价格、吞吐量对照,选出同时满足质量与预算的模型。
用基准页面、覆盖说明与价格视图向相关方说明模型选择理由,而不是依赖厂商的宣传口径。
借助一致的基准数据与公开计分方法,长期观察开源权重领先模型相对前沿闭源模型的位置变化。
调取实时排名、提供商可靠性与各模态价格,为客户选择托管 API 还是开源模型提供依据。
同一分类下同类 AI 工具的流量并排对比
| 排名 | AI 工具 | 月访问量 | 月度环比增长 | 直接流量占比 | 定价 | 头对头 |
|---|---|---|---|---|---|---|
| ● | LLMBoard.ai | 378 | 0% | 33% 直接流量 | 免费 | 当前产品 |
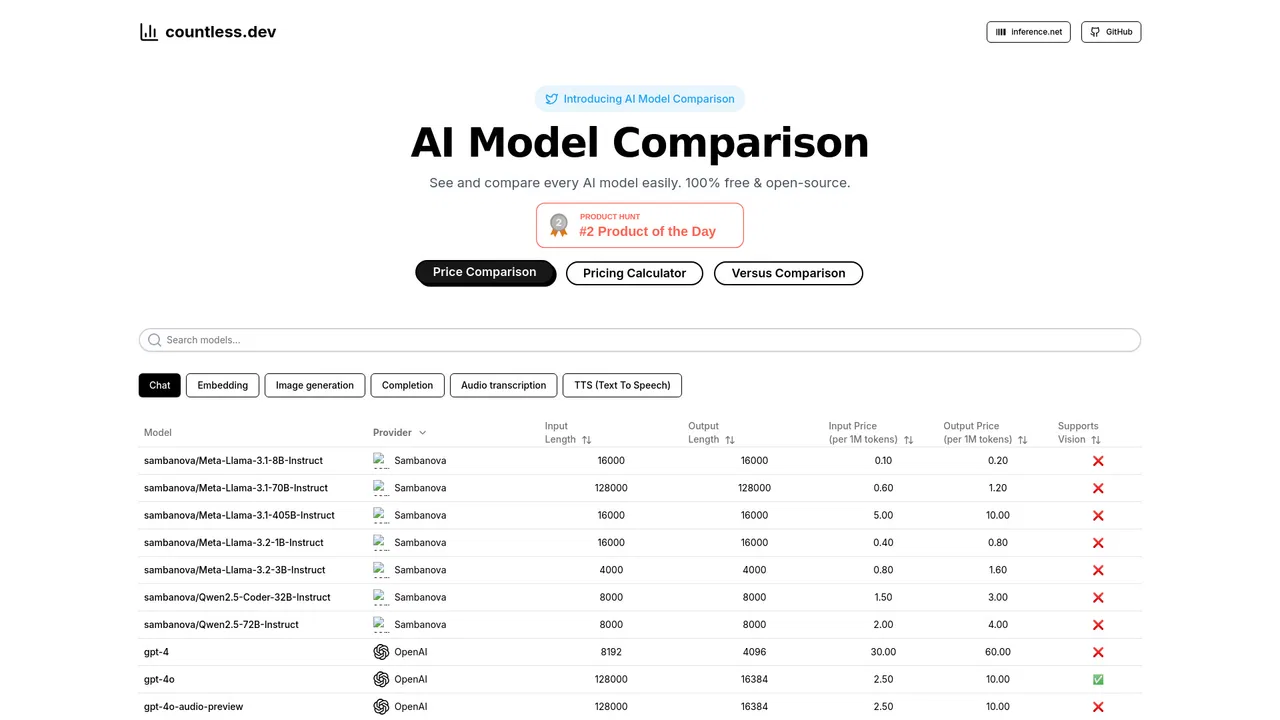
| 1 | Countless.dev | 787 | -45.8% | 40% 直接流量 | 免费 | 对比 Countless.dev |
| 2 | Models.dev | 20.05万 | -3.9% | 68% 直接流量 | 免费 | 对比 Models.dev |
| 3 | LLM Price Check | 8255 | -34.7% | 39% 直接流量 | 免费 | 对比 LLM Price Check |
| 4 | Surge AI | 24.51万 | +6.6% | 53% 直接流量 | 定价请咨询 | 对比 Surge AI |
| 5 | thisorthis.ai | 2250 | -43.7% | 39% 直接流量 | 免费 | 对比 thisorthis.ai |
| 6 | ModelFusion | 119 | -88.2% | 43% 直接流量 | 免费增值 | 对比 ModelFusion |
专项更强一站式对比各大厂商的 LLM API 词元价格
每月投出你心中的最佳 AI,实时关注排行榜
免费 LLM 工具箱:成本计算、提示词与模型对比
免费档案库:每个 AI 模型如何回答同一百个问题

The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
The Frontier Model Forum is a non-profit industry body founded by Anthropic, Google, Microsoft and OpenAI to advance the safety and security of frontier AI models through best practices, research funding and information sharing.
专项更强比较 400+ AI 模型的 token 成本
让 AI 模型同台竞技、由真人投票选出最佳设计产出的众包竞技场
选定你的 AI 组合,再用真实工作来验证