235.8万/月
会学习你编码品味的 AI 编程智能体
免费增值,定价请咨询
这是编辑给出的评估,满分 5 分,不是用户打分的平均值。 本页的各方观点由 AI 根据产品信息归纳,不是真实用户的评价。
根据 OpenAITools.app 于 2026-11-11 核对的流量数据,RunLLM(runllm.com)是一个收录在 AI Agent 下的 AI 平台,月访问量为 182,月度环比流量变化为 -1761(-90.6%)。其主要地理市场为全球(— 流量份额),采用免费试用,定价请咨询定价模式。按月流量计算的主要竞争替代方案包括 Command Code(235.82万次访问/月),Struct(74 次访问/月),Middleware(3.6万次访问/月)。
值班救星!再也不怕半夜被报警吵醒了。
自动根因分析比自己翻日志快多了。
SRE领域的降维打击,太强了。
企业版定价有点高,小团队有点肉疼。
以下短评基于实时网页探查、定价机制与同类产品基准由 AI 综合模拟生成,旨在呈现不同使用场景下的常见槽点与亮点,非实名真实用户评价。
在任何告警触发之前,Herald 即构建涵盖可观测性、代码库、CI/CD、文档和依赖关系的上下文图谱,从而理解什么是正常状态。
无需调整阈值:Herald 为每条数据流构建定制的异常检测模型,并在客户察觉之前发现经过验证的问题。
智能体针对正确的数据源同时评估多个假设,并在几分钟内给出根因分析,无需运行手册。
对已知问题的根因分析准确率为 100%,对新型事件超过 70%,并从每次调查中学习,绝不重蹈覆辙。
扫描你的代码库,发现你使用的工具,并在几分钟内完成自身配置,快速适配你的技术栈。
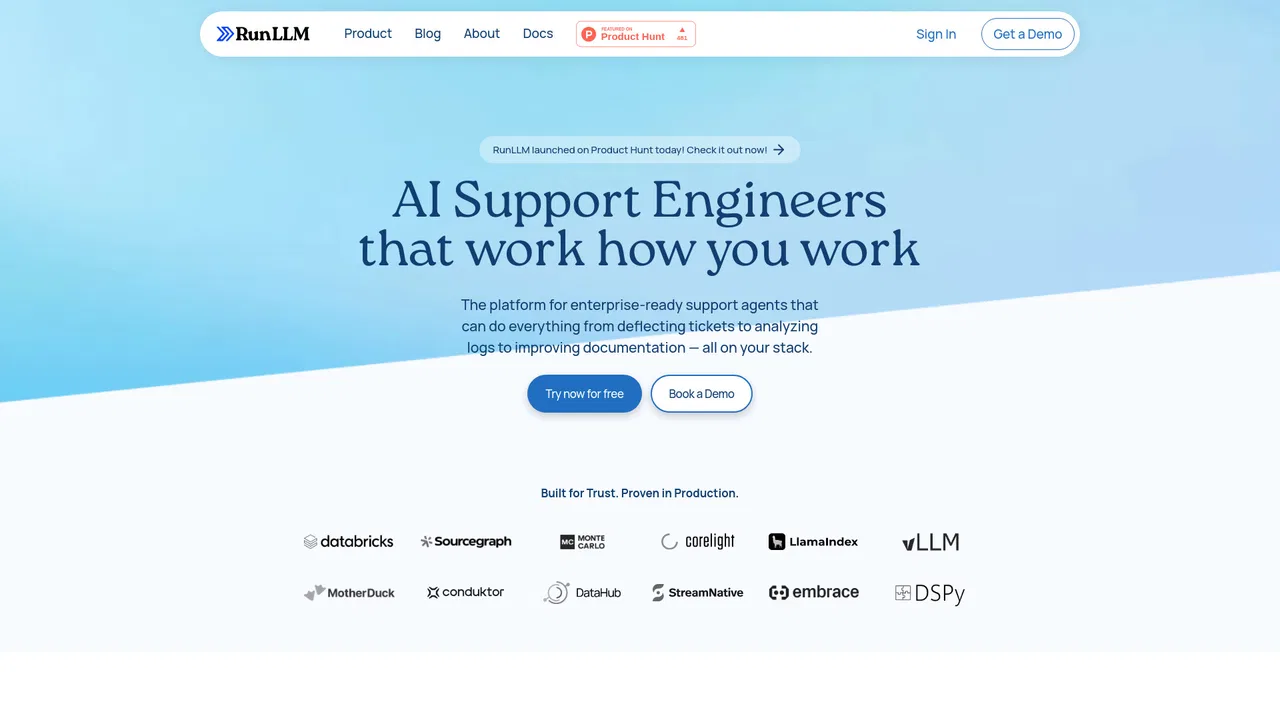
RunLLM 现以 Herald 品牌运营,已从企业技术支持助手演进为它所称的 AI SRE:一个在工程师被呼叫之前就发现生产问题的智能体。其核心观点是传统可观测性已经失效——你必须为每条数据流埋点、调整告警阈值、为每种故障模式编写运行手册,而任何没人记录过的问题都会成为盲区。
Herald 采取不同方式。在任何告警触发之前,它会构建一张涵盖可观测性、代码库、CI/CD、文档和依赖关系的上下文图谱,从而了解什么是正常状态。随后它为每条数据流构建定制的异常检测模型——无需设置阈值——并在客户察觉之前发现经过验证的信号。当出现异常时,智能体会针对正确的数据源同时评估多个假设,并在几分钟内交出根因分析,无需运行手册。
公司表示,在某家全球最大的 B2B2C 平台上,它对已知问题的根因分析准确率为 100%,对新型事件超过 70%,并指出智能体会从每次调查中学习,绝不重犯同样的错误。Herald 由加州大学伯克利分校 RISELab 的博士和教授创立,融合了 AI、LLM、数据系统与可扩展基础设施方面的专长。
在异常错误率和延迟尖峰越过告警阈值、触达客户之前就发现它们。
几分钟内获得 AI 生成的根因分析,而不是手动关联日志、数据接入和告警管道。
降低对专有知识和尚且脆弱、会随技术栈演进过时的运行手册的依赖。
调查那些没人记录过、其他智能体因缺少运行手册而束手无策的新型故障。
同一分类下同类 AI 工具的流量并排对比
| 排名 | AI 工具 | 月访问量 | 月度环比增长 | 直接流量占比 | 定价 | 头对头 |
|---|---|---|---|---|---|---|
| ● | RunLLM | 182 | -90.6% | 39% 直接流量 | 免费试用,定价请咨询 | 当前产品 |
| 1 | Command Code | 235.82万 | -12.1% | 74% 直接流量 | 免费增值,定价请咨询 | 对比 Command Code |
| 2 | Struct | 74 | -95.2% | 39% 直接流量 | 免费增值,免费 | 对比 Struct |
| 3 | Middleware | 3.6万 | -12.3% | 25% 直接流量 | 免费增值,定价请咨询 | 对比 Middleware |
| 4 | Arize AI | 24.9万 | +3.2% | 43% 直接流量 | 付费,定价请咨询 | 对比 Arize AI |
| 5 | KaneAI | 90.13万 | +13.2% | 23% 直接流量 | 免费增值,付费,定价请咨询 | 对比 KaneAI |
| 6 | Superlog | 1313 | -75.2% | 39% 直接流量 | 免费增值,付费,定价请咨询,免费 | 对比 Superlog |
会学习你编码品味的 AI 编程智能体
配备可自动修复问题的 AI SRE 代理的全栈可观测性平台

免费 / 开源面向生产级 AI 的智能体可观测性、评估与持续改进平台
负责构建、发布与运维云环境的 AI 队友
覆盖整个软件开发周期的智能体编排平台
面向生产软件工程的协作式 AI 智能体